Introducción
El objetivo de este estudio es comparar la capacidad predictiva de los modelos ARIMA/SARIMA frente a Time-GPT, utilizando los datos históricos de las primas netas cobradas en el mercado asegurador venezolano.
Tradicionalmente, los modelos de series de tiempo como ARIMA y SARIMA han sido ampliamente utilizados para realizar pronósticos en distintos dominios. Estos enfoques estadísticos son efectivos cuando los datos presentan patrones claros de tendencia o estacionalidad; sin embargo, requieren la validación de supuestos y pueden mostrar limitaciones frente a patrones complejos o no lineales.
En este análisis, no profundizaremos en el ajuste de los modelos, la validación de supuestos estadísticos ni en el análisis de los residuos; nos centraremos en cómo se desempeñan los modelos a la hora de generar pronósticos.
En los últimos años, han surgido alternativas basadas en Transformadores Generativos Preentrenados, como Time-GPT, desarrollado por Nixtla. Este modelo de lenguaje grande está optimizado con una extensa base de series temporales, lo que le permite generar pronósticos precisos sin necesidad de ajustar manualmente los parámetros para cada serie individual.
Datos del Estudio
Para este análisis se utilizaron los datos históricos de las primas netas cobradas de ocho compañías aseguradoras venezolanas seleccionadas aleatoriamente, con frecuencia mensual, desde septiembre de 2018 hasta agosto de 2025. La información fue extraída de las cifras mensuales publicadas por la Superintendencia de la Actividad Aseguradora (SUDEASEG).
Los datos originales estaban inicialmente expresados en bolívares y fueron convertidos a dólares estadounidenses utilizando la tasa de cambio mediana mensual, calculada a través de las datos diarios publicados por el Banco Central de Venezuela (BCV).
La elección de la mediana como medida de tendencia se debe a su robustez frente a valores atípicos y a la alta volatilidad del mercado cambiario venezolano, lo que permite obtener una representación más confiable y menos afectada por fluctuaciones extremas.
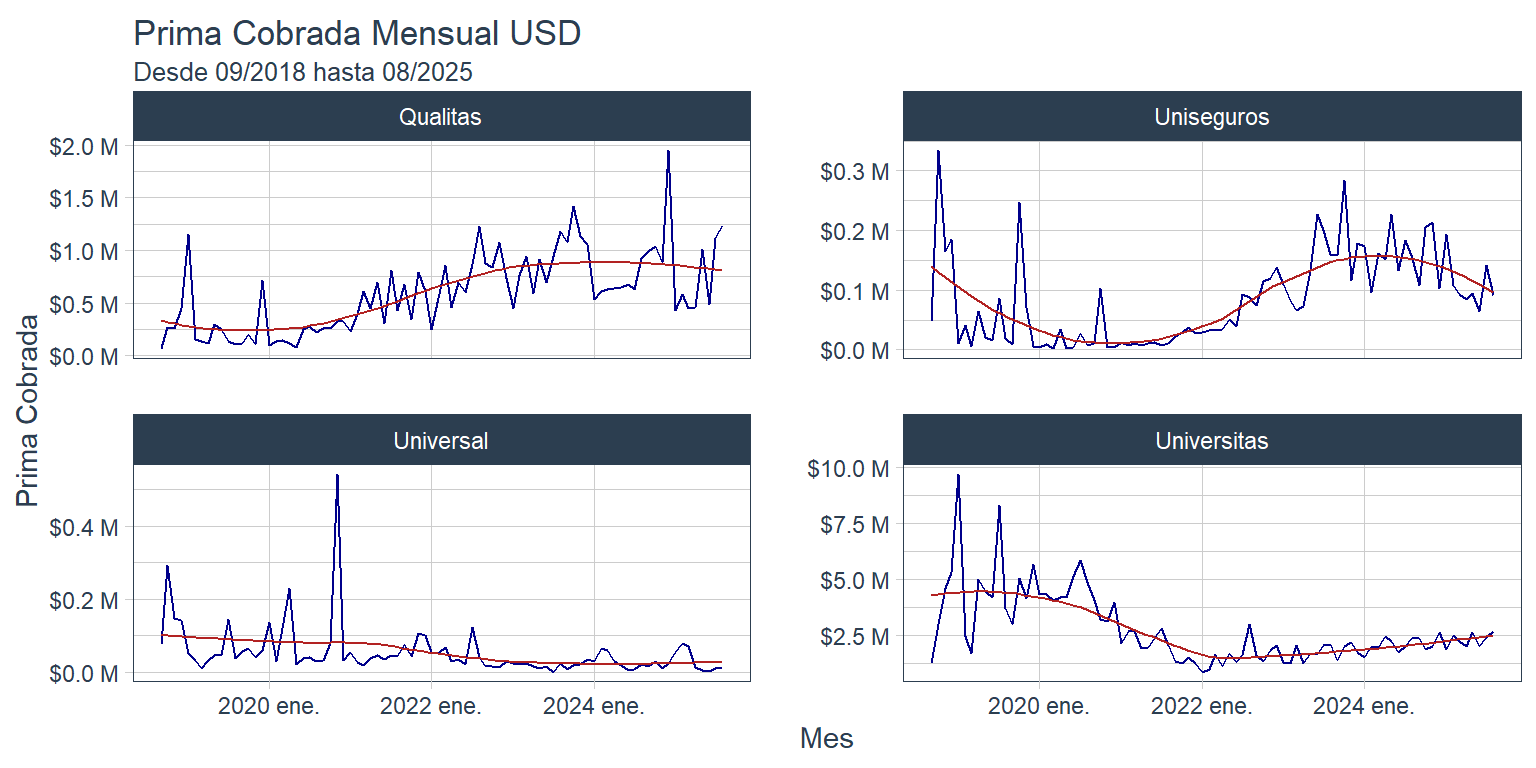
A continuación, se presenta el histórico de cada una de las series. Es importante destacar que cada gráfico utiliza una escala distinta en el eje Y, lo que facilita apreciar las particularidades y el comportamiento propio de cada aseguradora:
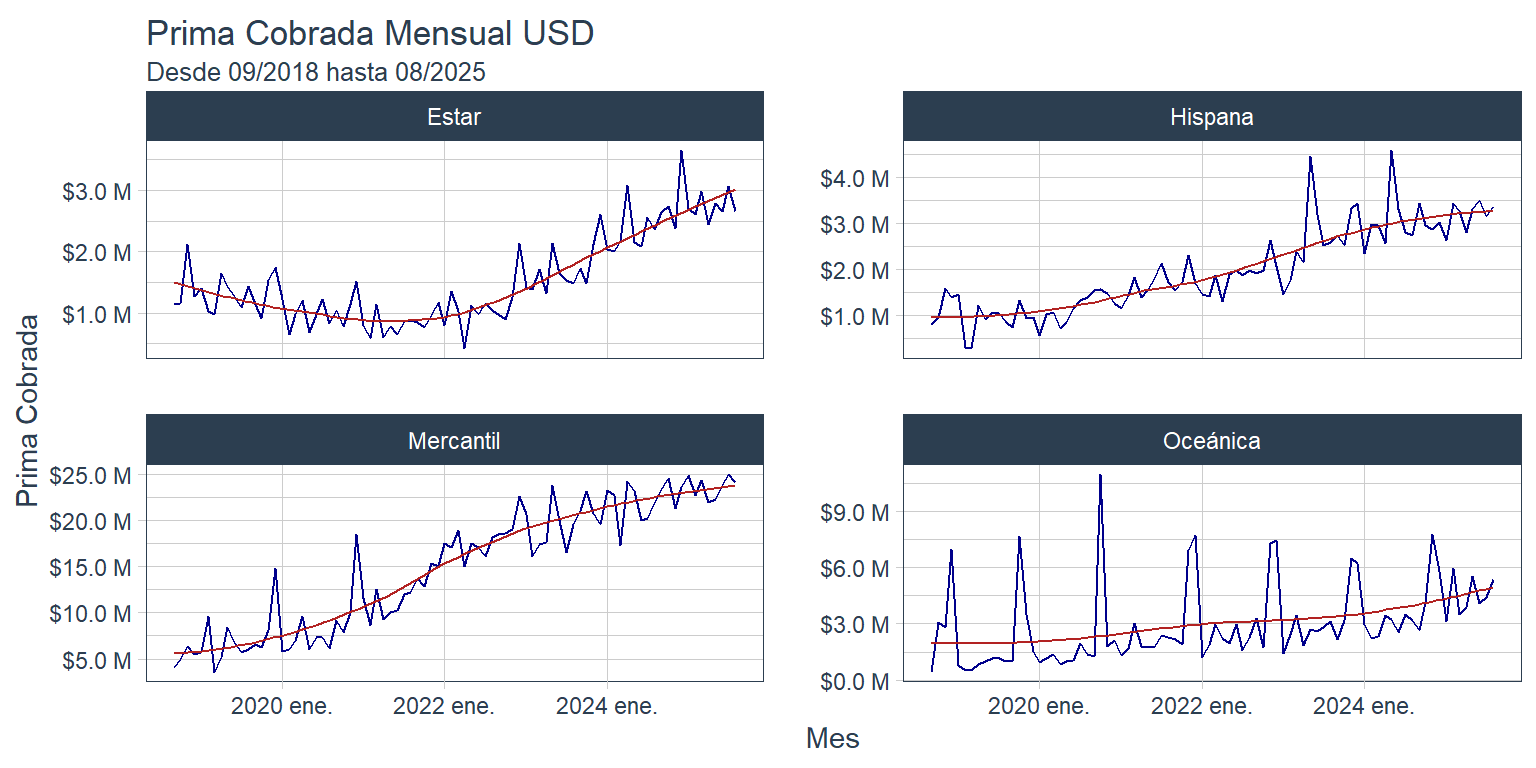
Se observa que las aseguradoras Estar, Hispana y Mercantil muestran una tendencia creciente. Mercantil destaca por alcanzar montos muy superiores a los del resto, mientras que Estar e Hispana crecen de manera moderada pero sostenida.
Oceánica presenta un patrón particular, ya que combina crecimiento con picos muy marcados en ciertos meses. Esto sugiere un fuerte componente estacional asociado a pólizas de gran prima.
Por otro lado, Qualitas y Uniseguros muestran trayectorias más inestables. Qualitas experimenta un crecimiento con alta volatilidad, mientras que Uniseguros se mantiene en niveles bajos y con un comportamiento errático.
Finalmente, Universal y Universitas reflejan una clara contracción. Universal prácticamente desaparece en términos de prima, mientras que Universitas cae abruptamente después de 2019 y se mantiene en valores bajos, aunque con una ligera recuperación reciente.
En conjunto, las series revelan un mercado desigual: algunas compañías crecen con fuerza, otras muestran alta volatilidad y varias han perdido participación significativa.
Backtesting
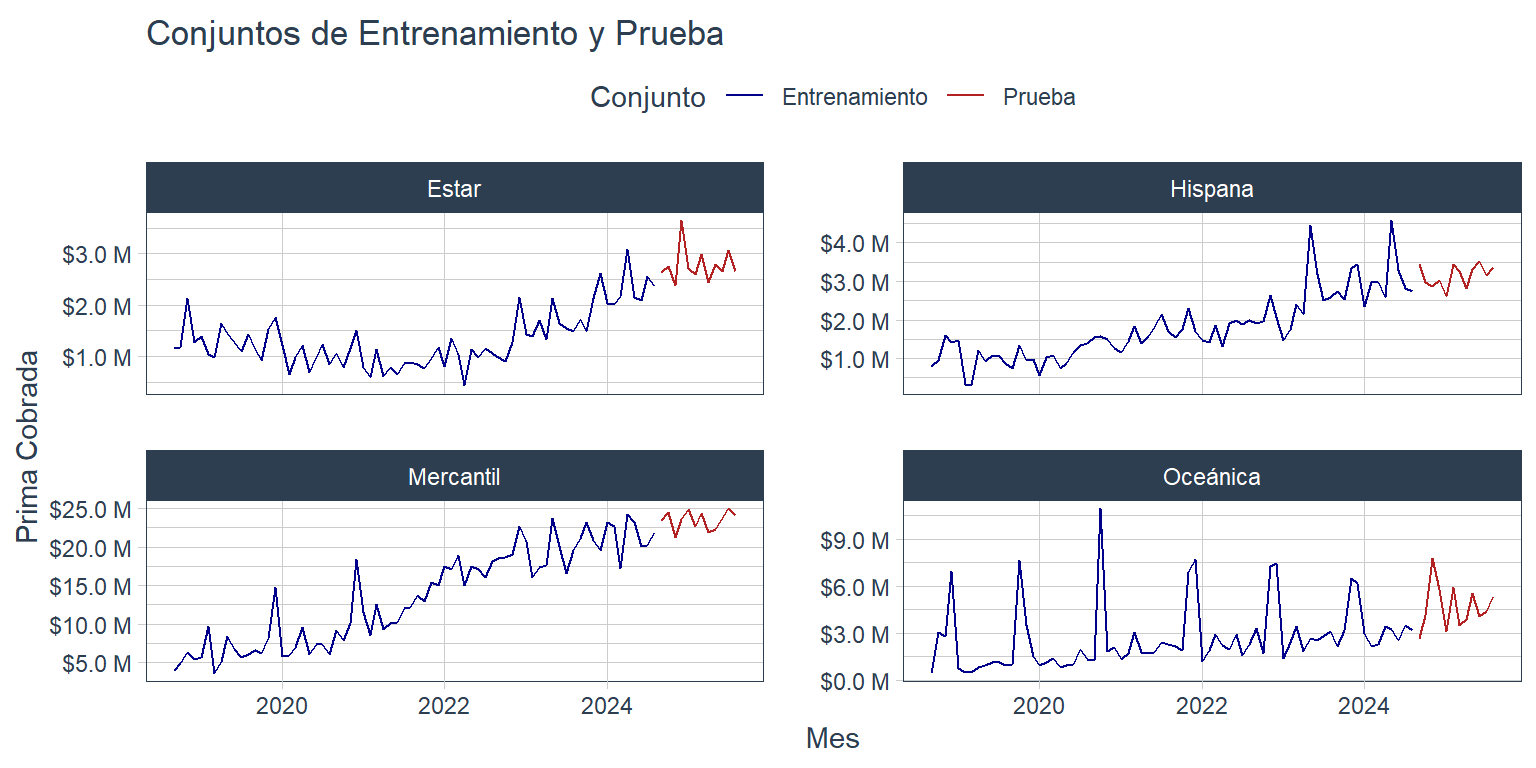
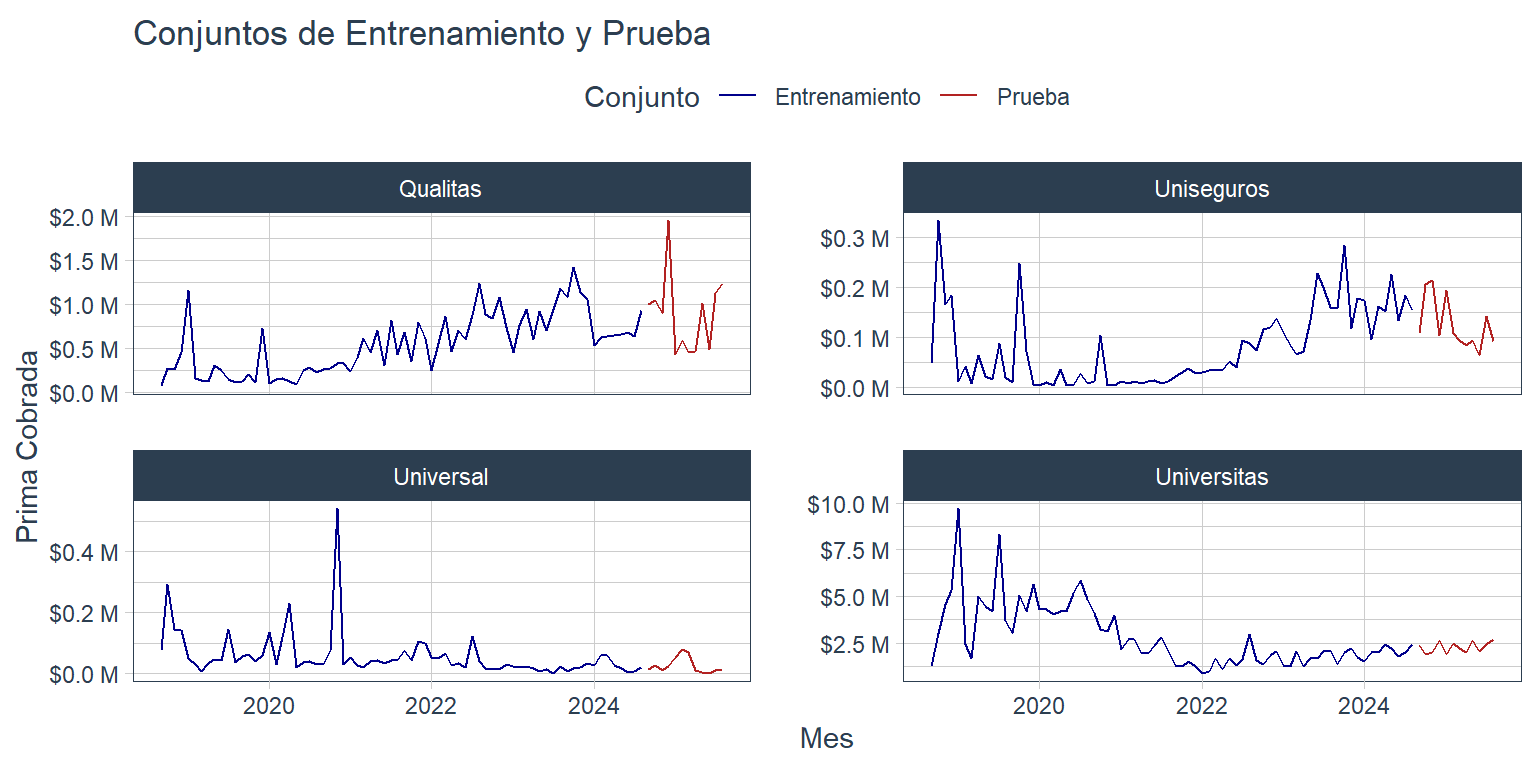
Para evaluar la capacidad predictiva de los modelos, se implementó un esquema de backtesting en cada serie de tiempo. Este procedimiento consiste en dividir la información histórica en dos subconjuntos cronológicamente ordenados:
- Conjunto de Entrenamiento: Conformado por todas las observaciones disponibles, excluyendo los últimos doce meses. En este subconjunto se ajustan los modelos, es decir, se entrenan para capturar la estructura de la serie antes de realizar pronósticos.
- Conjunto de prueba: Integrado por los doce meses más recientes, que se reservan para validar los pronósticos generados a partir de los modelos ajustados.
Se seleccionó un período de prueba de 12 meses para evaluar el desempeño de los modelos a lo largo de un ciclo anual completo, lo cual es esencial para validar la capacidad de los modelos de capturar componentes estacionales.
A continuación, se visualiza la partición de entrenamiento y prueba para cada serie:
Pronósticos ARIMA
Para la generación de pronósticos con la metodología ARIMA, se utilizó el procedimiento automatizado de Box-Jenkins implementado en el paquete fable desarrollado por el Profesor Rob Hyndman. Este enfoque proporciona una base sólida y reproducible para la comparación:
| Modelos Arima / Sarima | |
| Compañía | Modelo Ajustado |
|---|---|
| Estar | ARIMA(1,1,3)(1,0,0)[12] |
| Hispana | ARIMA(0,1,2)(1,0,0)[12] |
| Mercantil | ARIMA(0,1,1)(0,0,1)[12] |
| Oceánica | ARIMA(0,1,3)(1,0,0)[12] |
| Qualitas | ARIMA(0,1,1)(0,0,2)[12] |
| Uniseguros | ARIMA(0,1,1)(1,0,0)[12] |
| Universal | ARIMA(0,1,1) |
| Universitas | ARIMA(5,1,0)(1,0,0)[12] |
Se destaca que 7 de las 8 series presentan modelos estacionales SARIMA con un componente estacional anual. Además, la estacionalidad se manifiesta principalmente en componentes autoregresivos (AR) estacionales.
Tras el ajuste de los modelos, se generaron los pronósticos correspondientes al período de prueba (últimos 12 meses). A continuación, se presenta una evaluación visual de estos pronósticos, superpuestos a los datos históricos reales. Esta inspección gráfica es el primer paso para comprender el desempeño de los modelos antes de una evaluación cuantitativa a través de métricas de error:
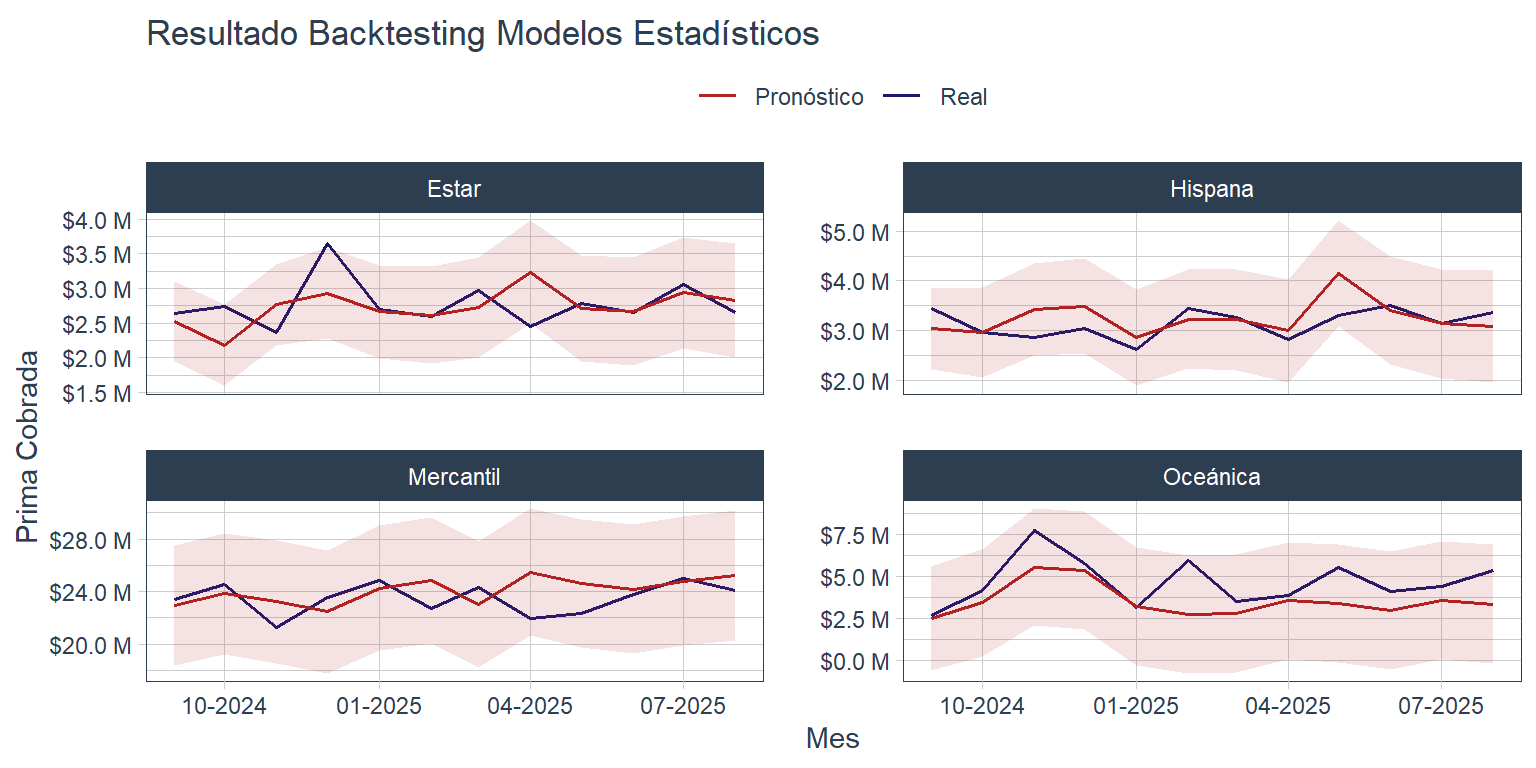
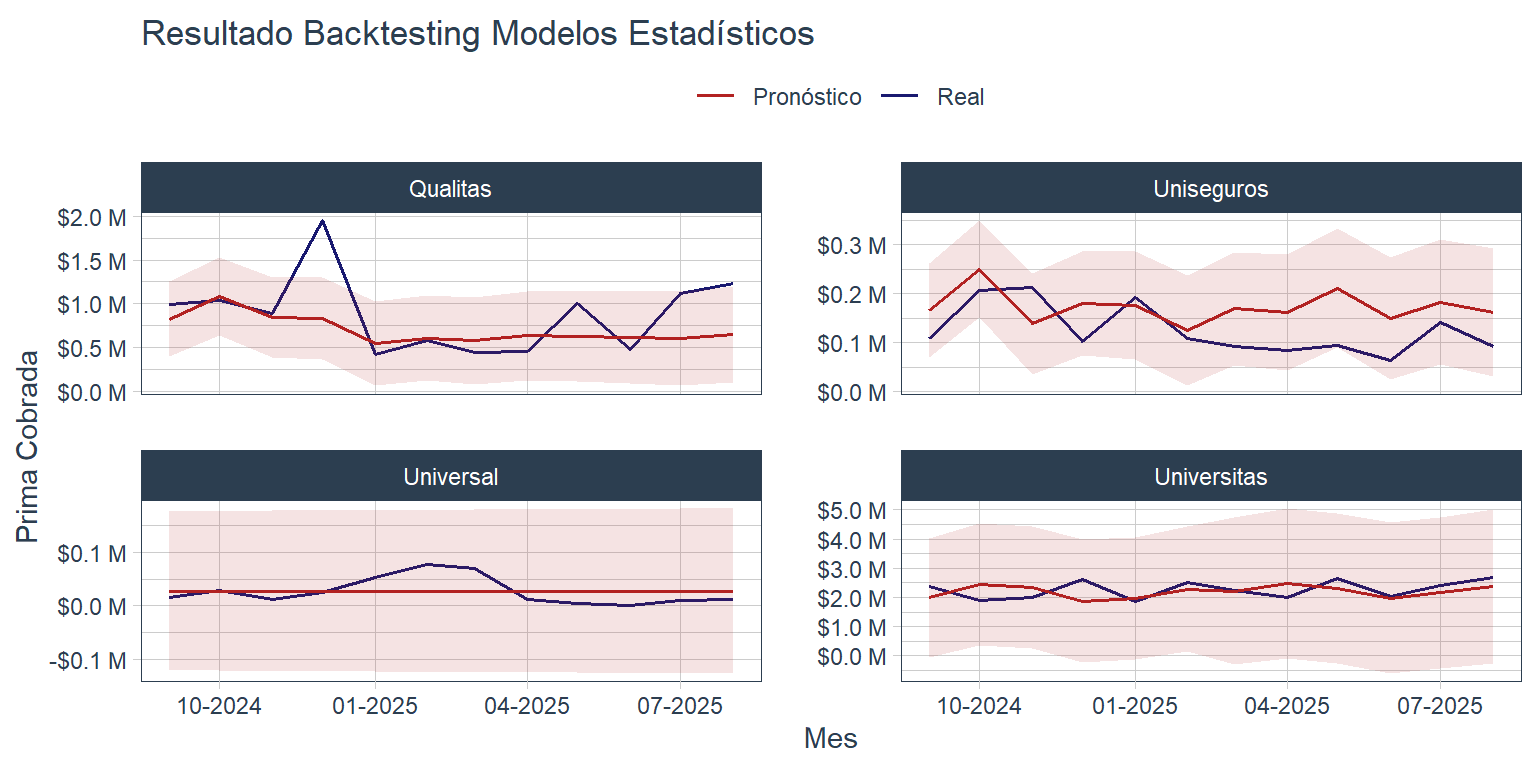
La visualización del backtesting ayuda a evaluar los pronósticos. Sin embargo, es necesario computar métricas de error que permitan cuantificar y analizar la magnitud de las diferencias entre los valores observados y los pronosticados por los modelos implementados.
En este análisis se utilizaron tres métricas:
- RMSE (Raíz del Error Cuadrático Medio): mide la magnitud promedio del error elevando al cuadrado las desviaciones y luego extrayendo la raíz. Penaliza con mayor fuerza los errores grandes, por lo que es útil para detectar si el modelo falla en capturar valores extremos.
- MAE (Error Absoluto Medio): calcula el error absoluto promedio, otorgando una visión clara e intuitiva del error típico en las unidades originales de la variable (en este caso, dólares).
- MAPE (Error Porcentual Absoluto Medio): expresa el error en términos porcentuales respecto al valor real, lo que facilita la comparación entre series de distinta escala. Su limitación es que no informa la dirección del error (positivo o negativo) y puede distorsionarse cuando los valores reales son cercanos a cero.
| Resultado Metricas de Error | ||||
| Compañía | modelo | RMSE | MAE | MAPE |
|---|---|---|---|---|
| Estar | Sarima | 380.608,43 | 273.918,94 | 9,86 |
| Hispana | Sarima | 369.040,31 | 277.797,40 | 8,88 |
| Mercantil | Sarima | 1.627.068,95 | 1.323.327,71 | 5,81 |
| Oceánica | Sarima | 1.505.231,38 | 1.164.627,40 | 22,32 |
| Qualitas | Sarima | 418.225,81 | 286.541,77 | 28,68 |
| Uniseguros | Sarima | 68.837,32 | 62.946,45 | 62,31 |
| Universal | Sarima | 25.054,45 | 20.902,91 | 330,96 |
| Universitas | Sarima | 375.339,41 | 314.896,36 | 13,86 |
A través del MAPE podemos evidenciar que en series con tendencia de crecimiento estable como Mercantil, Estar e Hispana, los modelos SARIMA hacen buenos pronósticos.
Por otro lado, las series con comportamientos volátiles o atípicos presentan desafíos significativos para los modelos. Qualitas y Uniseguros muestran MAPEs elevados (28.68% y 62.31% respectivamente), indicando que los patrones erráticos de estas series superan la capacidad predictiva de los modelos estadísticos tradicionales.
Un caso particularmente crítico es Universal, cuyo MAPE es extremadamente alto (330.96%) reflejando la dificultad del modelo para pronosticar series con valores cercanos a cero. El análisis visual confirma que el pronóstico generado es esencialmente plano, fallando en capturar la mínima variabilidad que presenta la serie real.
Pronósticos Time-GPT
A continuación, se muestran los resultados de los pronósticos generados con el modelo Time-GPT, implementado mediante el paquete nixtlar. El modelo se utiliza en su modalidad de “zero-shot learning”, que permite generar pronósticos sin necesidad de un entrenamiento previo con datos históricos específicos.
Esta característica facilita una implementación inmediata y la obtención rápida de pronósticos para cualquier serie temporal. Si bien el modelo puede optimizarse mediante un proceso de “fine-tuning” de sus hiperparámetros, para los propósitos de este análisis se utilizó la versión básica. Esto permite realizar una comparación directa y clara entre el desempeño de Time-GPT y el de los modelos ARIMA/SARIMA tradicionales.
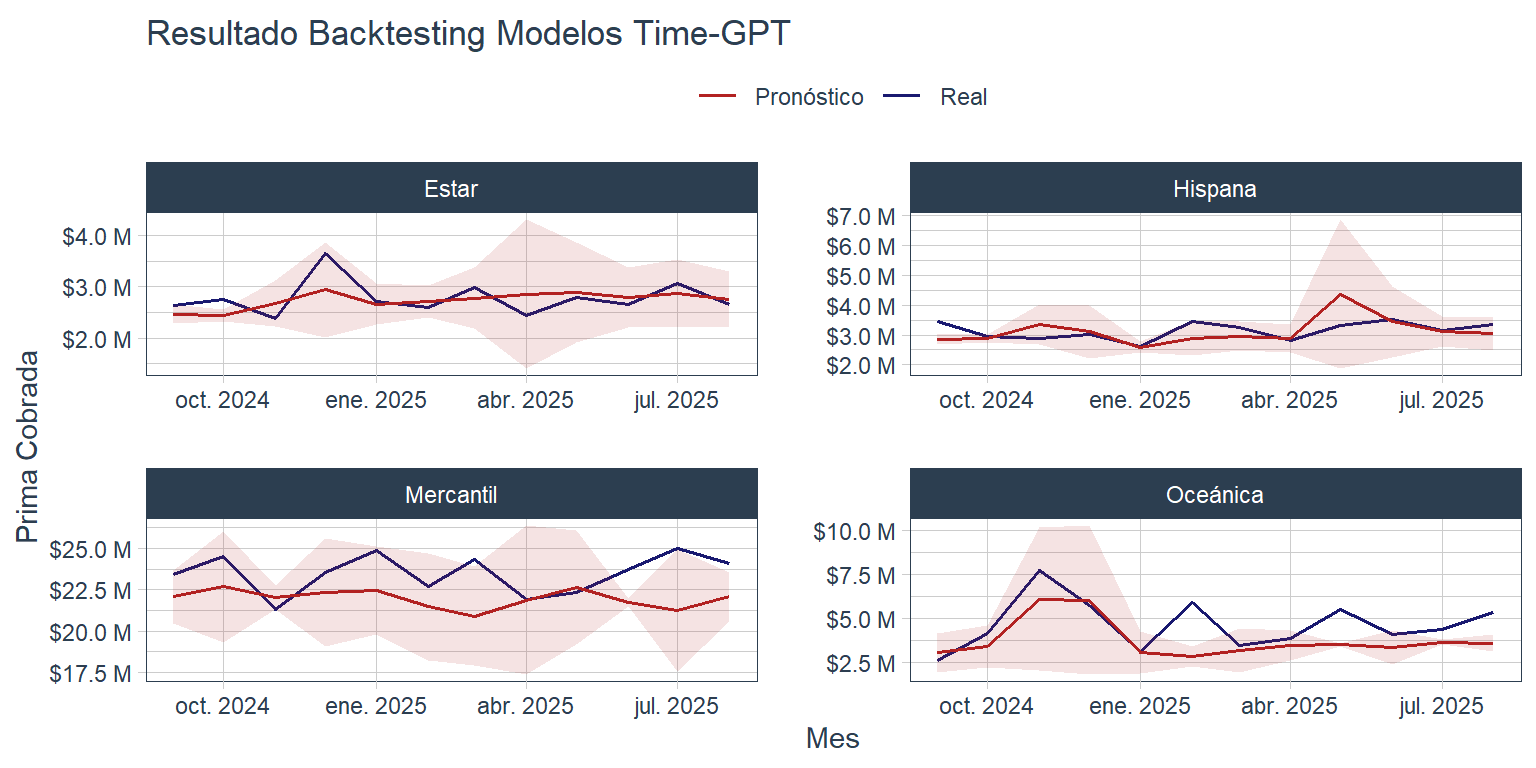
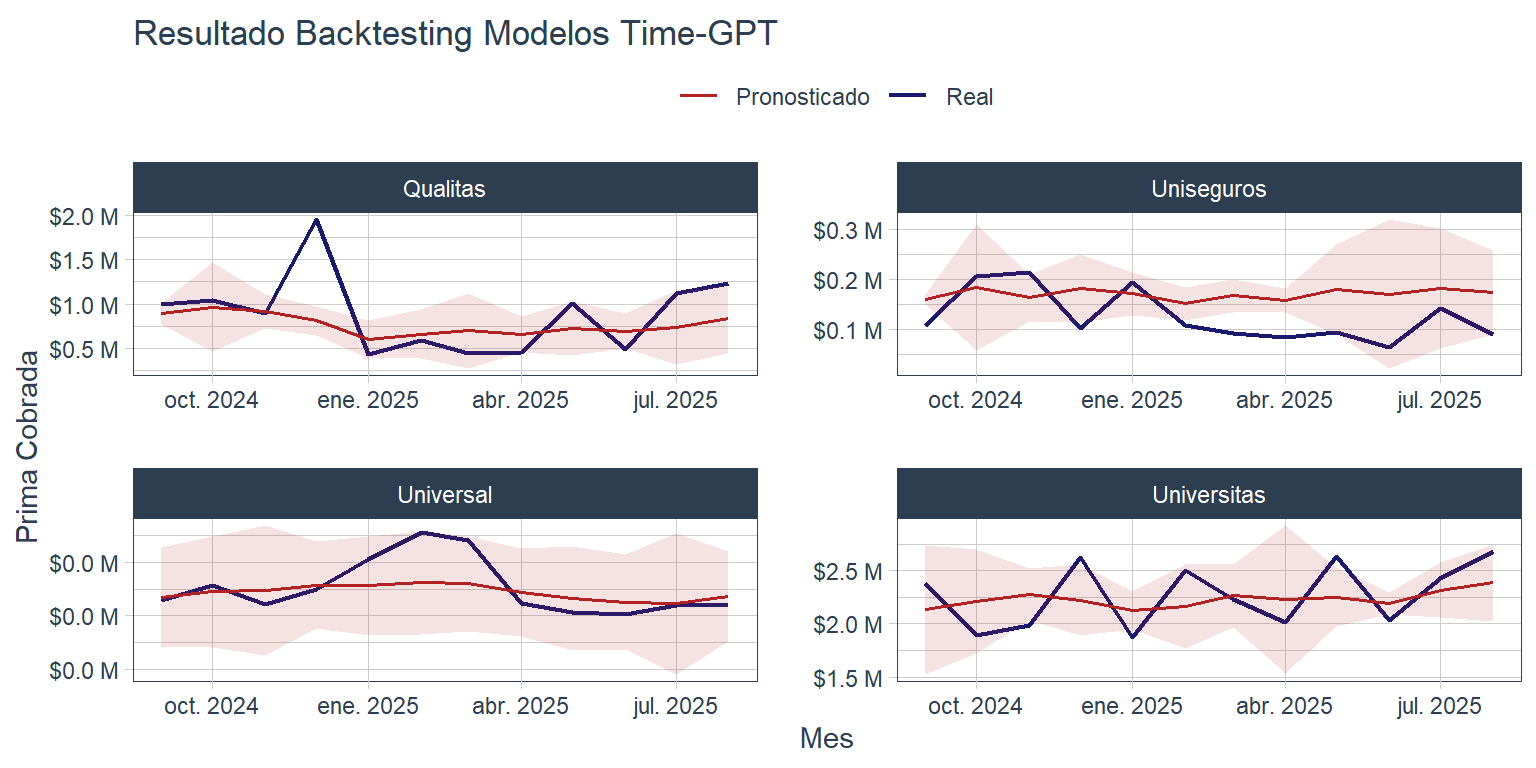
Para la comparación de modelos se utilizó la Raíz del Error Cuadrático Medio (RMSE):
| Resultado Metricas de Error | |||
| Compañía | Sarima | Time-GPT | Variación (%) |
|---|---|---|---|
| Estar | 380.608,43 | 288.936,02 | −24.09% |
| Hispana | 369.040,31 | 429.617,40 | 16.41% |
| Mercantil | 1.627.068,95 | 2.013.645,28 | 23.76% |
| Oceánica | 1.505.231,38 | 1.328.403,82 | −11.75% |
| Qualitas | 418.225,81 | 395.694,14 | −5.39% |
| Uniseguros | 68.837,32 | 66.120,71 | −3.95% |
| Universal | 25.054,45 | 20.667,64 | −17.51% |
| Universitas | 375.339,41 | 273.931,67 | −27.02% |
Reflexiones Finales
Los resultados muestran que Time-GPT supera a los modelos SARIMA en la mayoría de las ocho aseguradoras analizadas, destacando especialmente en series con comportamientos complejos o volátiles, como Universal y Universitas. Por su parte, SARIMA mantiene un buen desempeño en series con patrones estables y predecibles, como Mercantil e Hispana.
La principal ventaja de Time-GPT radica en su capacidad de generar pronósticos de manera inmediata, sin necesidad de ajuste manual de parámetros, lo que lo convierte en una herramienta especialmente útil para análisis exploratorios y comparativos de múltiples series temporales.
Estos hallazgos evidencian que Time-GPT representa un avance significativo en la predicción de series temporales. Aunque funciona como un modelo de “caja negra”, su eficacia demuestra el potencial de los enfoques basados en inteligencia artificial. No obstante, los métodos tradicionales como SARIMA conservan su valor, sobre todo en series con patrones bien definidos, donde la transparencia e interpretabilidad son ventajas clave.
El futuro del análisis de series temporales probablemente se beneficiará de enfoques híbridos, que combinen la potencia de modelos preentrenados como Time-GPT con la transparencia de modelos estadísticos, aprovechando lo mejor de ambos mundos: precisión y automatización junto con interpretabilidad y conocimiento experto.