Introducción
El presente análisis tiene como finalidad realizar un estudio del precio de ventas de casas en el condado de King, Washington durante los años 2014 y 2015. Para llevar a cabo este análisis, se utilizaron datos obtenidos de la reconocida comunidad de científicos de datos Kaggle, que ofrece una amplia gama de conjuntos de datos confiables y de alta calidad.
La meta será desarrollar un modelo de apredizaje supervisado que puedas predecir el valor de venta de una determinada casa en el condado de King, de acuerdo a ciertas variables / características que se encuentran en los datos. Para esto se empleará el conocido modelo de regresión lineal multivariante y, además, varios algoritmos de aprendizaje automático.
Se hará uso del ecosistema de paquetes que ofrece Tidymodels para el desarrollo de los distintos modelos de aprendizaje supervisado.
Descripción en los datos
En total hay 21 columnas el los datos, las cuáles se describen a continuación:
- ID: Correlativo númerico que distingue cada una de las casas vendidas.
- Date: Fecha en la cual fue vendida la casa.
- Price: Precio de venta de la casa (en dólares norteamericanos).
- Bedrooms: Número de cuartos en la casa.
- Bathrooms: Número de baños disponibles en la casa, donde un valor de 0.5 representa un baño con inodoro pero sin ducha.
- Sqft_living: Número de pies cuadrados del espacio habitable de la casa.
- Sqft_lot: Pies cuadrados del espacio total del terreno donde se ubica la casa.
- Floors: Cantidad de pisos en la casa.
- Waterfront: Variable que indica la presencia o no de vista al mar en la casa.
- View: Índice del 0 al 4 que indica que tan buena es la vista de la propiedad.
- Condition: Índice del 1 al 5 para calificar la condición actual de la casa.
- Grade: Índice del 1 al 13, el cuál califica el nivel de calidad de construcción de la casa.
- Sqft_above: Cantidad de pies cuadrados del espacio interior de la casa. que está sobre el nivel del suelo.
- Sqft_basement: Los pies cuadrados del espacio interior de la casa. que está por debajo del nivel del suelo.
- Yr_built: El año en fue construida la casa.
- Yr_renovated: Año de la última renovación de la casa.
- Zipcode: Código postal del areá donde se encuentra la casa.
- Lat: Latitud de la ubicación de la casa.
- Long: Longitud de la ubicación de la casa.
- Sqft_living15: Los pies cuadrados de espacio habitable de la casa interior para los 15 vecinos más cercanos.
- Sqft_lot15: Los metros cuadrados de los terrenos de los 15 vecinos más cercanos.
Análisis Exploratorio de los Datos
Estadísticas Descriptivas
Para evaluar y caracterizar los datos en estudio se emplearon las siguientes estadísticas descriptivas:
- Media Muestral: Representa el valor promedio.
- Desviación Estándar: Permite conocer el grado de variación o dispersión con respecto a la media.
- Coeficiente de Asimetría: Representa el grado de simetría o asimetría de los rendimientos con respecto a su media.
- Coeficiente de Curtosis: Permite la medición de las colas de la distribución empírica de los rendimientos en relación con una distribución normal.
- Coeficiente de Variación: Cuantifica estadísticamente la dispersión relativa de los rendimientos.
| Variable | Valor Mínimo | Valor Máximo | Promedio | Desviación Estándar | Coeficiente de Asimetría | Coeficiente de Curtosis | Coeficiente de Variación |
|---|---|---|---|---|---|---|---|
| price | 75.000,00 | 7.700.000,00 | 540.088,14 | 367.127,20 | 4,02 | 37,58 | 67,98 |
| bedrooms | 0,00 | 33,00 | 3,37 | 0,93 | 1,97 | 52,05 | 27,59 |
| bathrooms | 0,00 | 8,00 | 2,06 | 0,76 | 1,08 | 5,75 | 36,70 |
| sqft.living | 290,00 | 13.540,00 | 2.079,90 | 918,44 | 1,47 | 8,24 | 44,16 |
| sqft.lot | 520,00 | 1.651.359,00 | 15.106,97 | 41.420,51 | 13,06 | 288,01 | 274,18 |
| floors | 1,00 | 4,00 | 1,53 | 0,55 | 0,39 | 2,19 | 36,14 |
| view | 0,00 | 4,00 | 0,23 | 0,77 | 3,40 | 13,89 | 327,06 |
| condition | 1,00 | 5,00 | 3,41 | 0,65 | 1,03 | 3,53 | 19,09 |
| grade | 1,00 | 13,00 | 7,66 | 1,18 | 0,77 | 4,19 | 15,35 |
| sqft.above | 290,00 | 9.410,00 | 1.788,39 | 828,09 | 1,45 | 6,40 | 46,30 |
| sqft.basement | 0,00 | 4.820,00 | 291,51 | 442,58 | 1,58 | 5,71 | 151,82 |
| yr.built | 1.900,00 | 2.015,00 | 1.971,01 | 29,37 | −0,47 | 2,34 | 1,49 |
| yr.renovated | 0,00 | 2.015,00 | 84,40 | 401,68 | 4,55 | 21,70 | 475,91 |
| zipcode | 98.001,00 | 98.199,00 | 98.077,94 | 53,51 | 0,41 | 2,15 | 0,05 |
| lat | 47,16 | 47,78 | 47,56 | 0,14 | −0,49 | 2,32 | 0,29 |
| long | −122,52 | −121,31 | −122,21 | 0,14 | 0,88 | 4,05 | −0,12 |
| sqft.living15 | 399,00 | 6.210,00 | 1.986,55 | 685,39 | 1,11 | 4,60 | 34,50 |
| sqft.lot15 | 651,00 | 871.200,00 | 12.768,46 | 27.304,18 | 9,51 | 153,73 | 213,84 |
El valor promedio del precio de venta de las casas es de aproximadamente USD 540K, con un valor máximo de venta de USD 7.7M. La desviación de 367.127 indica que existe una variabilidad significativa en los precios. Además, el coeficiente de asimetría de 4.02 sugiere una distribución sesgada hacia la derecha. Igualmente, la curtosis del precio de venta indica la presencia de colas pesadas en el precio de venta. Por último, el coeficiente de variación alerta de una alta dispersión relativa en los precios de venta.
En el número de cuartos y baños que tienen las casas, se observa que el valor mínimo es 0, lo cual carece de sentido. Además, se muestra que existe una casa con 33 habitaciones. En este caso, el valor mínimo de 0 para el número de cuartos y baños no tiene sentido, ya que es poco probable que una casa no tenga ningún cuarto o baño. Además, el hecho de que haya una casa con 33 habitaciones es bastante inusual.
Análisis de Correlación de Pearson
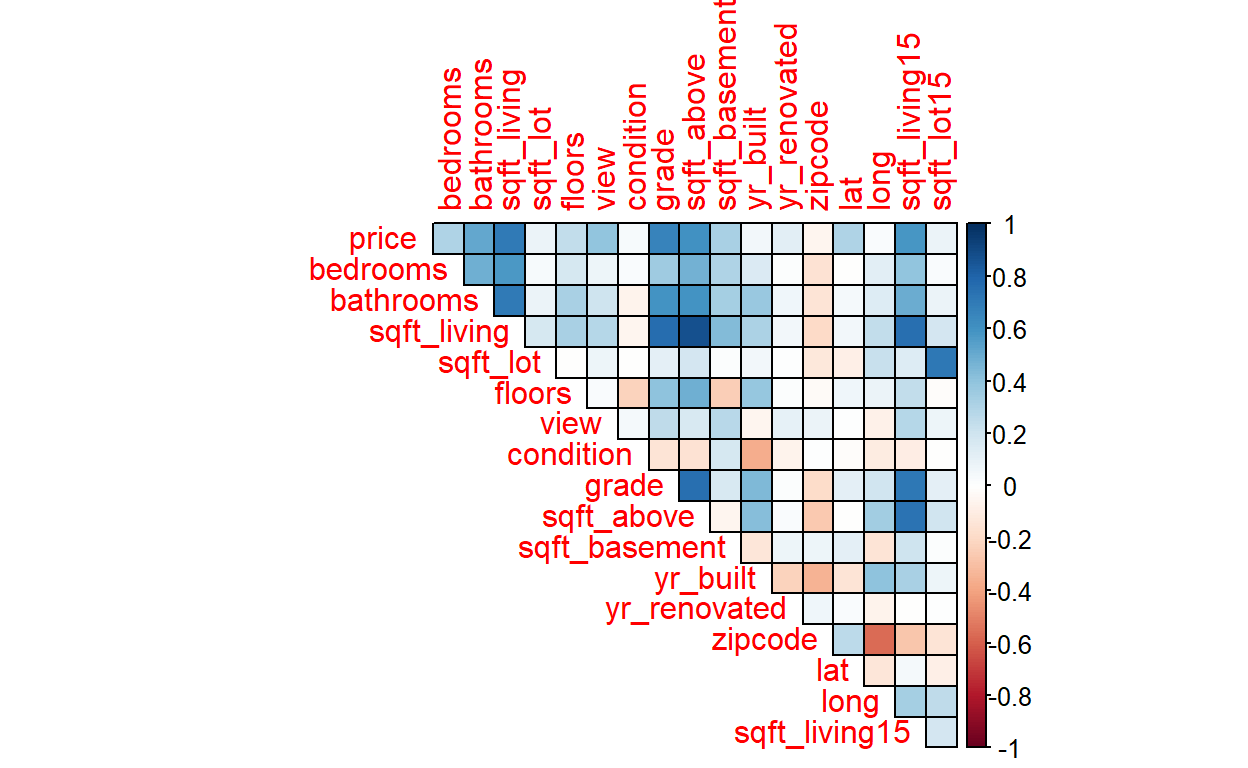
La variable de interés para este análisis es el precio de venta de las casas. Se puede observar que existen correlaciones altas con varias variables predictoras, como el número de baños, el número de pies cuadrados de espacio habitable y el nivel de calidad de construcción de las casas, entre otros. Sin embargo, también se visualizan variables predictoras con correlaciones altas, lo cual puede ocasionar problemas de sobreajuste en los modelos y disminuir su capacidad de generalización
Es importante tener en cuenta estas correlaciones altas al desarrollar modelos predictivos para el precio de venta de las casas. Si se incluyen todas las variables con altas correlaciones, es posible que los modelos se ajusten demasiado a los datos de entrenamiento y no puedan generalizar eficazmente a nuevos datos. Para evitar el sobreajuste, se pueden aplicar técnicas de selección de variables, como el análisis de correlación y la eliminación de variables redundantes.
Distribución de los Precios
Para comenzar con el análsis exploratorio de los datos, es bueno visualizar la distribución de la variable respuesta o target que queremos estudiar.
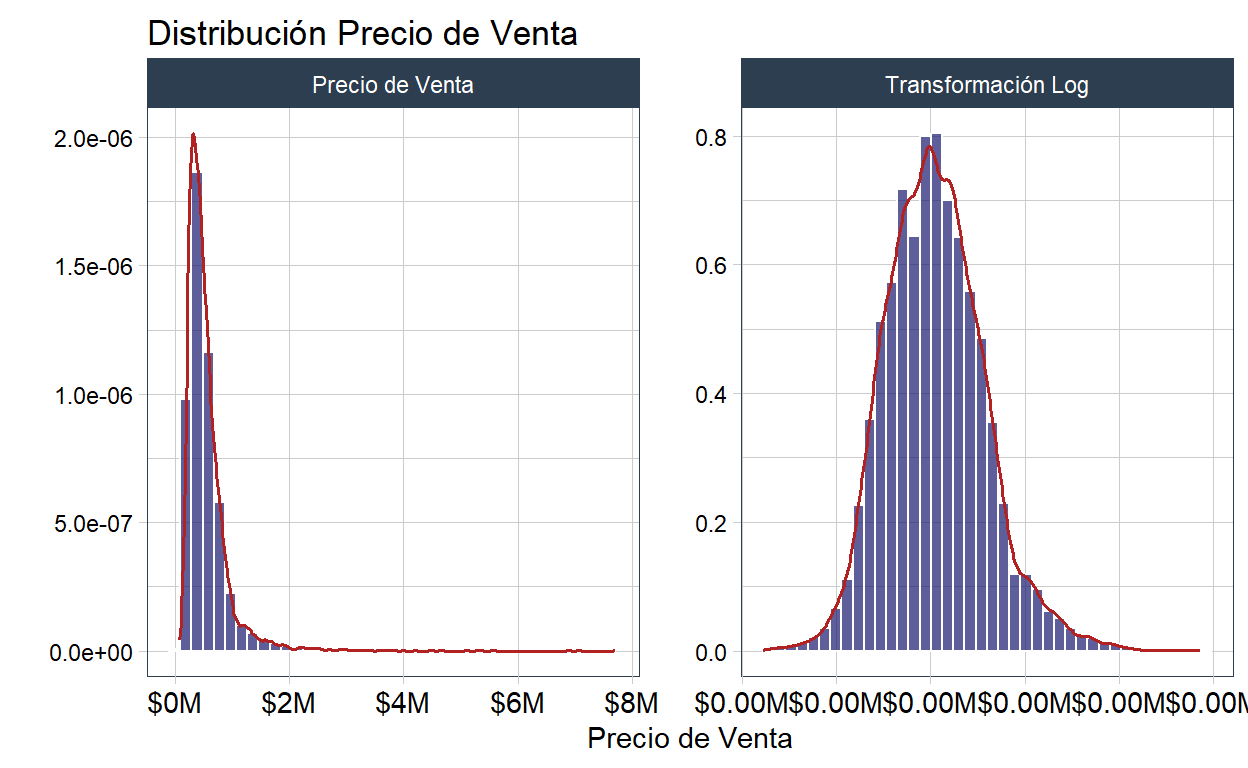
Se observa que los datos están sesgados hacia la derecha por lo que al realizar una transformación logarítmica se estabiliza la varianza y a visualizar mejor la distribución de los precios.
La transformación logarítmica es una técnica comúnmente utilizada para corregir el sesgo en los datos. Al aplicar esta transformación, se toma el logaritmo natural de cada valor en el conjunto de datos. Esto tiene el efecto de comprimir los valores más altos y expandir los valores más bajos, lo que puede ayudar a reducir el sesgo hacia la derecha y hacer que la distribución sea más simétrica.
Característica de las Casas
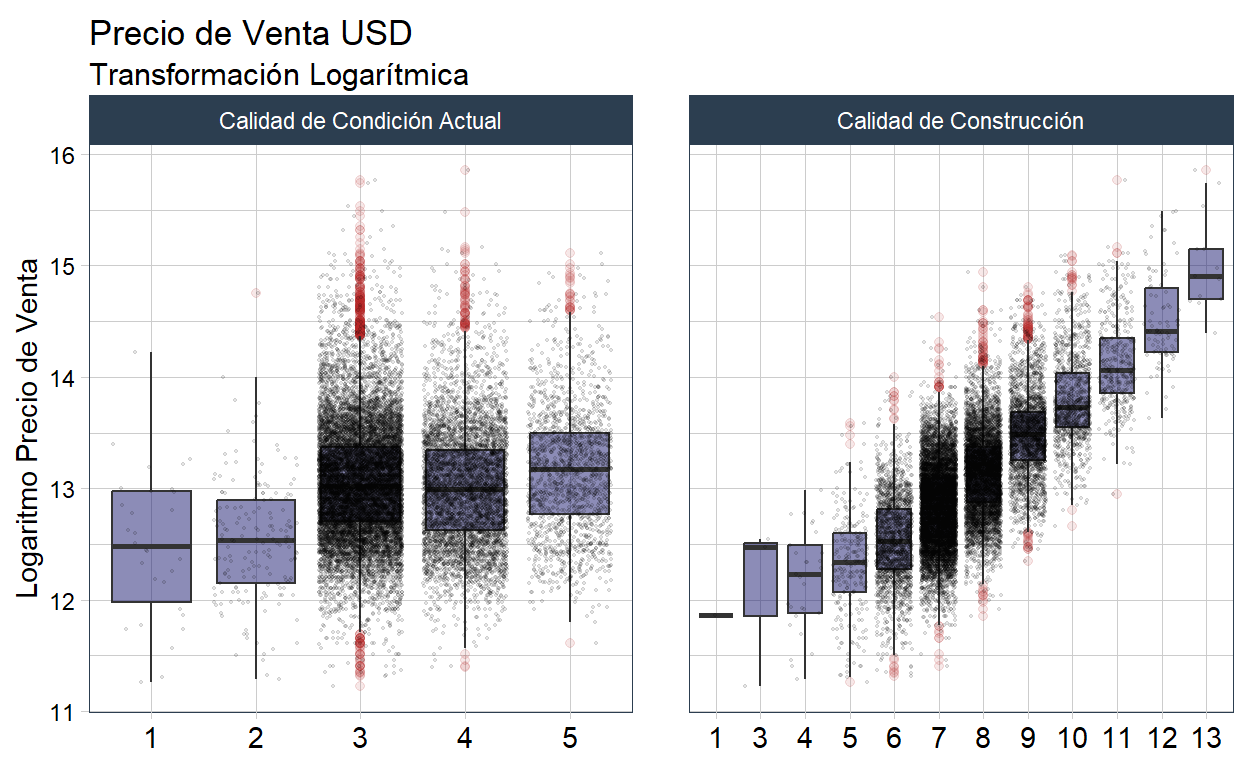
Basado en los datos disponibles, se observa que la mayoría de las casas se concentran en las categorías siete, ocho y nueve del nivel de construcción. Es evidente que hay un crecimiento en la mediana del precio de venta en las casas con mayor categoría de construcción. Sin embargo, algunas categorías parecen englobar muy pocas ventas de casas. Por otro lado, los niveles 3 y 4 de condición actual concentran la mayoría de los datos, y además, se observa un gran número de precios que sobrepasan los límites superiores e inferiores del gráfico de caja, clasificándose como valores atípicos. La mediana aumenta a medida que aumenta el nivel de condición actual.
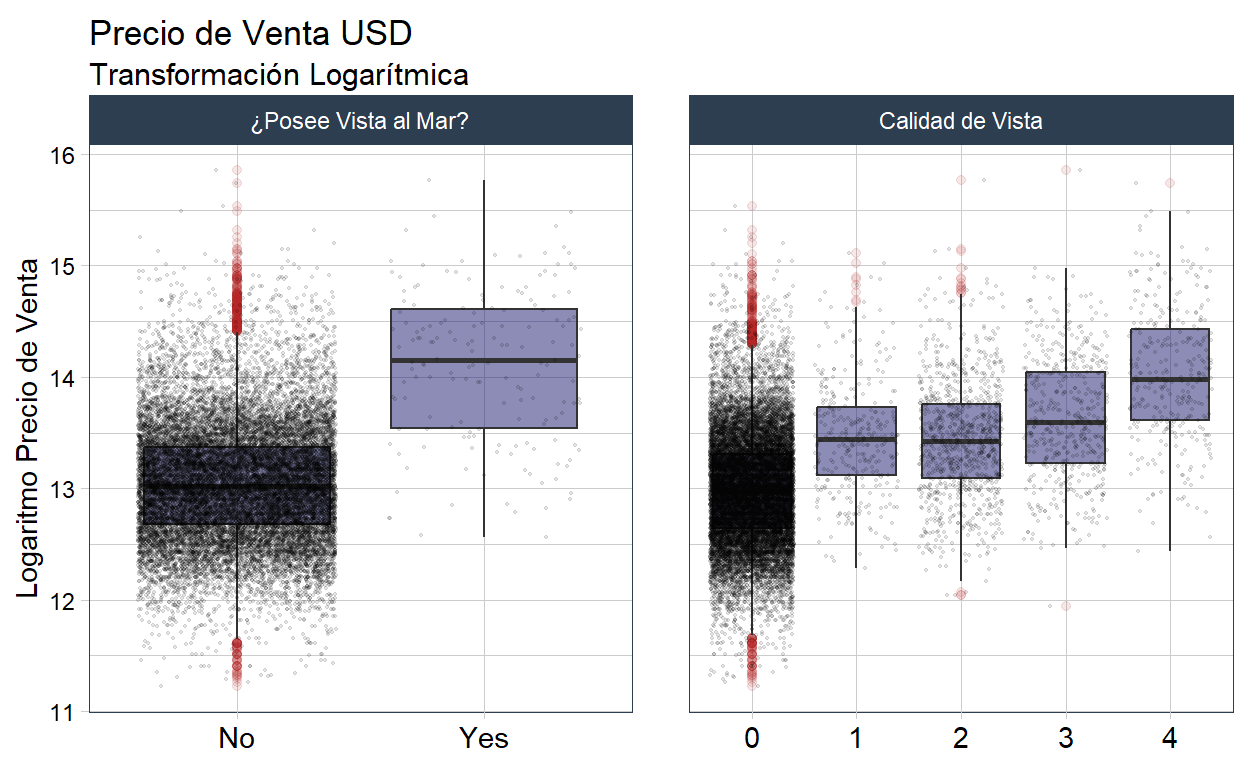
La mayoría de las casas se concentran en el nivel 0 de calidad de vista. Además, se observa que la mediana del precio de venta aumenta de acuerdo al nivel de calidad de vista que tiene la casa. Por otra parte, se observa que las casas con vista al mar tienen un precio mediano mayor. Sin embargo, la mayoría de las casas vendidas no poseen vista al mar.
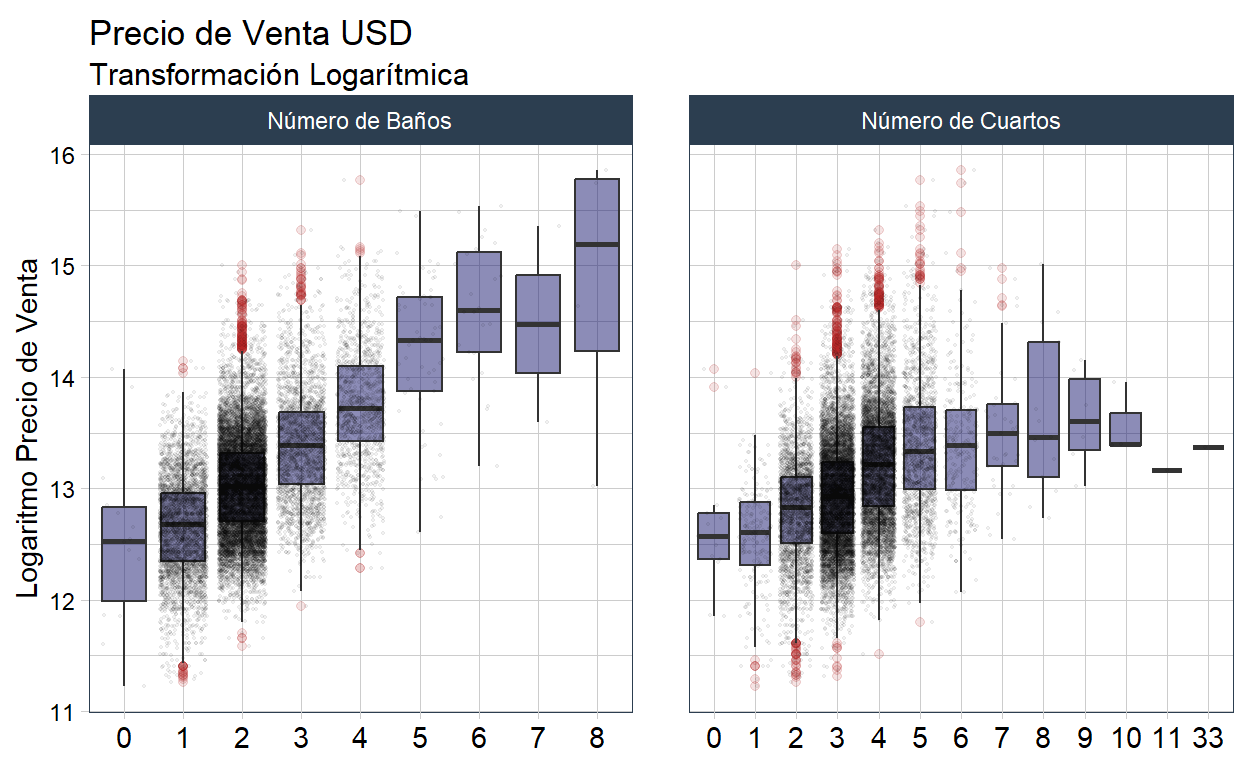
Se visualiza que hay casas que poseen más de diez habitaciones y hasta treinta y tres. Sin embargo, al investigar en detalle, se encuentra que solo hay un caso de una casa con once habitaciones y otra con treinta y tres habitaciones. La mediana del precio de venta aumenta a medida que se incrementan tanto el número de baños como de habitaciones en las casas. Sin embargo, la mayoría de las casas en los datos tienen entre uno y dos baños, y entre tres y cuatro habitaciones. Se observa que la dispersión del precio de venta se incrementa drásticamente a partir de los cinco baños.
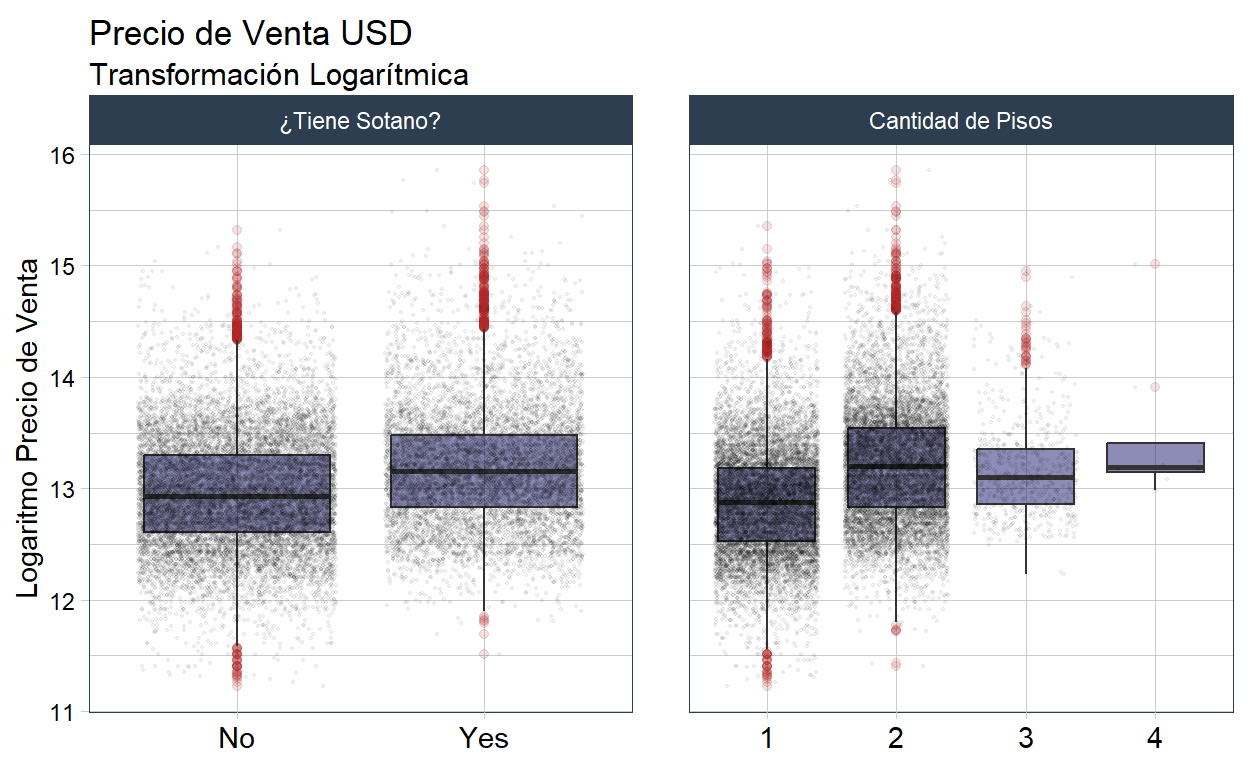
Las casas con sótano tienen un precio de venta mediano mayor y el valor de las casas aumenta a medida que tienen más pisos. La dispersión de los precios es similar cuando las casas tienen o no sótano.
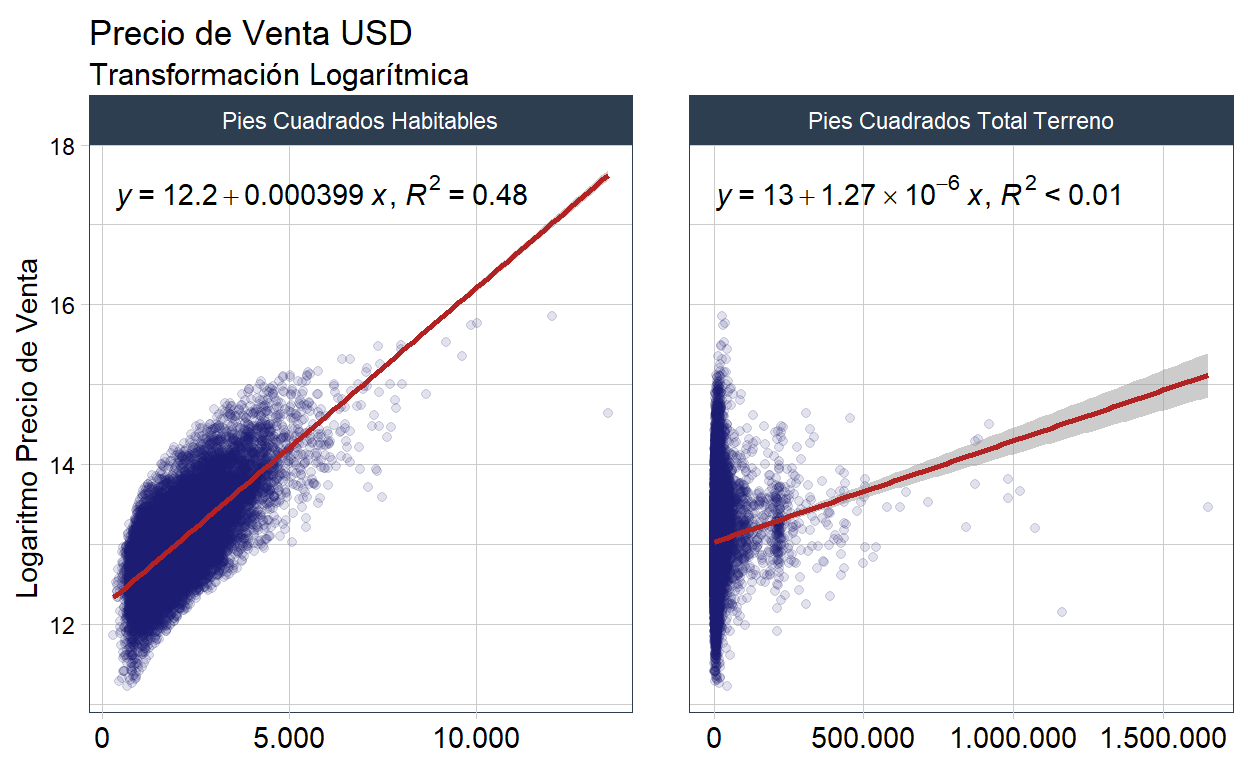
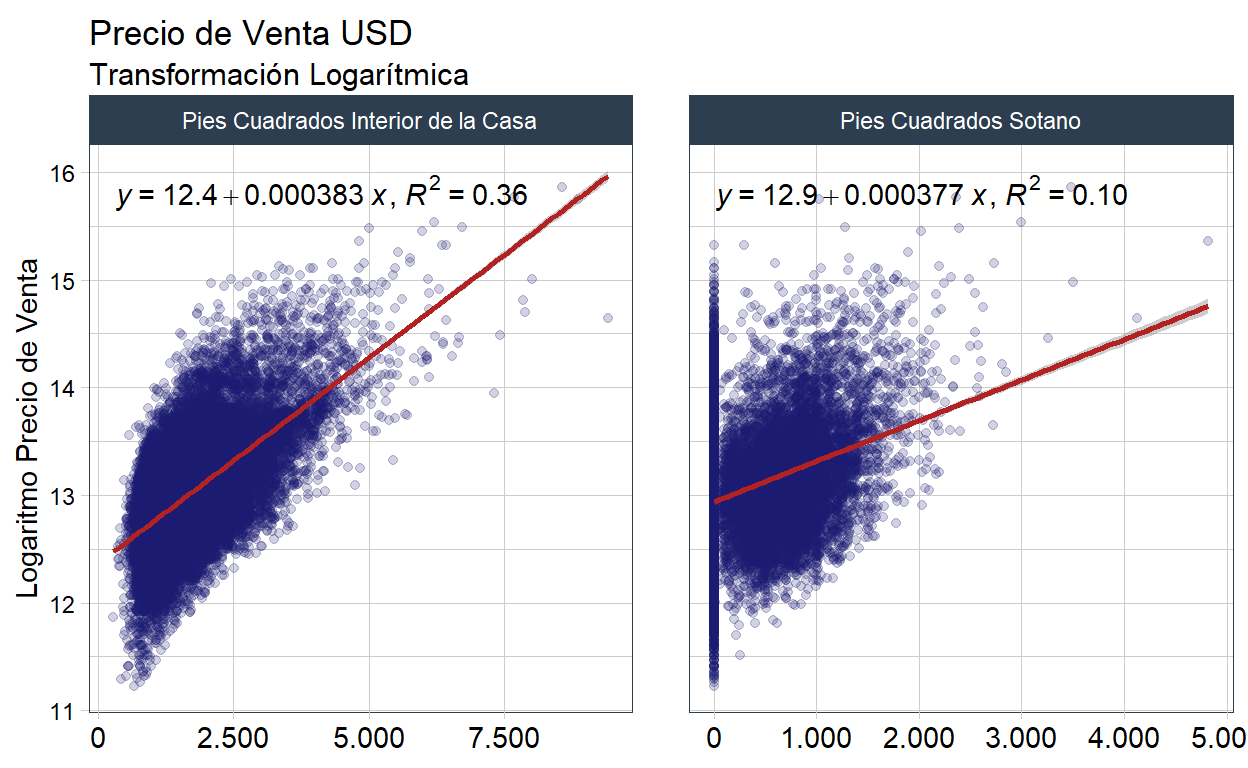
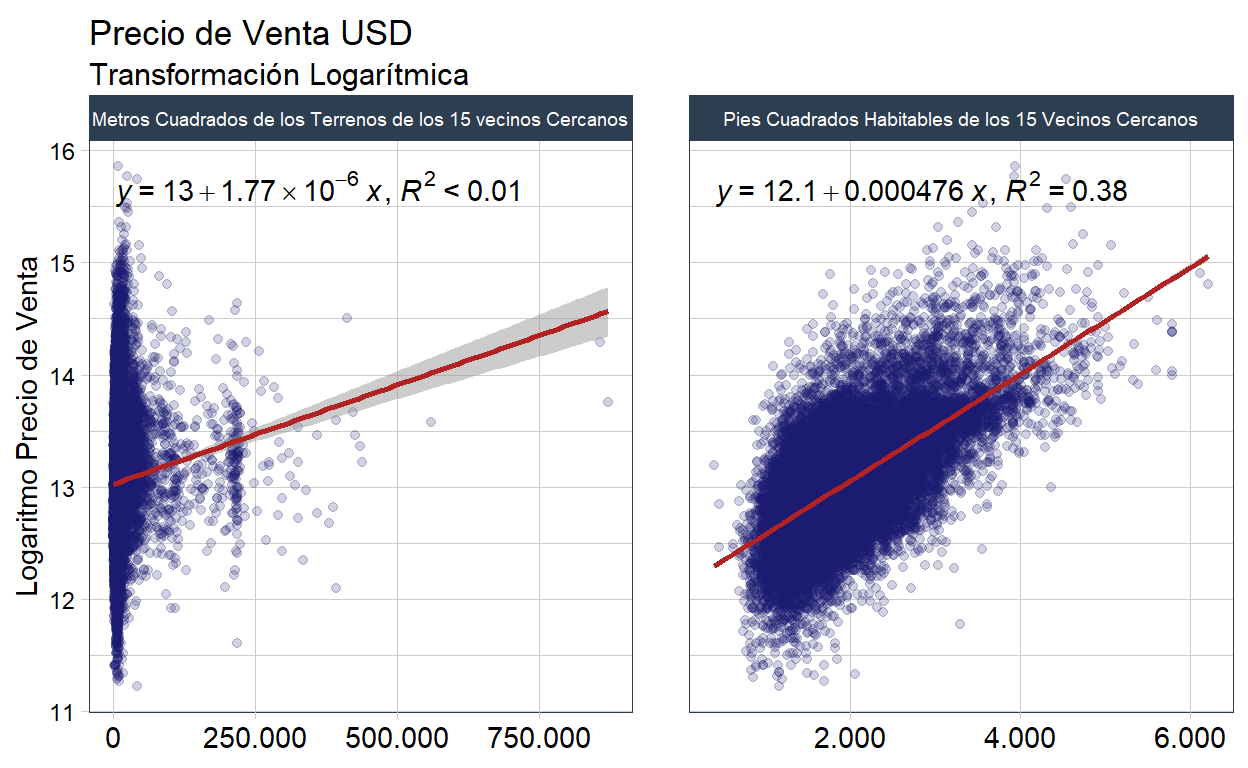
No se evidencia una relación lineal entre los pies cuadrados totales del terreno de la casa y su precio de venta. Por otro lado, se visualiza una relación lineal positiva entre los pies cuadrados habitables de la casa y el precio de venta. Al emplear un modelo de regresión lineal simple, se obtiene un \(R^{2}\) de aproximadamente 48%, lo que indica que el modelo planteado puede explicar el 48% de la variabilidad observada en el precio de venta.
Ubicación Geográfica
A continuación, se visualiza en un mapa geográfico, el precio de venta promedio de las casas de acuerdo a su latitud y longitud.
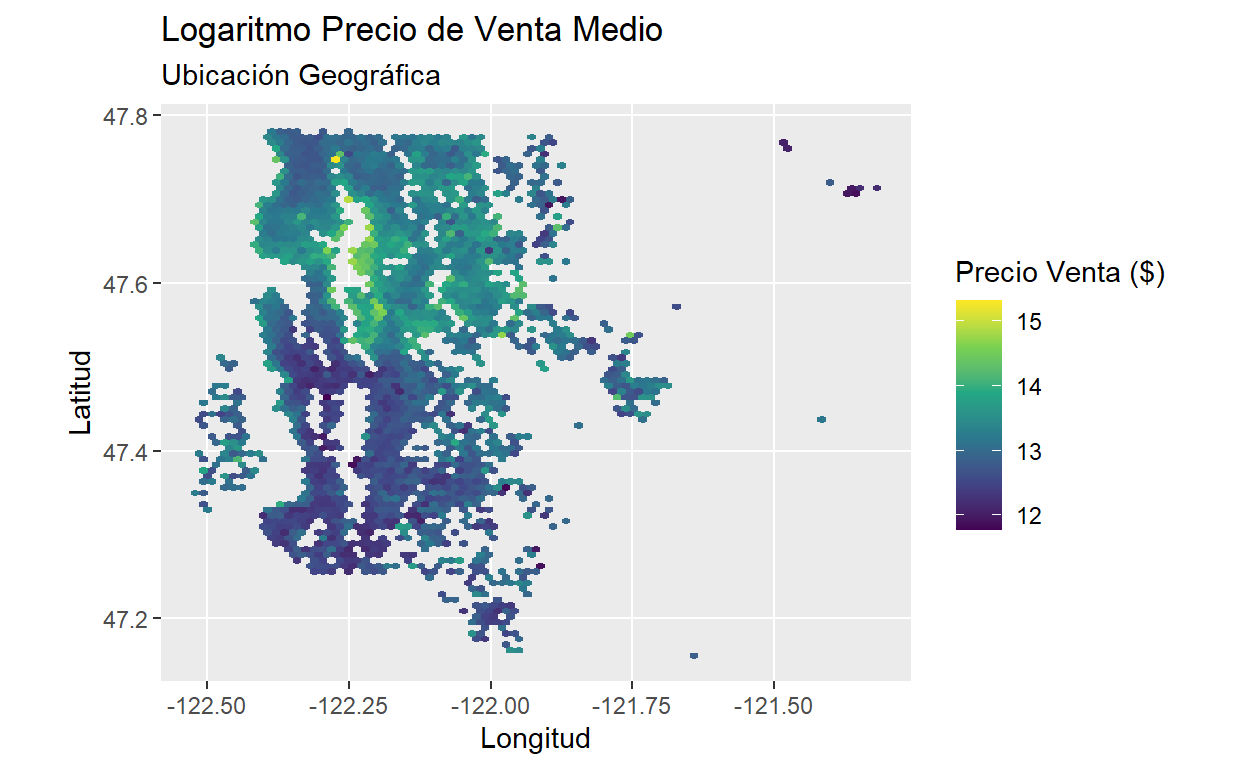
El precio medio de venta de las casas es mayor en la zona norte del contado de King.
Partición de los datos
Entrenamiento y prueba
Realizar modelos de aprendizaje supervisado haciendo uso de todos los datos disponibles no suele ser una buena opción debido a que esto suele causar problemas de “sobre ajuste”. Es mejor particionar los datos en dos conjuntos, una para entrenar los modelos y otro para probar o testear los modelos, esto nos permitirá saber el desempeño de los modelos en datos nuevos.
# Partición 80% / 20%
set.seed(1234)
split <- initial_split(data = house, prop = 0.80, strata = price)

# Datos de entrenamiento
train_set <- training(split)

# Datos de prueba
test_set <- testing(split)
Validación cruzada
Aparte de particionar los datos en conjuntos de entrenamiento y prueba se particionara el conjunto de entrenamiento en 5 subconjuntos de datos uniformes, esto permite tener un mejor entendimiento del comportamiento de los modelos.
El proceso es ajustar los modelos en uno de los subconjuntos y utilizar los otros cuatros para computar métricas de rendimiento, este proceso se repite hasta que todos los subconjuntos sean utilizados para ajustar los modelos. Por lo general, luego se toma la media de las métricas de rendimiento de este proceso.
set.seed(1234)

folds <- vfold_cv(train_set, strata = price, v = 5)

folds
# 5-fold cross-validation using stratification
# A tibble: 5 × 2
splits id
<list> <chr>
1 <split [13830/3459]> Fold1
2 <split [13830/3459]> Fold2
3 <split [13830/3459]> Fold3
4 <split [13833/3456]> Fold4
5 <split [13833/3456]> Fold5Ingeniería de variables
En base a lo observado en el análisis exploratorio se creará un récipe con el preprocesamiento haciendo uso de ingeniería de variables para mejorar el desempeño de los algoritmos.
Récipe de Preprocesamiento
A continuación, se explica los pasos que se incluirán en el récipe para el preprocesamiento de los datos:
- Se define el rol de la variable “id” como una variable identificativa, de esta forma no será considerada como un variable explicativa.
- Se aplica la función “as_date” a la variable date para poder corregir su formato y que sea interpretada como una fecha.
- Se corrigen las variables “bedrooms” y “floors”. Debido a que hay casos con número de pisos y cuartos, no enteros.
- Se establece un filtro para eliminar variables explicativas que estén altamente relacionadas. Previniendo de esta forma un posible sobreajuste y variables redundantes.
- Se crean tres variables del tipo dicotómicas que identifican si la casa fue renovada alguna vez, si posee vista al mar y si posee alguna habitación por debajo del nivel del suelo, además, se crea una variable discreta con la edad en años de la casa a la fecha de venta.
- Se convierten a factor las variables dicotómicas creadas en el paso anterior.
- Se eliminar los registros con inconsistencias observados en el análisis exploratorio de los datos.
- A partir de la variable fecha se extraen distintos features para usarlos como variables explicativas.
- Se remueve la variable fecha.
- Se transforman a dummy todas las variables de tipo factor en los datos.
recipe <- recipe(price ~ ., data = train_set) %>%
  update_role(id, new_role = "id variable") %>%
  step_mutate_at(date, fn = as_date) %>%
  step_mutate_at(bedrooms, floors, fn = round) %>%
  step_corr(all_numeric_predictors(), threshold = 0.90) %>%
  step_mutate(
    is_renovated = if_else(yr_renovated == 0, "No", "Yes"),
    waterfront = if_else(waterfront == 0, "No", "Yes"),
    house_age = if_else(year(date) - yr_built < 0, 0, year(date) - yr_built),
    have_basement = if_else(sqft_basement == 0, "No", "Yes")
  ) %>%
  step_string2factor(is_renovated, waterfront, have_basement, levels = c("Yes", "No")) %>%
  step_filter(!(bedrooms %in% c(33, 0)), bathrooms != 0) %>%
  step_rm(date) %>%
  step_dummy(all_nominal_predictors())
A continuación, el resultado del pre-procesamiento:
Rows: 17,276
Columns: 23
$ id               <fct> 5631500400, 1321400060, 2008000270, 2414600…
$ bedrooms         <dbl> 2, 3, 3, 3, 2, 3, 5, 2, 3, 4, 3, 3, 3, 4, 3…
$ bathrooms        <dbl> 1.00, 2.25, 1.50, 1.00, 1.00, 1.00, 2.50, 1…
$ sqft_living      <dbl> 770, 1715, 1060, 1780, 1200, 1250, 2270, 10…
$ sqft_lot         <dbl> 10000, 6819, 9711, 7470, 9850, 9774, 6300, …
$ floors           <dbl> 1, 2, 1, 1, 1, 1, 2, 1, 2, 1, 1, 1, 1, 2, 2…
$ view             <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0…
$ condition        <dbl> 3, 3, 3, 3, 4, 4, 3, 3, 5, 2, 4, 3, 3, 3, 3…
$ grade            <dbl> 6, 7, 7, 7, 7, 7, 8, 7, 6, 7, 6, 6, 7, 7, 8…
$ sqft_above       <dbl> 770, 1715, 1060, 1050, 1200, 1250, 2270, 10…
$ sqft_basement    <dbl> 0, 0, 0, 730, 0, 0, 0, 0, 0, 330, 360, 0, 0…
$ yr_built         <dbl> 1933, 1995, 1963, 1960, 1921, 1969, 1995, 1…
$ yr_renovated     <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0…
$ zipcode          <dbl> 98028, 98003, 98198, 98146, 98002, 98003, 9…
$ lat              <dbl> 47.7379, 47.3097, 47.4095, 47.5123, 47.3089…
$ long             <dbl> -122.233, -122.327, -122.315, -122.337, -12…
$ sqft_living15    <dbl> 2720, 2238, 1650, 1780, 1060, 1280, 2240, 1…
$ sqft_lot15       <dbl> 8062, 6819, 9711, 8113, 5095, 8850, 7005, 8…
$ price            <dbl> 180000, 257500, 291850, 229500, 189000, 230…
$ house_age        <dbl> 82, 19, 52, 55, 93, 46, 19, 29, 73, 46, 55,…
$ waterfront_No    <dbl> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
$ is_renovated_No  <dbl> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
$ have_basement_No <dbl> 1, 1, 1, 0, 1, 1, 1, 1, 1, 0, 0, 1, 1, 1, 1…
Especificación de Modelos
Para este análisis en concreto, se utilizan cuatro modelos o algoritmos. El primero será el fiel caballo de batalla conocido como regresión lineal multivariante, amado por muchos debido a su fácil interpretabilidad, pero también odiado por tantos debido a sus innumerables limitaciones. Además, se ajustarán también los algoritmos de k vecinos cercanos, bosque aleatorio y XGboost.
La regresión lineal multivariante es un modelo ampliamente utilizado en el análisis de datos debido a su capacidad para analizar múltiples variables predictoras y su relación con la variable objetivo. Aunque tiene sus limitaciones, como la suposición de linealidad y la sensibilidad a los valores atípicos, sigue siendo una herramienta útil en la comprensión de las relaciones entre las variables.
Por otro lado, los k vecinos cercanos es un algoritmo de aprendizaje automático no paramétrico que se basa en la idea de que los ejemplos similares tienden a tener resultados similares. Este algoritmo clasifica o regresa un valor basándose en los k ejemplos más cercanos en el conjunto de datos de entrenamiento. Es una técnica sencilla pero efectiva, especialmente cuando se tienen conjuntos de datos pequeños.
El bosque aleatorio es otro algoritmo popular que utiliza múltiples árboles de decisión para realizar predicciones. Cada árbol se entrena con una muestra aleatoria del conjunto de datos y luego se combinan las predicciones de todos los árboles para obtener una predicción final. Este enfoque reduce el sobreajuste y mejora la precisión de las predicciones.
Finalmente, XGboost es un algoritmo de aprendizaje automático basado en árboles de decisión que se ha vuelto muy popular debido a su eficiencia y precisión. Utiliza un enfoque de impulso para mejorar gradualmente la precisión del modelo mediante la adición de nuevos árboles. Es especialmente útil en conjuntos de datos grandes y complejos.
# Regresión lineal
glm_spec <- linear_reg(engine = "lm")

# Bosque Aleatorio
rf_spec <- rand_forest(trees = 500) %>%
  set_engine("ranger", num.threads = 7, importance = "impurity") %>%
  set_mode("regression")

# XGboost
xg_spec <- boost_tree(mode = "regression", engine = "xgboost", trees = 1000)

# KNN
knn_spec <- nearest_neighbor(mode = "regression", engine = "kknn")
Rendimiendo en validación cruzada
A continuación, se procede a realizar el entrenamiento de los modelos en la validación cruzada. Para medir el rendimiento de los modelos se hará uso del error cuadrático medio o rmse por sus siglas en inglés y del coeficiente de determinación. Además, de un diagrama de dispersión para poder ver visualmente la concordancia de los valores predecidos con los reales.
Se busca encontrar el modelo que minimiza el error cuadrático medio y por otro lado, que maximice el coeficiente de determinación.
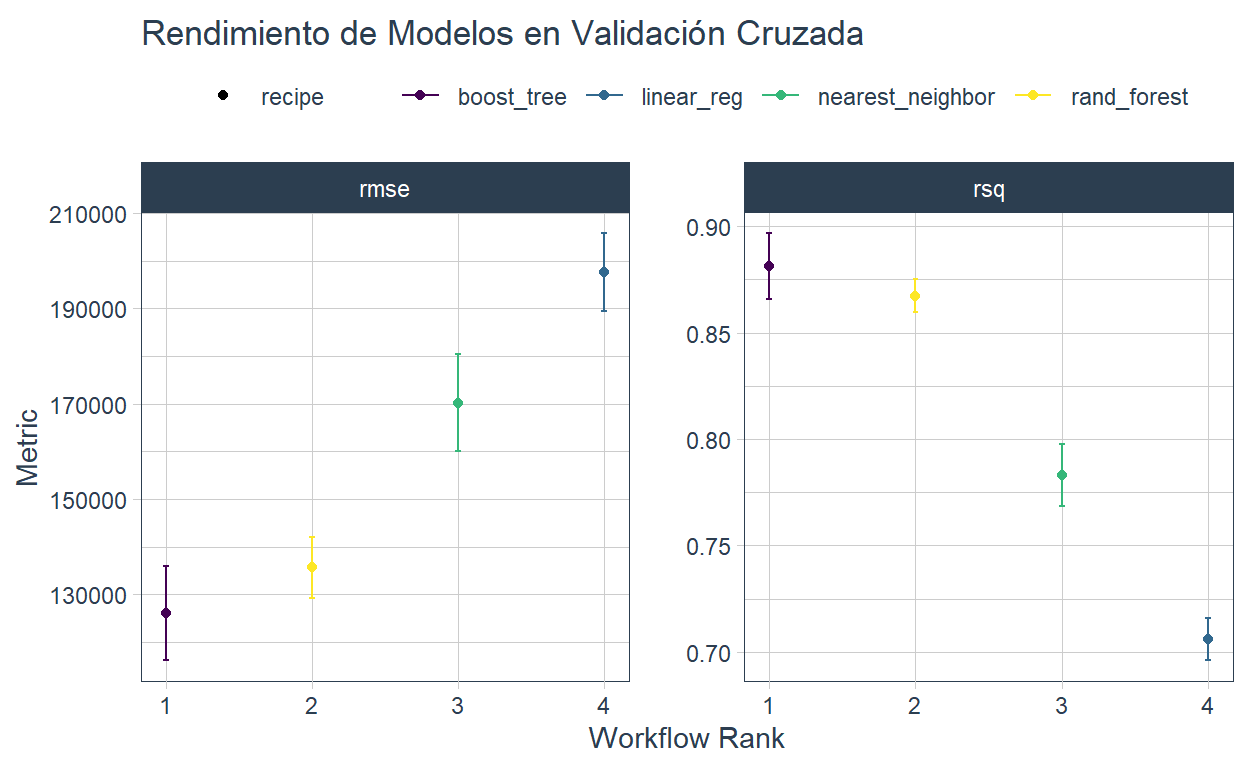
El modelo que logra minimizar el error cuadrático medio es e XGBoost, además, maximiza el \(R^{2}\) con casi un 90%, lo que indica que el modelo XGBoost explica aproximadamente el 90% de la variabilidad observada en los precios de venta en la validación cruzada. En función del error cuadrático medio, el segundo mejor modelo sería el algoritmo de K vecinos. Sin embargo, en cuanto al \(R^{2}\), este algoritmo se posiciona en tercer lugar, mientras que el algoritmo de Bosque Aleatorio proporciona un \(R^{2}\) mayor. Por último, en ambas métricas, el peor modelo es la regresión lineal multivariante.
A continuación, se visualizan los datos predichos vs los observados para cada modelo:
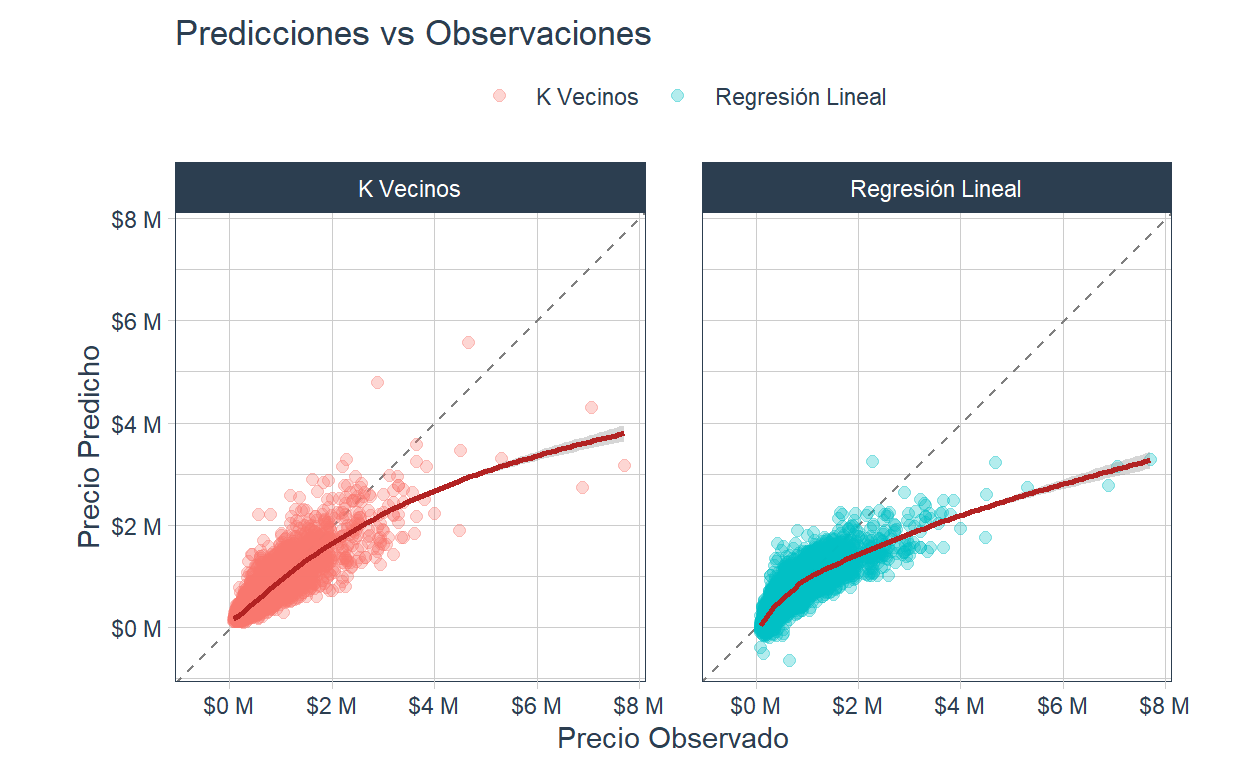
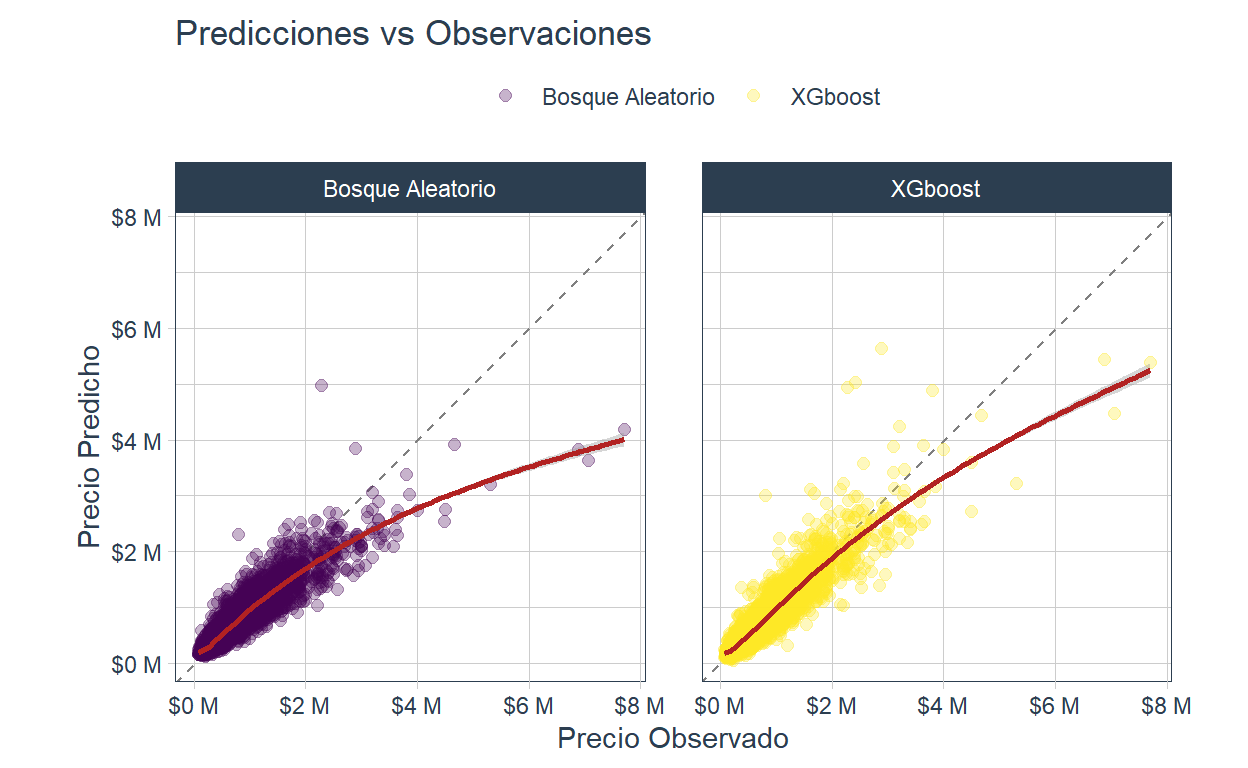
Por otro lado, el modelo XGBoost se destaca como el mejor en términos del error cuadrático medio, lo que indica que tiene una mayor precisión en la predicción de los precios de venta en comparación con otros modelos. Sin embargo, es importante tener en cuenta que incluso el modelo XGBoost parece que sobrestima el valor de cierto conjuntos de casas.
A continuación, se detalla el resultado de los modelos en la validación cruzada. Se incluyen además del error cuadratico medio y el coeficiente de terminación, el error absoluto medio y error medio porcentual absoluto:
| Modelo | mae | mape | rmse | rsq |
|---|---|---|---|---|
| XGboost | 68.684 | 13,17% | 126.051 | 88,14% |
| Bosque Aleatorio | 72.222 | 13,76% | 135.607 | 86,74% |
| K Vecinos | 92.402 | 17,15% | 170.203 | 78,29% |
| Regresión Lineal | 124.741 | 25,45% | 197.629 | 70,59% |
Se selecciona como modelo final el XGboost por sus buenos resultados en las distintas métricas.
Rendimiento en conjunto de prueba
A continuación, se emplea el modelo seleccionado en los datos de prueba para ver su performance final, ciertamente estos resultados pueden ser mejorados realizando un tuneo de los hiperparámetros de los modelos de ML pero esto se hará en análisis posteriores.
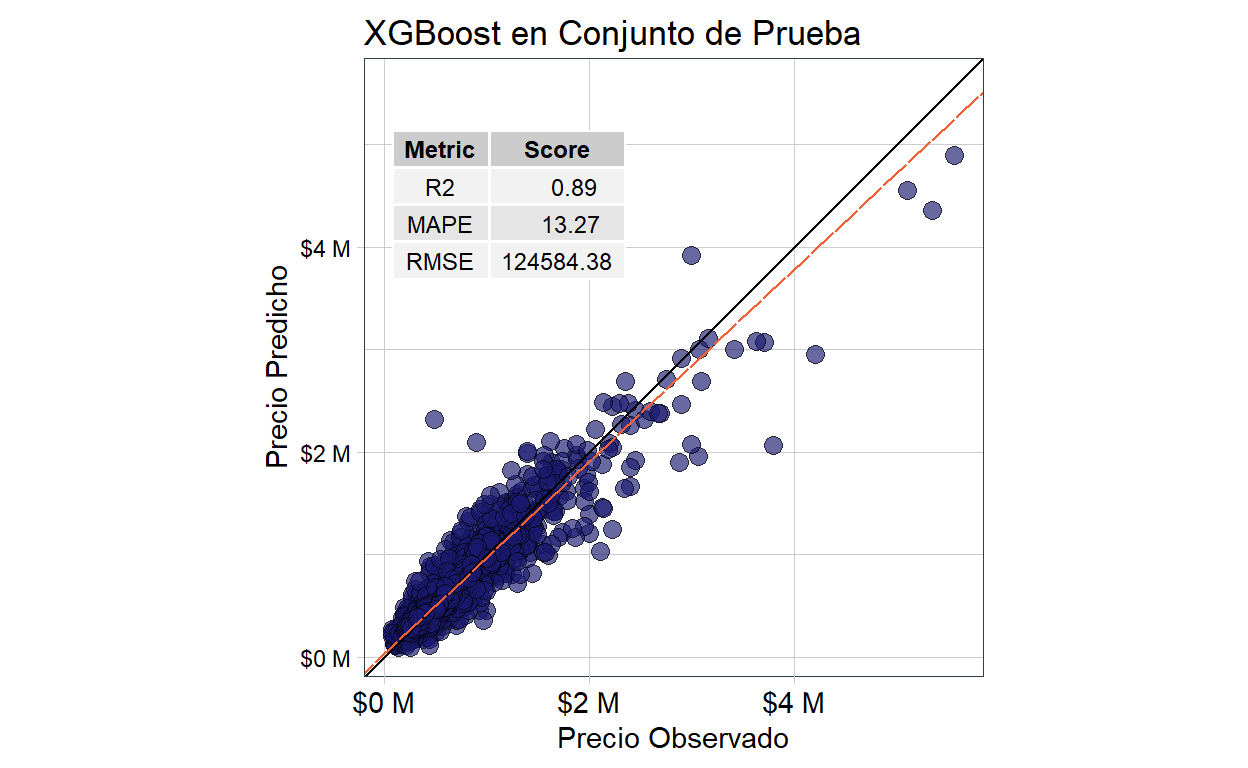
En el conjunto de prueba, el modelo XGBoost otorga un \(R^{2}\) del 89%, lo que implica que el modelo explica el 89% de la variabilidad observada en los precios de venta. Además, se obtiene un error porcentual absoluto del 13,27%, indicando que los valores predichos varían en dicha proporción con respecto a los valores reales. El resultado de estas métricas es muy importante para considerar cuando este modelo sea empleado para predecir.
Importancia de las Variables
A continuación, se visualiza el valor del score de importancia de cada variable en el modelo XGboost:
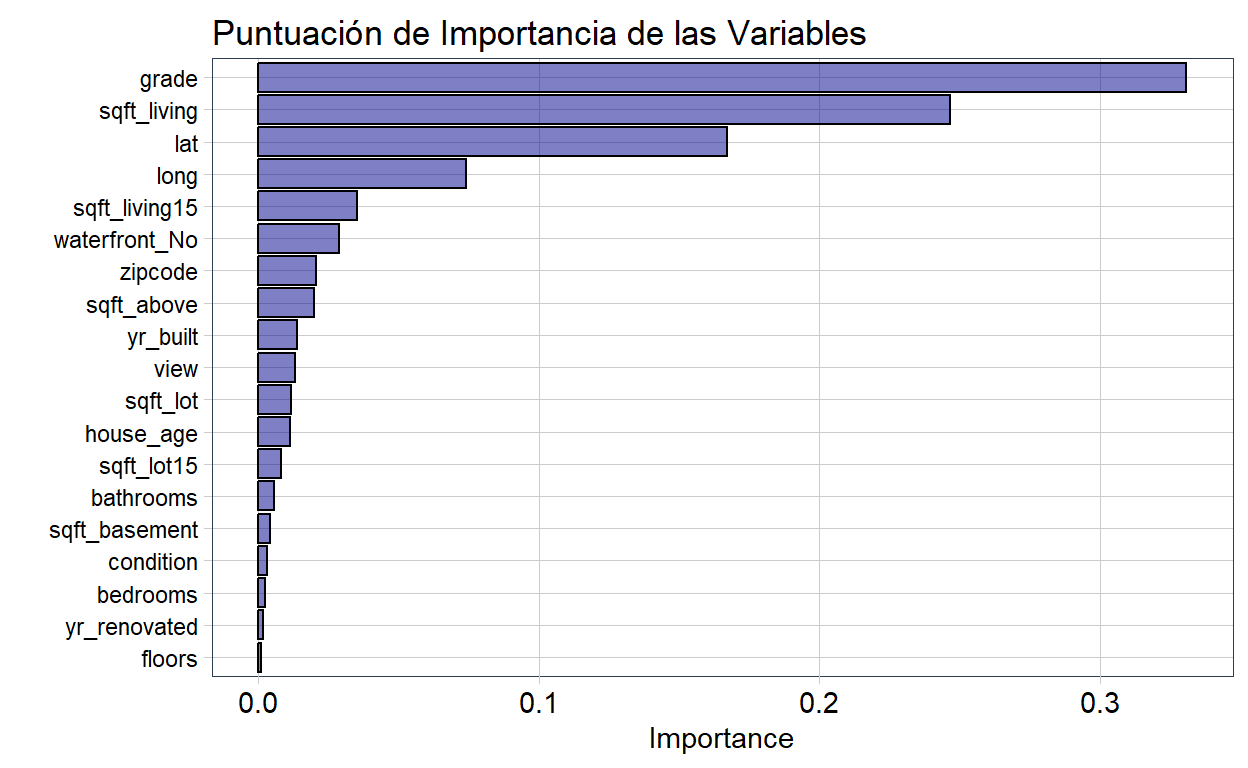
Del gráfico anterior se puede concluir que el nivel de calidad de construcción de la casa y el número de pies cuadrados del espacio habitable son las principales variables para predecir el valor de venta de una casa. Además, parece que la ubicación geográfica tiene un alto grado de impacto, ya que después de las variables antes mencionadas, siguen la latitud y longitud de ubicación de la casa.