Introducción
Los seguros de salud son los productos de seguros más comercializados y demandados por la población, debido a la importancia de contar con una cobertura adecuada para hacer frente a futuros gastos médicos y hospitalarios. Esta demanda ha llevado a que exista una gran variedad de ofertas en el mercado, con diferentes coberturas y condiciones, lo que brinda a los consumidores la posibilidad de elegir el seguro que mejor se adapte a sus necesidades.
En este blog, se presenta una propuesta de tarificación para un Seguro de Salud Individual, basada en la teoría de los Modelos Lineales Generalizados (GLM). Estos modelos son una herramienta estadística que permite analizar y predecir la relación entre variables, en este caso, la relación entre las características del asegurado y la prima del seguro. Al utilizar los GLM, las compañías de seguros pueden determinar de manera más precisa la prima que deben cobrar a cada asegurado, teniendo en cuenta factores como la edad, el sexo, la ubicación geográfica y otros datos relevantes. Esto permite una tarificación más justa y equitativa, donde cada asegurado paga una prima acorde a su perfil de riesgo.
El Seguro de Salud Individual tiene como objetivo cubrir los gastos médicos y hospitalarios que pueda requerir el asegurado en caso de accidente o enfermedad. Esto incluye consultas médicas, medicamentos, hospitalización, cirugías y otros tratamientos necesarios para la recuperación de la salud. Al contar con un seguro de salud, el asegurado puede tener la tranquilidad de que estará protegido ante cualquier eventualidad y podrá acceder a los servicios médicos necesarios sin preocuparse por los altos costos que puedan implicar.
Prima de Riesgo
La prima de riesgo es un concepto fundamental en los productos de seguros, ya que representa el monto que las compañías aseguradoras deben cobrar para poder dar cobertura y afrontar los posibles siniestros de los asegurados. Esta prima se determina considerando dos componentes clave: la frecuencia y la severidad.
La frecuencia se refiere al número promedio de siniestros atendidos a la población asegurada. Es decir, cuántas veces ocurren los siniestros en un determinado período de tiempo. Por otro lado, la severidad se refiere al monto promedio del costo de dichos siniestros. Es decir, cuánto dinero se requiere para cubrir los gastos asociados a cada siniestro.
La prima de riesgo se obtiene multiplicando la frecuencia por la severidad. Este cálculo nos da una estimación del costo total de todos los siniestros que pueden ocurrir en un período determinado y cómo se distribuye ese costo entre la población asegurada. A continuación, se expresa la prima de riesgo es terminos matemáticos:
\(\pi = E(S) = E(N)\times E(Y)\)
- Donde:
- \(\pi\): Prima pura anual.
- \(E(N)\): Frecuencia anual de siniestros.
- \(E(Y)\): Costo promedio de un siniestro.
Datos
Los datos en estudio son los siniestros ocurridos en el portafolio de Salud Individual de una compañía aseguradora durante los años 2021-2022. El objetivo de este estudio es analizar y evaluar la frecuencia y severidad de los siniestros que han afectado la cobertura básica (Hospitalización y Cirugía) del producto.
Para garantizar la consistencia en el análisis, se han establecido criterios de inclusión específicos. Solo se considerarán los reclamos de pólizas establecidas en dólares norteamericanos ($). Con el fin de enfocar el estudio en los aspectos médicos y quirúrgicos, se ha decidido excluir los siniestros relacionados con maternidad y atención médica primaria.
Factores de Riesgo
Los factores de riesgo son variables empleadas para estimar la relación existente entre los distintos subgrupos dentro de la cartera de asegurados. En la literatura, comúnmente se clasifican los factores de riesgo en:
- Factores que exhiben características del asegurado.
- Factores que detallan el objeto a ser asegurado.
- Factores de las propiedades geográficas donde se encuentre el asegurado o objeto.
La selección de los factores de riesgo se basa en un análisis exploratorio de la frecuencia y la severidad de los siniestros. Durante este análisis, se evalúan las variables que representan los atributos de la población asegurada y la póliza de salud que poseen. Algunas de las variables importantes incluyen el sexo del asegurado, la edad, la ubicación geográfica del lugar de residencia, la suma asegurada de la póliza y el estatus de la póliza (nueva o renovada).
Análisis Exploratorio
Exposición al Riesgo
La exposición al riesgo de un asegurado se determina mediante el expuesto. Un expuesto es la unidad básica de riesgo que mide la exposición a una pérdida, en el contexto de Seguros de Salud hace referencia a un asegurado que estuvo asegurado durante un determinado período de tiempo.
El expuesto al riesgo de un asegurado se pueda calcular con la siguiente formula:
\(M_{x} = \frac{min\left(max\left(min\left(Fhr, Ffe \right),Fie\right),Ffe\right) - min\left(min\left( max\left(Fdr,Fie\right),Ffe\right),Ffe\right)}{\textrm{vigencia del periodo en estudio en dias}}\)
- Donde:
- \(Fhr:\) Fecha hasta del recibo.
- \(Fdr:\) Fecha desde del recibo.
- \(Fie:\) Fecha de inicio del período en estudio.
- \(Ffe:\) Fecha fin del período en estudio.
A continuación, se visualiza la distribución de los expuestos en la cartera:
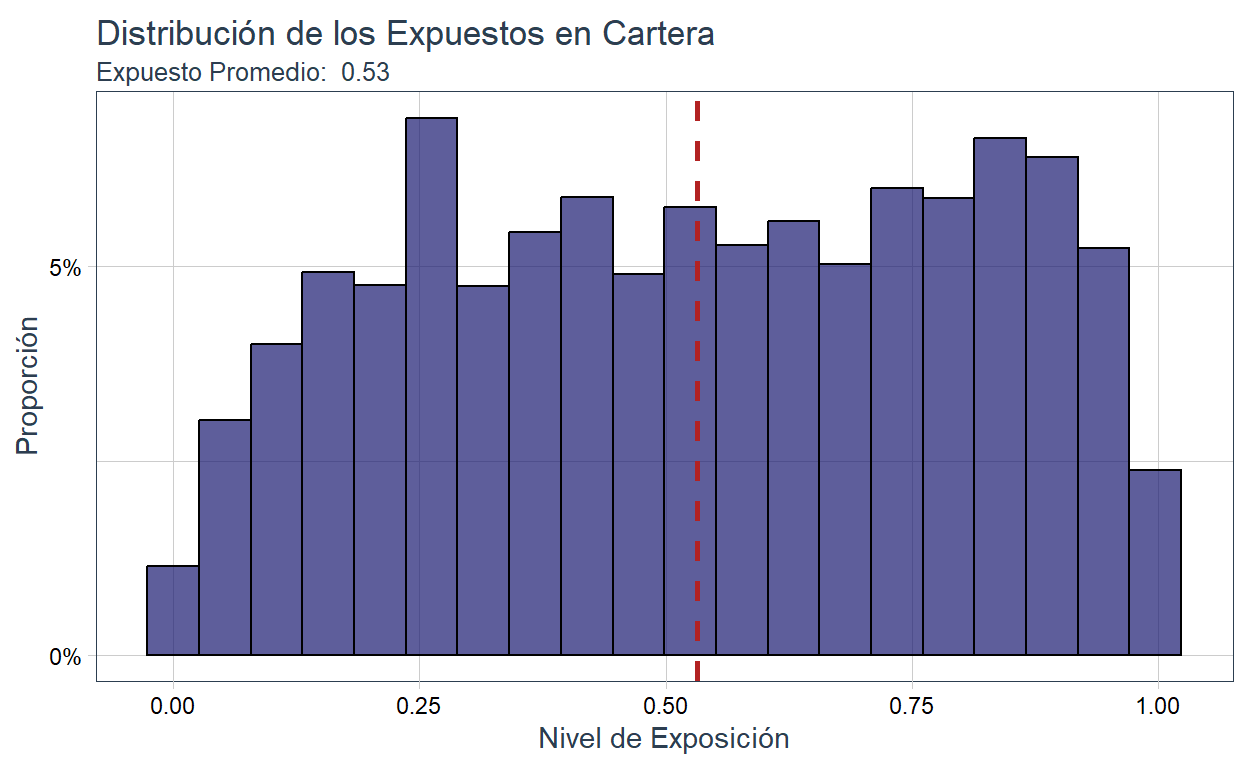
La exposición promedio de la cartera es de alrededor del 53%. Esto indica que, al momento de realizar este estudio, en promedio las pólizas habían transcurrido un 53% de su vigencia. Este dato es crucial para comprender la distribución temporal de las pólizas en la cartera de seguros y evaluar el riesgo asociado a las mismas.
Ahora, es fundamental observar si existe alguna variación entre las pólizas nuevas y las renovadas. Esta distinción nos permitirá entender mejor la dinámica de la cartera y su evolución a lo largo del tiempo. Además, nos brindará información valiosa sobre la retención de clientes y la estabilidad de la cartera de seguros.
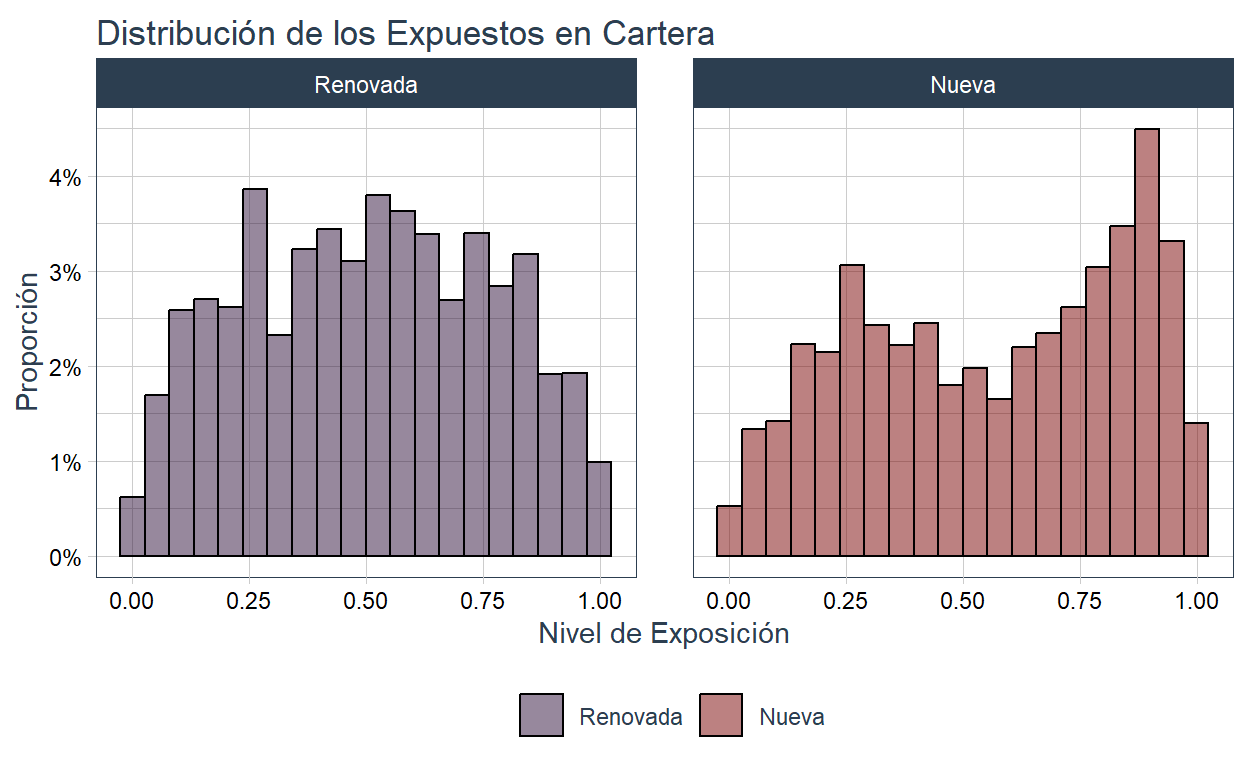
El número de expuestos en la cartera parece estar distribuido equitativamente entre pólizas nuevas y renovadas. Sin embargo, para tener una comprensión más completa de estas distribuciones, es importante analizar ciertas estadísticas como el promedio, la desviación estándar y el coeficiente de variación.
| Tipo de Póliza | Cantidad de Expuestos | Expuesto Promedio | Desviación Estándar | Coeficiente de Variación |
|---|---|---|---|---|
| Renovada | 13.739,54 | 0,50 | 0,26 | 52,02 |
| Nueva | 13.185,56 | 0,56 | 0,29 | 50,90 |
El expuesto promedio de las pólizas nuevas está es de aproximadamente 6% mayor que el de las pólizas renovadas. Además, podemos observar que la desviación estándar en las pólizas nuevas es de 0.29, lo que equivale al 29%. Esto indica que, en promedio, la exposición de los asegurados está un 29% por encima o por debajo del promedio.
Aunque la desviación estándar de las pólizas nuevas sea mayor que la de las renovadas, podría pensarse que la variabilidad en la distribución del expuesto es mayor en las nuevas. Sin embargo, dado que los promedios son diferentes, lo adecuado es utilizar una medida de dispersión relativa, como el coeficiente de variación. El coeficiente de variación de las pólizas renovadas es de 52.02 y el de las pólizas nuevas es de 50.90. Esto indica que existe una mayor variabilidad en los expuestos de las pólizas renovadas.
A continuación, se presentan varios gráficos que permiten analizar la concentración de los expuestos a través de las distintas variables de interés para el análisis.
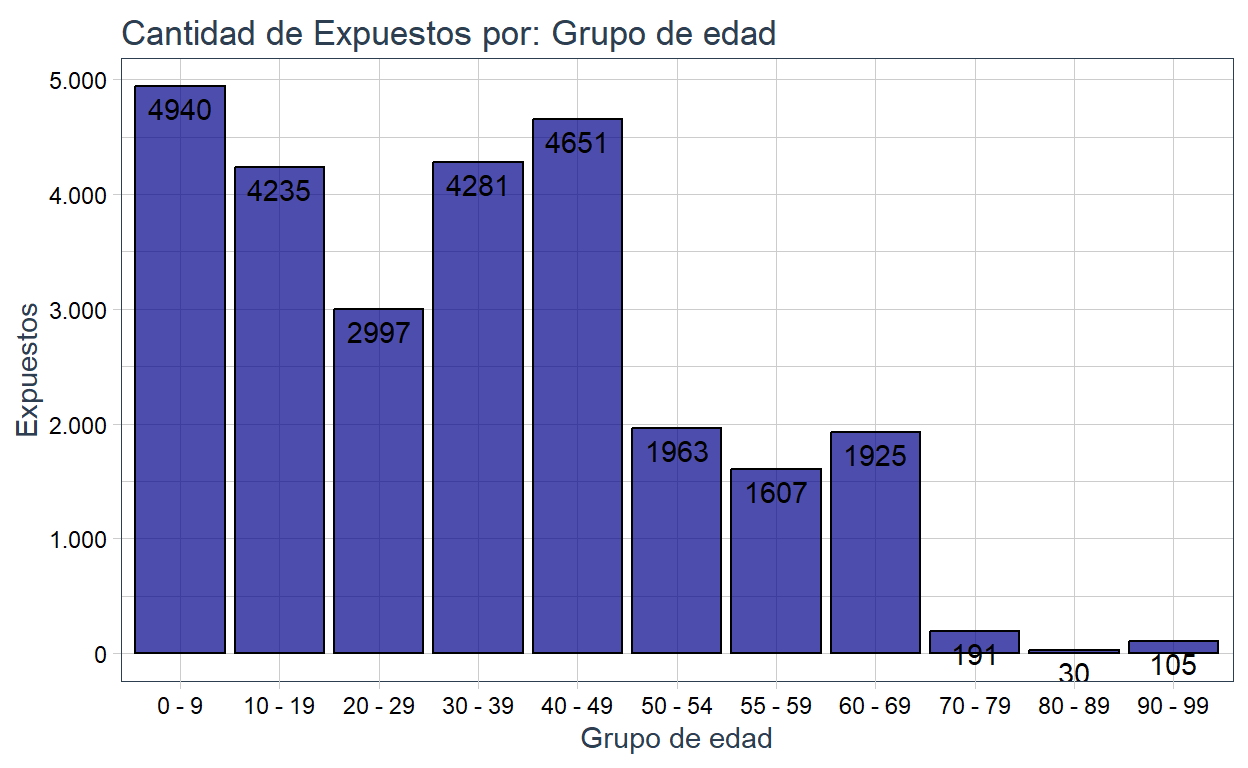
De acuerdo a los grupos etarios comúnmente empleados en el mercado asegurador, se puede observar que la mayor cantidad de expuestos se encuentra entre los 0 años y hasta los 49 años. La edad promedio de la cartera se ubica en 31 años, por lo que se puede considerar como una cartera relativamente joven.
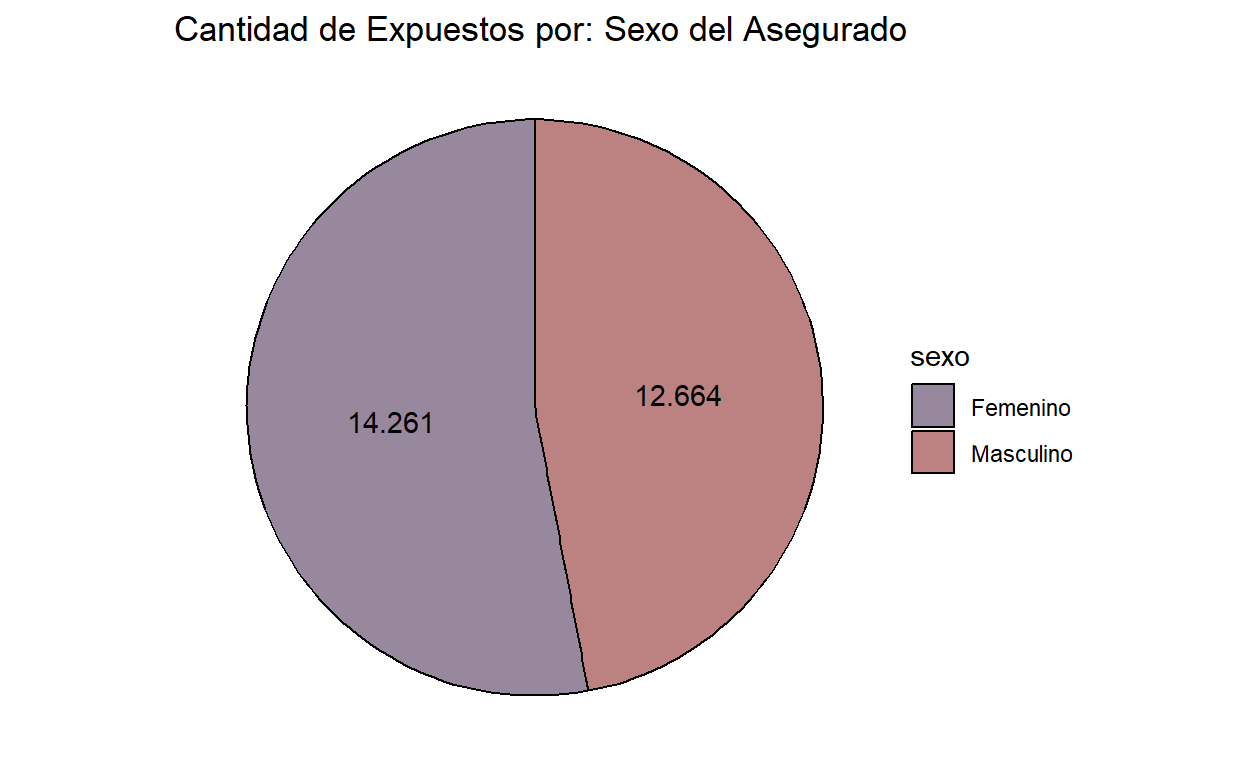
La cartera de la compañia asegurada esta compuesta por 14.261 mujeres expuestas y 12.664 hombres expuestos, la mujeres representan aproximadamente el 52% de los expuestos en la cartera.
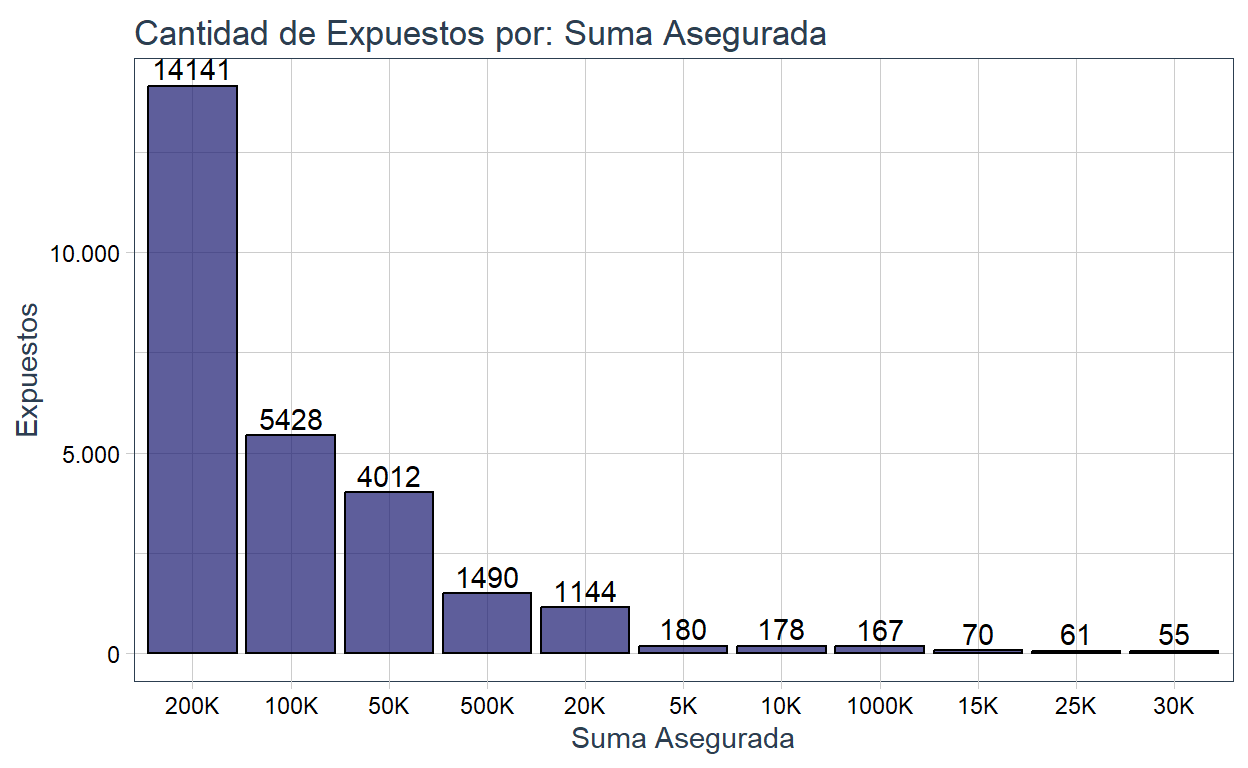
La suma asegurada de USD 200.000 tiene la mayor representación de expuestos en la cartera, con aproximadamente 14 mil expuestos, lo que porcentualmente equivale al 52% de la cartera. Esta cifra indica que un gran número de asegurados ha optado por una suma asegurada de USD 200.000, lo que puede reflejar una preferencia por una suma asegurada amplia pero no elevada.
En contraste, la suma asegurada de USD 1.000.000 es la de mayor valor en el portafolio de la compañía. Aunque esta cantidad representa un valor significativo, es importante destacar que, durante el período de estudio, su representación en la cartera es inferior al 1%. Esto sugiere que un número relativamente pequeño de asegurados ha optado por esta suma asegurada alta, lo cual puede estar relacionado con el costo de la prima y la percepción de riesgo asociada.
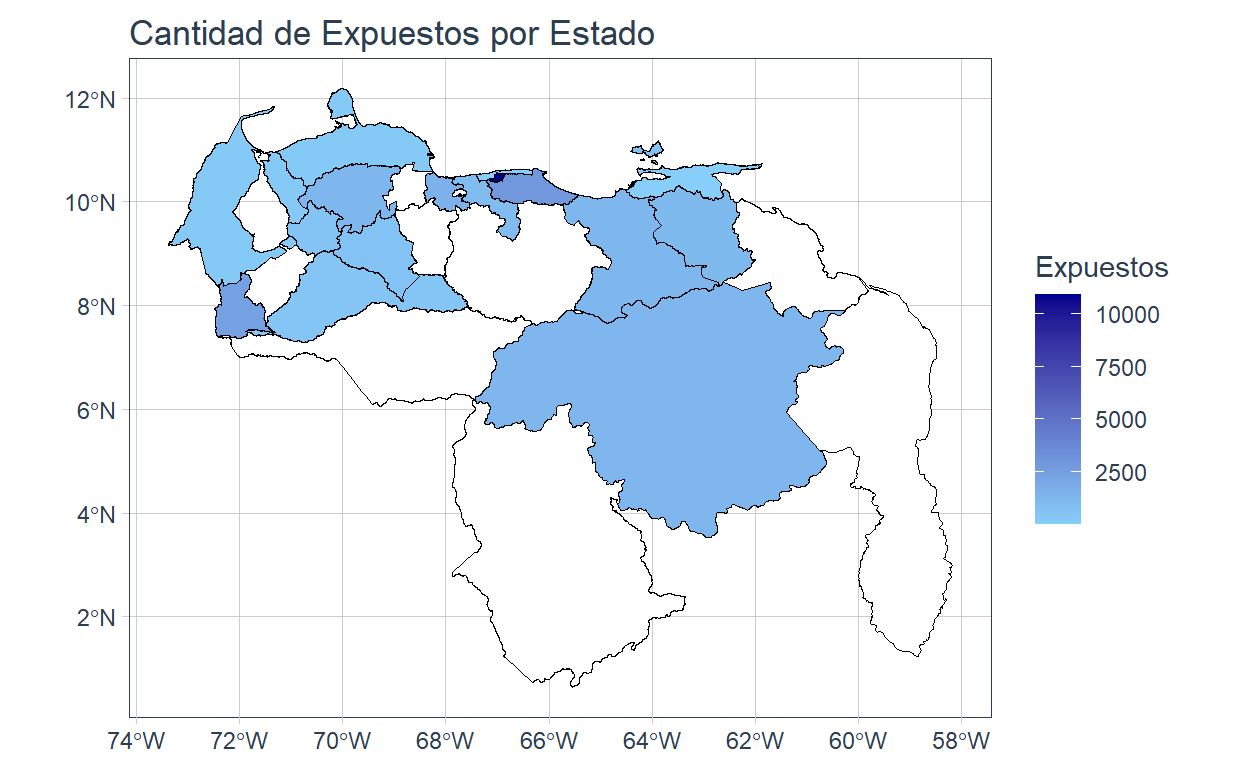
Por último, se presenta la concentración de los expuestos geográficamente:
| Estado | Cant. Expuesto | Distribución % |
|---|---|---|
| Distrito Capital | 10.924 | 40.57% |
| Miranda | 2.869 | 10.66% |
| Táchira | 2.376 | 8.83% |
| Carabobo | 1.514 | 5.62% |
| Bolívar | 1.251 | 4.65% |
| Lara | 1.230 | 4.57% |
| Anzoátegui | 1.219 | 4.53% |
| Monagas | 1.030 | 3.83% |
| Aragua | 931 | 3.46% |
| Portuguesa | 620 | 2.30% |
| Nueva Esparta | 602 | 2.24% |
| Trujillo | 511 | 1.90% |
| Merida | 492 | 1.83% |
| Barinas | 479 | 1.78% |
| Guarico | 345 | 1.28% |
| Zulia | 273 | 1.01% |
| Falcón | 251 | 0.93% |
| Vargas | 6 | 0.02% |
| Sucre | 1 | 0.00% |
La compañía aseguradora tiene mayor presencia a nivel de expuestos en la capital del país y en el estado Miranda, donde se concentra alrededor del 51% de los expuestos de la cartera. Esta concentración puede estar relacionada con la densidad poblacional, la actividad económica y otros factores que hacen que estos dos estados sean centros importantes para la compañía en términos de asegurados y oportunidades de negocio.
Por otro lado, es notable que en 9 estados del país la compañía no tiene presencia de asegurados. Esta ausencia puede representar tanto desafíos como oportunidades para la compañía. Por un lado, podría ser una señal de áreas geográficas subatendidas en las que la compañía podría expandir su presencia y llegar a nuevos clientes potenciales. Por otro lado, también podría requerir un análisis más detallado de las condiciones locales, las regulaciones y las preferencias de los consumidores en esos estados para comprender las razones detrás de esta ausencia y desarrollar estrategias efectivas para abordarla.
Frecuencia o Tasa de Uso
La frecuencia o tasa de uso es un indicador clave en el sector asegurador, ya que mide la tasa de reclamaciones y proporciona información valiosa sobre la utilización del servicio por parte de los asegurados. Esta métrica es fundamental para identificar tendencias, evaluar la eficacia de las políticas de cobertura y gestionar el riesgo de manera efectiva.
La tasa de uso se calcula utilizando la siguiente fórmula:
\(Frecuencia = \frac{N^{\circ} \; de \; reclamaciones}{N^{\circ} \; de \; expuestos}\)
- Donde:
- \(N^{\circ} \; de \; reclamaciones\): Corresponde a todos los siniestros pagados y pendientes de pago durante el período de estudio.
- \(N^{\circ} \; de \; expuestos\): Unidad básica de riesgo que mide la exposición a una pérdida.
Antes de analizar propiamente la tasa de uso de la cartera, es importante observar la distribución empírica de los reclamos:
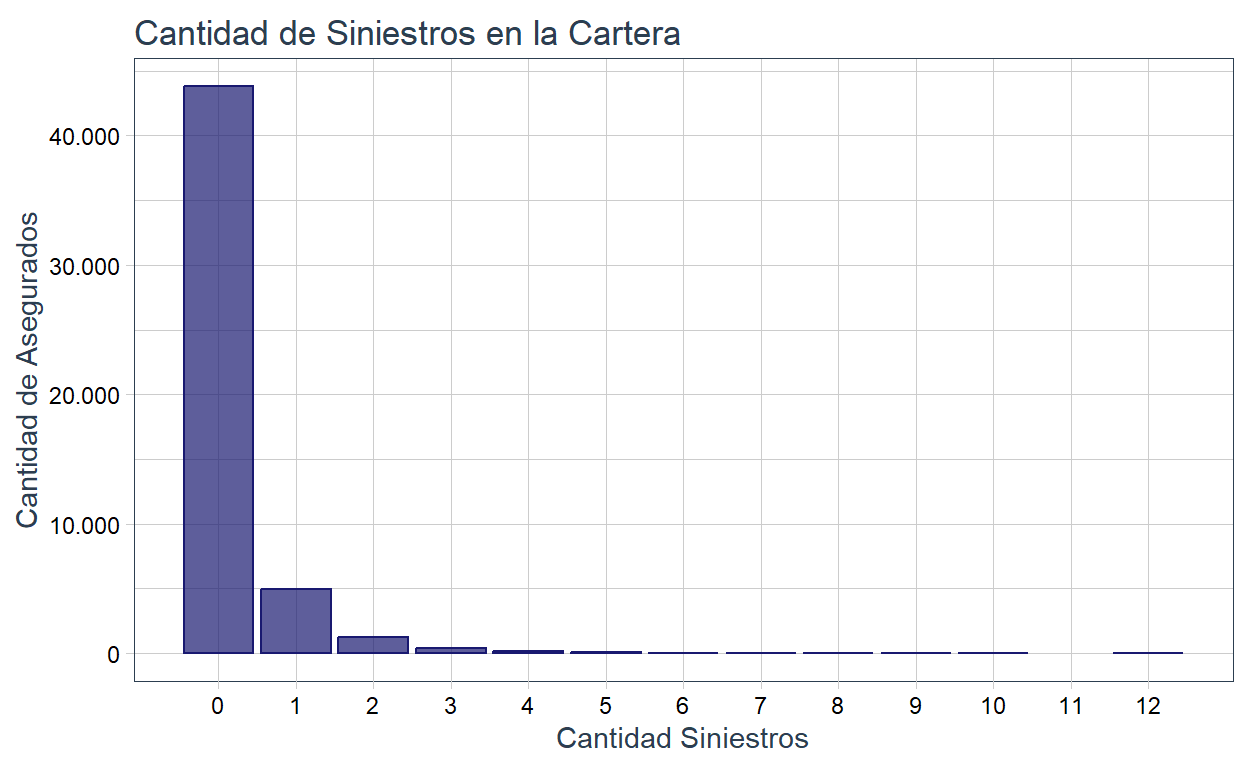
Se puede observar que se está en presencia de una distribución con un sesgo a la derecha o un sesgo positivo. Esto implica que la mayoría de los asegurados se agrupan en torno a la cola izquierda de la distribución, es decir, la mayoría presenta un solo siniestro o no presentaron siniestros. Sin embargo, se observan valores atípicos de asegurados con más de 5 siniestros, llegando incluso a 12 reclamos presentados durante el período de estudio. Estos asegurados con una gran cantidad de reclamos puede ser clasificados como valores atípicos.
Dado que la tasa de uso impacta directamente en la prima pura o de riesgo, es importante ver cómo se comporta este indicador de manera global en la cartera y segmentado por las distintas variables de interés o factores de riesgo:
| Cant. Expuestos | Cant. Siniestros | Tasa de Uso |
|---|---|---|
| 26.925 | 9.835 | 36.53% |
Tasa de utilización de la cartera es de aproximadamente el 37%.
A continuación, se evaluarán tendencias y patrones en la tasa de uso:
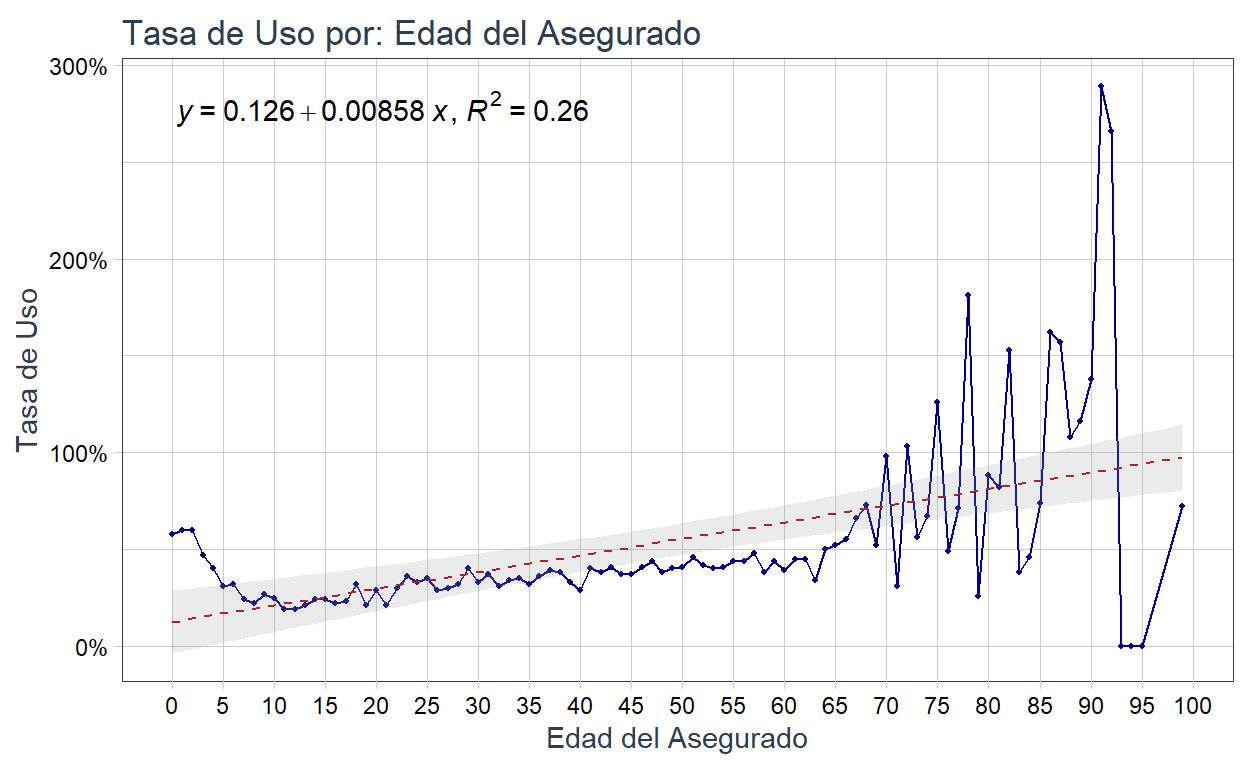
En la edad de los asegurados se observa una tendencia de crecimiento en la tasa de uso, la cual no parece ser lineal y seguir un comportamiento exponencial o polinómico. Es interesante observar cómo en las edades menores a 5 años se observan mayores tasas de uso que en la mayoría de las edades, siendo superadas a partir de los 70 años.
Si agrupamos la tasa de uso por rangos etarios:
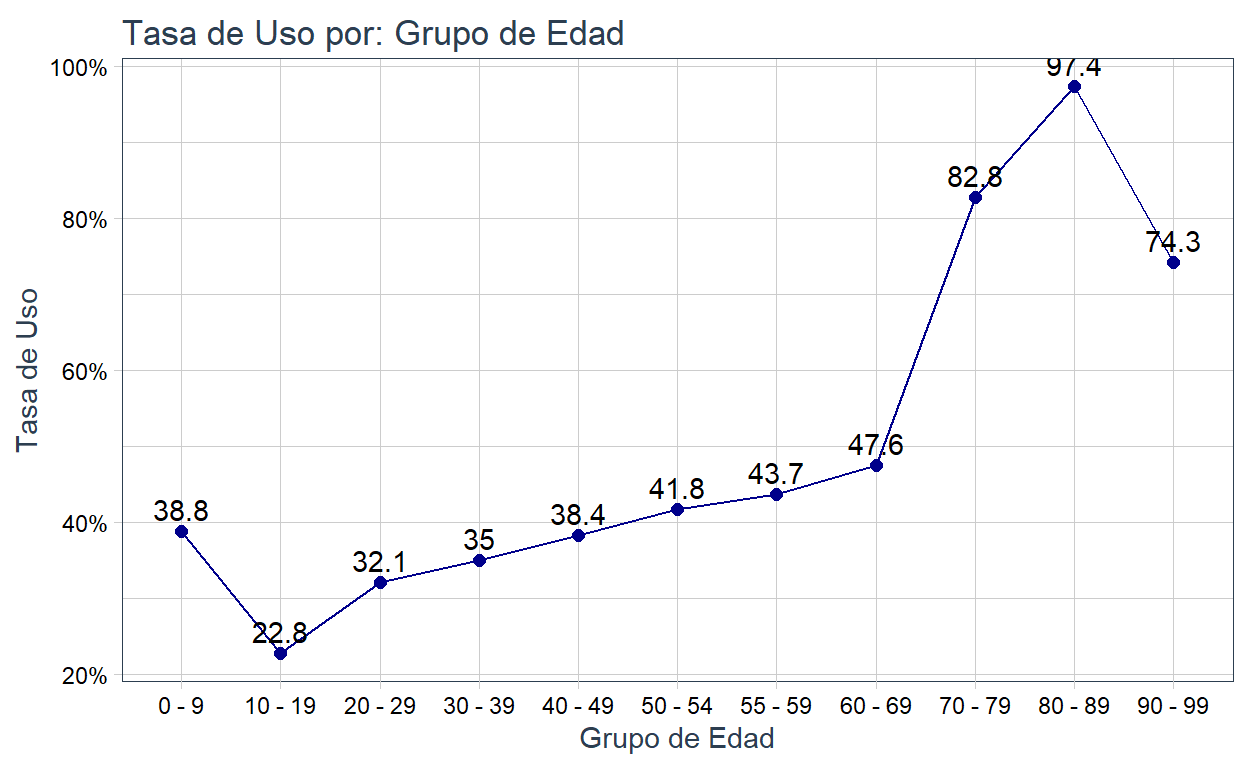
Las tasas de uso por grupo de edad varían entre el 22% y hasta el 97%, siendo el valor promedio 50%. El primer grupo de edad “0-9” presenta una mayor tasa de uso que los cuatro grupos siguientes, esto es interante y pudiera deberse a que en los primeros años de edad los humanos estamos más propensos a sufrir de enfermedades que requiera atención médica. Además, se obsera un incremento abrupto luego del rango de edad de “60-69”, sin embargo, a partir de este rango etario unicamente se concentran el 1% de los expuestos y por ser edades avanzadas se esperan altas tasas de reclamaciones.
A continuación, se ajusta un modelo de regresión lineal para explicar la tendencia observada:
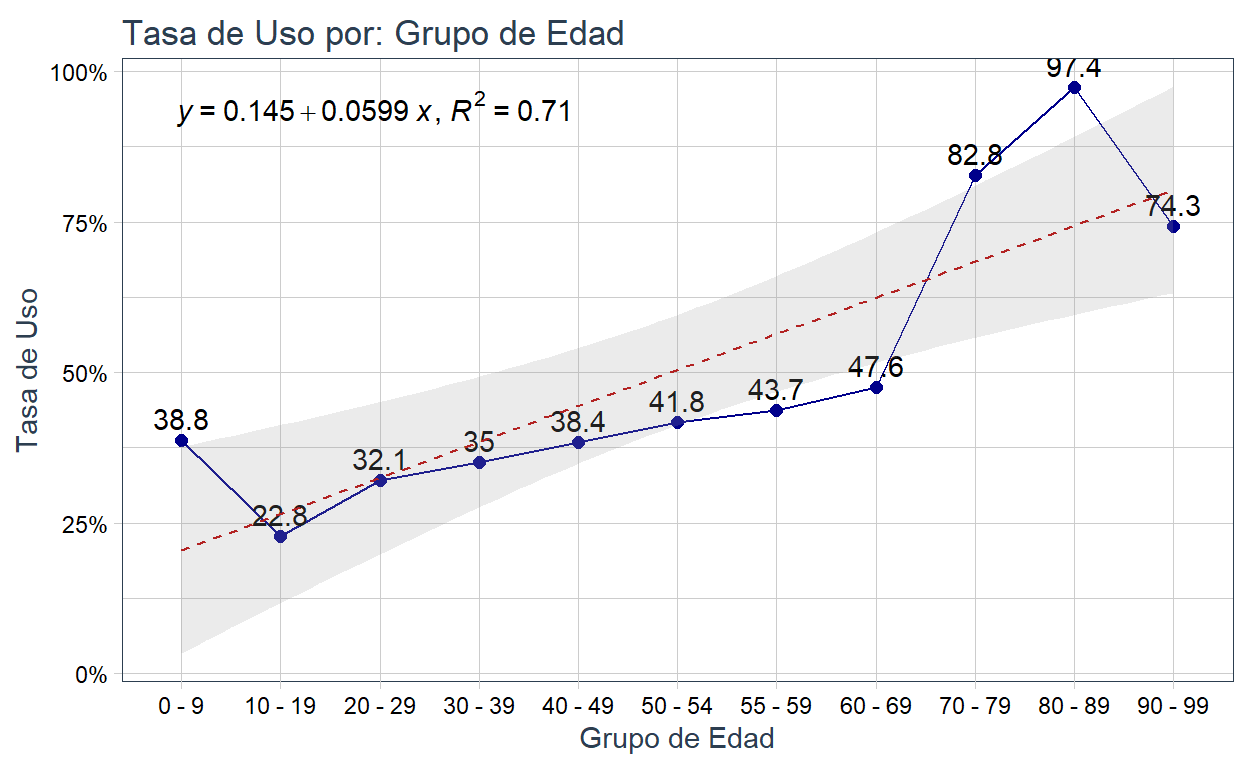
De acuerdo a los rangos de edad, podemos observar que un ajuste lineal otorga un \(R^{2}\) de aproximadamente el 0.71, lo que implica que el modelo de regresión ajustado puede explicar el 71% de la variabilidad observada en la tasa de uso por grupo de edad. Sin embargo, es importante considerar que un ajuste exponencial pudiera otorgar mejores resultados al suavizar las tasas de uso. Esto se debe a que un ajuste exponencial tiene la capacidad de capturar mejor un comportamiento no lineal en los datos, lo cual podría reflejar de manera más precisa los patrones de uso en función de la edad.
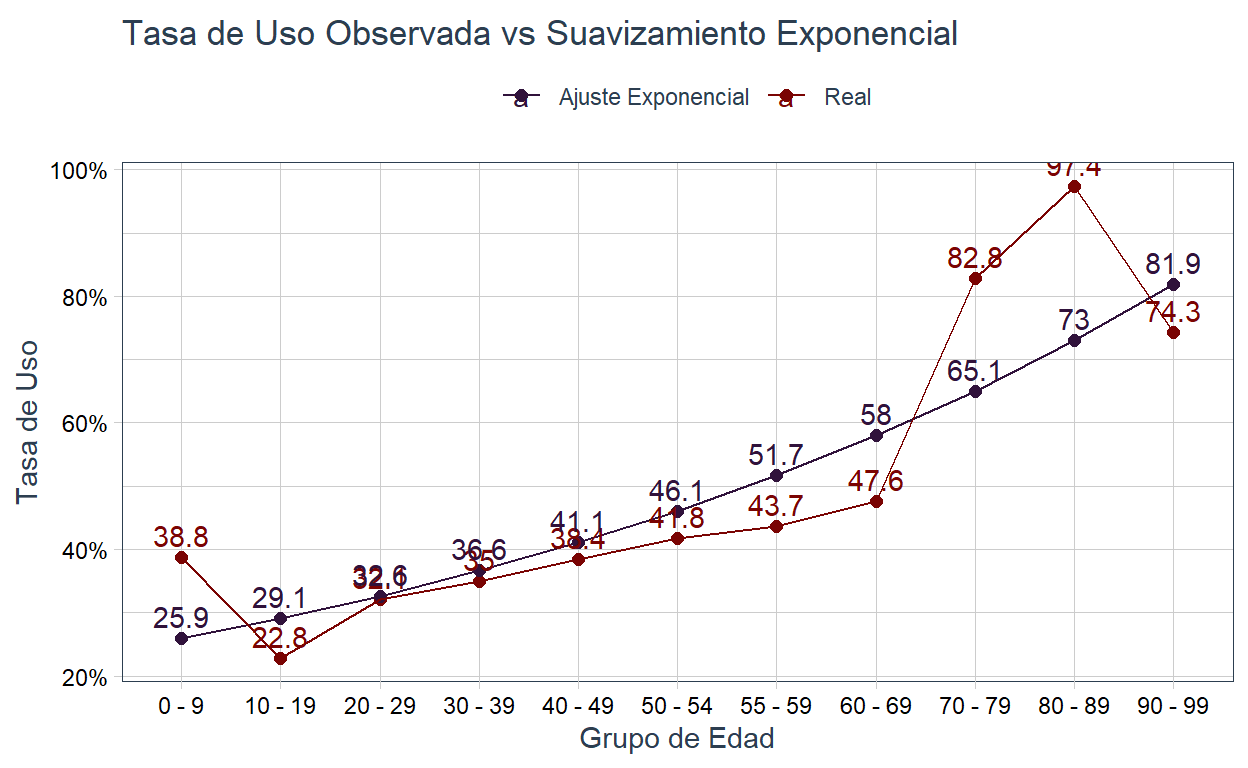
Un ajuste exponencial otorga un suavizamiento creciente de la tasa de uso que en la mayoría de los casos es mayor a la tasa de uso empírica. Este ajuste suele ser preferido para modelar la tasa de uso por rango etario dado que resulta en una tendencia pero suavizada de este indicador.
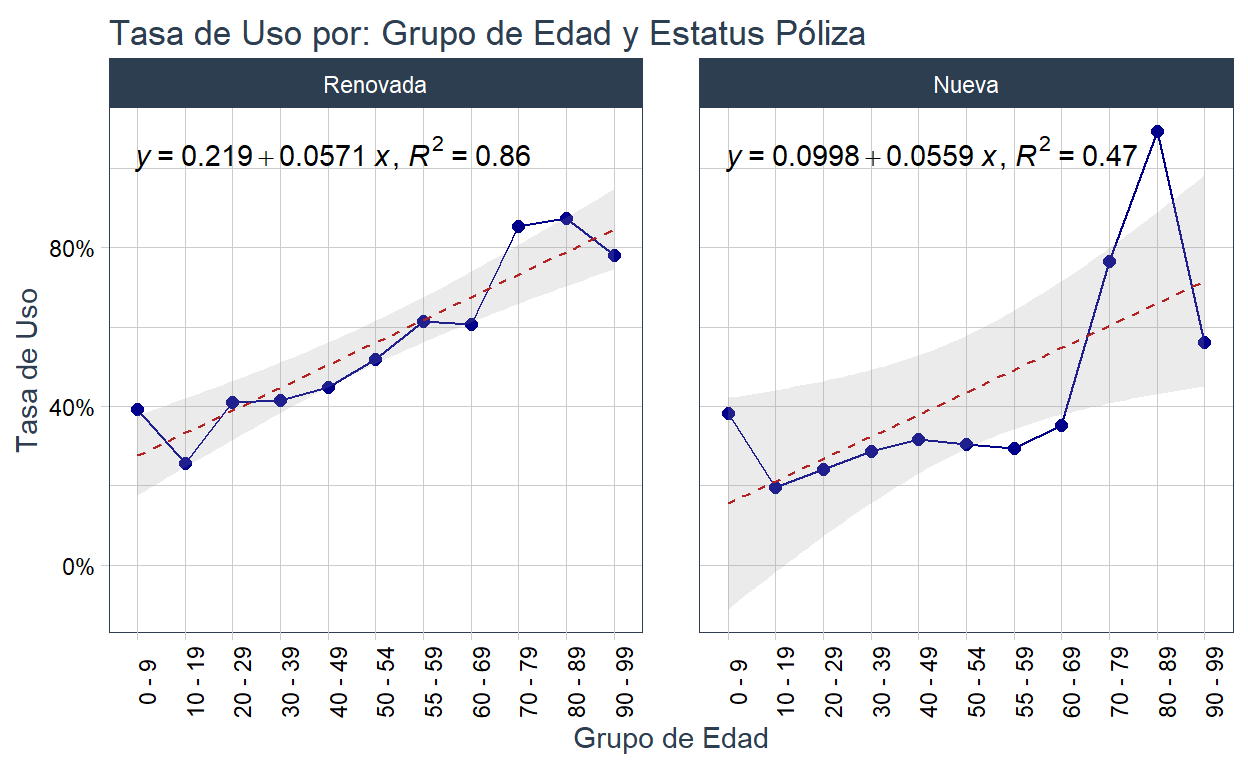
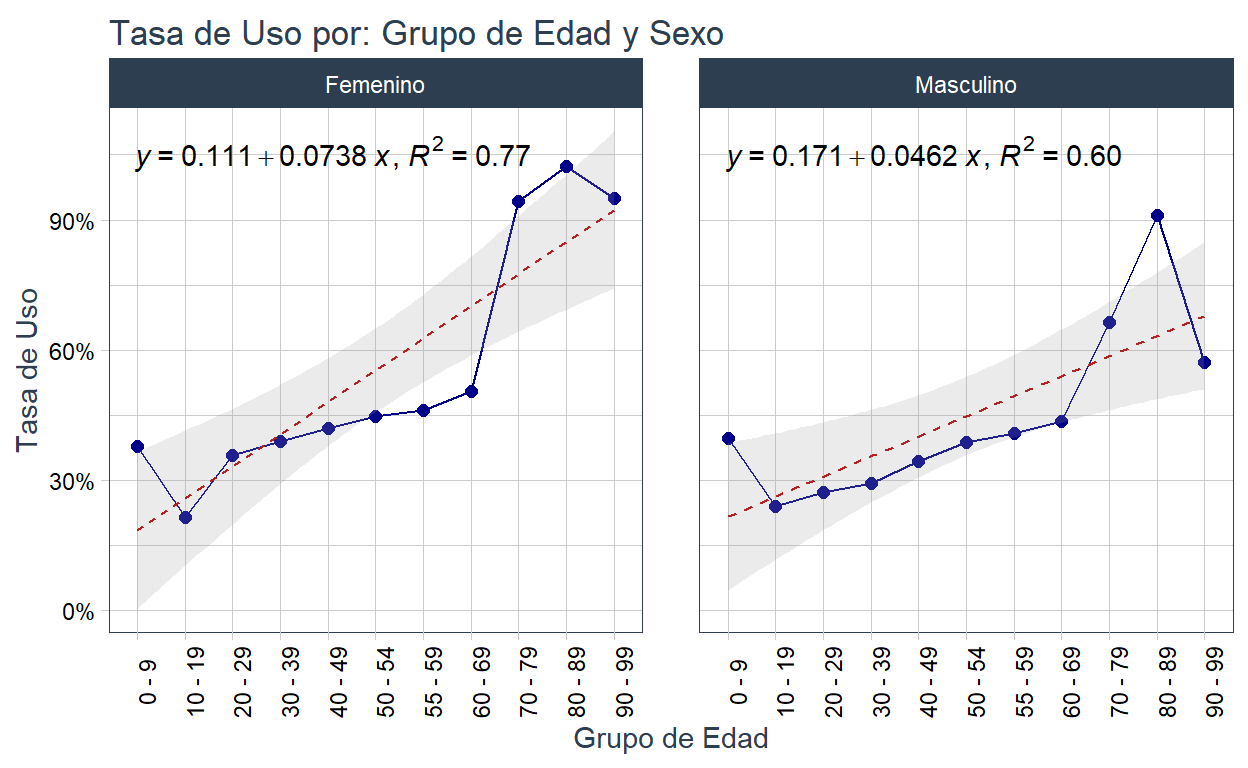
Para obtener un panorama más completo y comprensivo de la tasa de uso, es importante considerar variables adicionales. Por ejemplo, podemos analizar cómo el sexo del asegurado influye en la tasa de uso. Es posible que existan diferencias significativas entre hombres y mujeres en términos de la frecuencia con la que utilizan los servicios asegurados. Del mismo modo, el estatus de la póliza, como si es una póliza nueva o renovada, podría tener un impacto en la tasa de uso. Al incluir estas variables en el análisis, podemos obtener una visión más completa de los factores que influyen en la tasa de uso:
| Estatus Póliza | Cant. Expuestos | Cant. Siniestros | Tasa de Uso |
|---|---|---|---|
| Renovada | 13739.54 | 5890 | 42.87% |
| Nueva | 13185.56 | 3945 | 29.92% |
Se observa un mayor porcentaje de utilización del servicio en las pólizas de asegurados con más de un año de vigencia (renovadas) en la compañía. Esto puede deberse a que los asegurados que han renovado su póliza durante más de un año ya han cumplido los plazos de espera necesarios para poder utilizar el servicio de la compañía para cubrir ciertas patologías. Para el caso de las pólizas nuevas, un modelo de regresión lineal otorga un \(R^{2}\) elevado, sin embargo, como se comento anteriormente, un ajuste exponencial suele ser preferido.
| sexo del Asegurado | Cant. Expuestos | Cant. Siniestros | Tasa de Uso |
|---|---|---|---|
| Masculino | 12664.35 | 4294 | 33.91% |
| Femenino | 14260.75 | 5541 | 38.85% |
De acuerdo al sexo del asegurado, se observa que las mujeres presentan una tasa de uso de aproximadamente un 5% más que la de los hombres. Esta diferencia podría deberse a diversos factores, como diferencias en la búsqueda de atención médica y la prevalencia de ciertas condiciones de salud en cada grupo.
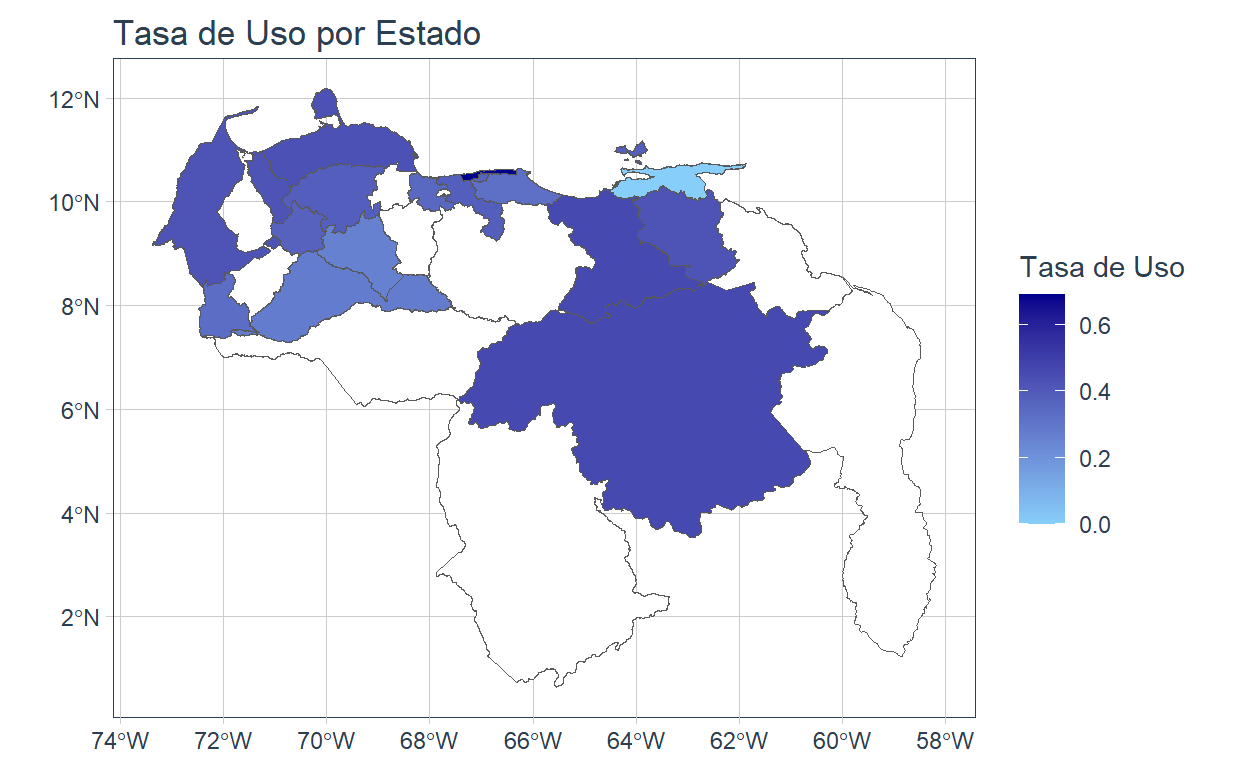
A continuación, se visualiza la tasa de uso geográficamente:
| estado | Expuestos | # Siniestros | Tasa de Uso |
|---|---|---|---|
| Vargas | 6 | 4 | 69.23% |
| Guarico | 345 | 166 | 48.11% |
| Anzoátegui | 1.219 | 564 | 46.28% |
| Bolívar | 1.251 | 570 | 45.55% |
| Falcón | 251 | 109 | 43.40% |
| Monagas | 1.030 | 431 | 41.85% |
| Zulia | 273 | 114 | 41.75% |
| Nueva Esparta | 602 | 230 | 38.19% |
| Aragua | 931 | 354 | 38.03% |
| Lara | 1.230 | 462 | 37.57% |
| Trujillo | 511 | 190 | 37.18% |
| Merida | 492 | 182 | 37.00% |
| Distrito Capital | 10.924 | 3930 | 35.98% |
| Carabobo | 1.514 | 523 | 34.54% |
| Táchira | 2.376 | 789 | 33.20% |
| Miranda | 2.869 | 919 | 32.03% |
| Barinas | 479 | 134 | 27.96% |
| Portuguesa | 620 | 164 | 26.46% |
Se puede observar que el estado Vargas presenta la mayor tasa de uso, sin embargo, únicamente se cuenta con 6 expuestos en dicho estado, esto sugiere una falta de masa crítica que dé significancia al resultado obtenido. Igualmente, se pueden distinguir otros estados con poca cantidad de expuestos o reclamos, así como otros con altas cantidades de estos indicadores. Puede ser beneficioso agrupar estos estados mediante técnicas de agrupación de cluster como el modelo k-medias, esto permitiría aumentar la capacidad de generalizar los riesgos en los modelos GLM y evitando modelar patrones más específicos.
Severidad
La severidad es el costo promedio por siniestro y su análisis otorga información relevante sobre el comportamiento de las pérdidas de la compañía y el impacto de los cambios en el manejo de reclamaciones. Al examinar la severidad de los siniestros, se pueden identificar patrones y tendencias que ayudan a comprender mejor los factores que contribuyen a los costos.
\(Severidad = \frac{Pérdidas \; Totales}{N^{\circ} \; de \; siniestros}\)
- Donde:
- \(Pérdidas \; Totales\): Corresponde a los costos que la compañía ha pagado o debe pagar por el concepto de siniestros presentados por los asegurados.
- \(N^{\circ} \; de \; siniestros\): Corresponde a todos los siniestros pagados y pendientes de pago durante el período de estudio.
Antes de analizar propiamente la severidad de la cartera, es importante observar la distribución empírica del monto de los reclamos. Es común que las variables monetarias tengan un sesgo hacia la derecha en su distribución, por lo tanto, se emplea una transformación logarítmica para estabilizar la varianza y normalizar los datos.
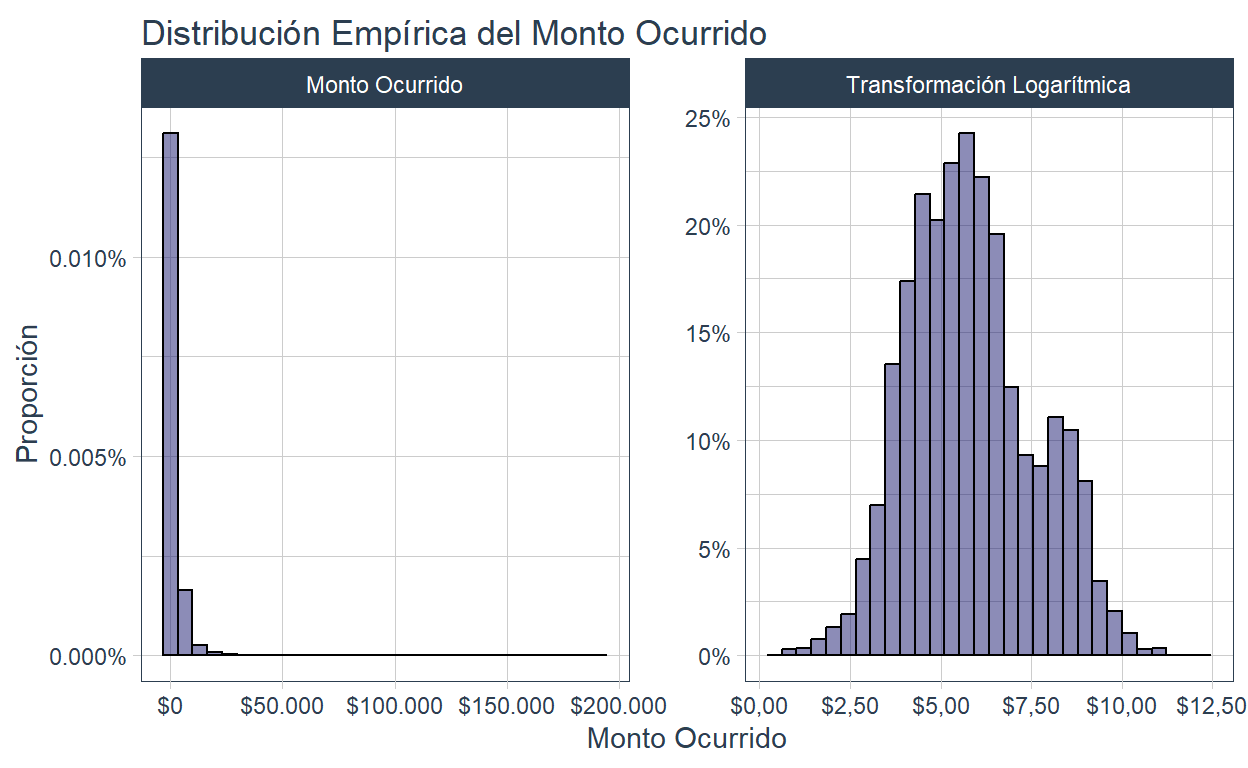
Efectivamente, la distribución empírica del monto de las pérdidas presenta un sesgo a la derecha que advierte la presencia de valores atípicos o extremos. Este último punto puede ser un tema de análisis muy interesante, ya que implica la necesidad de aplicar un tratamiento adecuado a estos valores atípicos más allá de simplemente eliminarlos de los datos. Sin embargo, es importante destacar que este estudio en particular no abordará ese aspecto en profundidad debido a sus limitaciones.
Se puede observar como la transformación logaritmica ayuda a la normalizar los datos, lo que permite una mejor visualización de la distribución.
A continuación se evaluarán tendencias y patrones en la severidad:
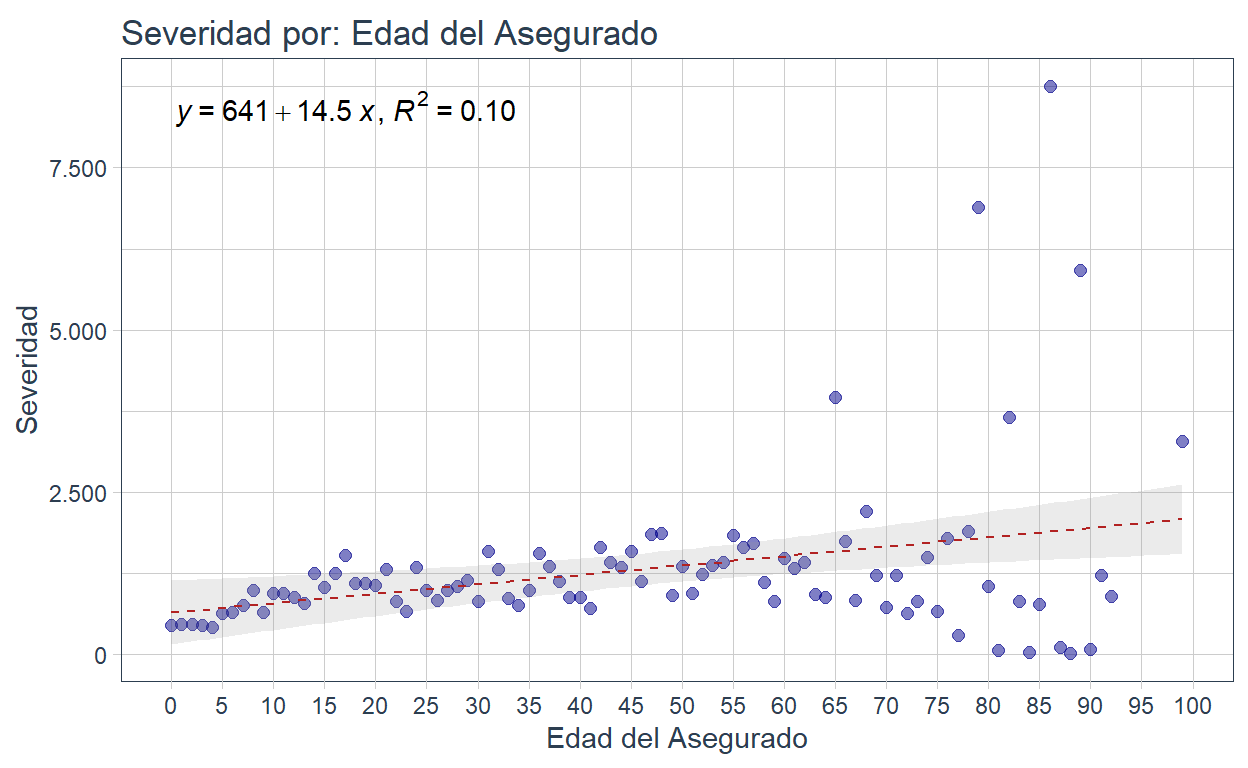
Al visualizar la severidad por edad del asegurado y ajustar un modelo de regresión lineal, se observa que la pendiente del modelo presenta una ligera inclinicación. Esto indica que a mayor edad la severidad tiende a aumentar. Se observa además, la presencia de valores atipicos a partir de los 65 años de edad.
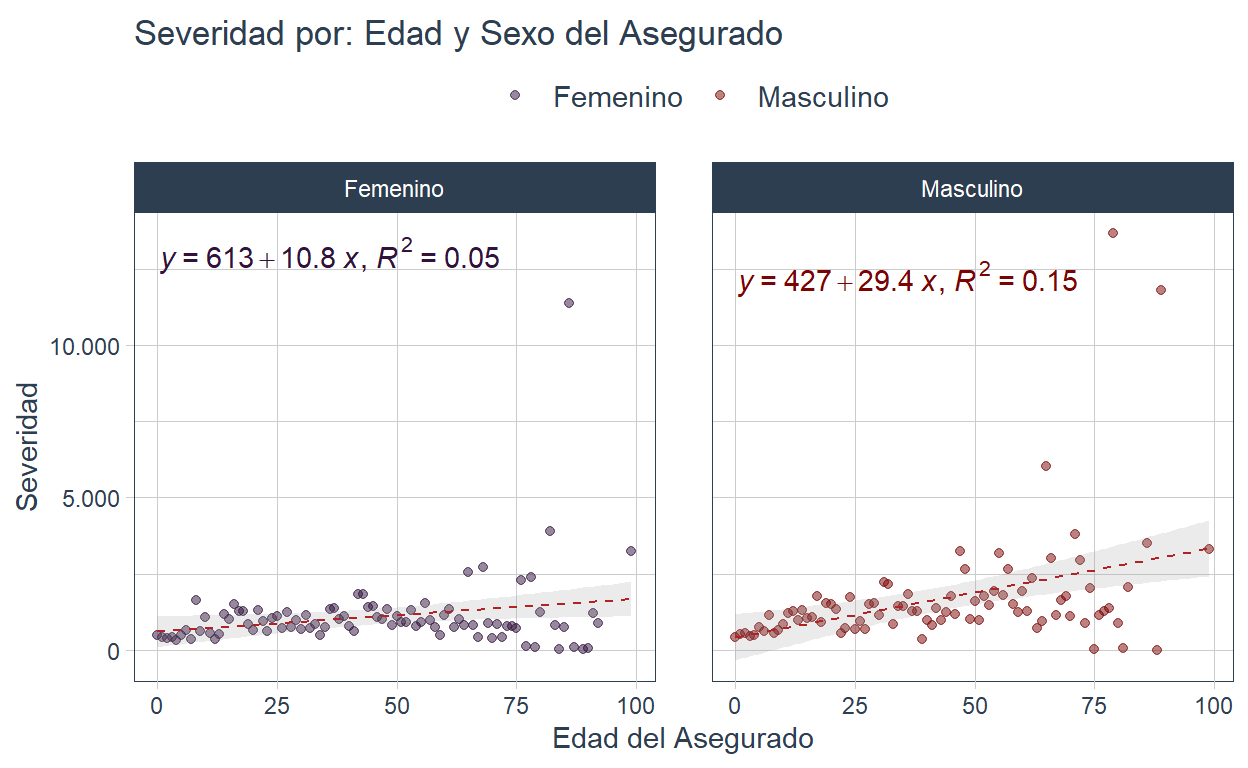
Segmentando la severidad de los reclamos por edad y sexo, se observa que el ajuste lineal para los asegurados masculinos presenta una pendiente mayor que para los asegurados femeninos. Esto indica que la severidad en los hombres es mayor. Esta diferencia en la severidad puede deberse a varios factores, como diferencias en la exposición a riesgos específicos o incluso diferencias biológicas.
Visualizando la severidad por grupo de edad, estatus de la póliza:
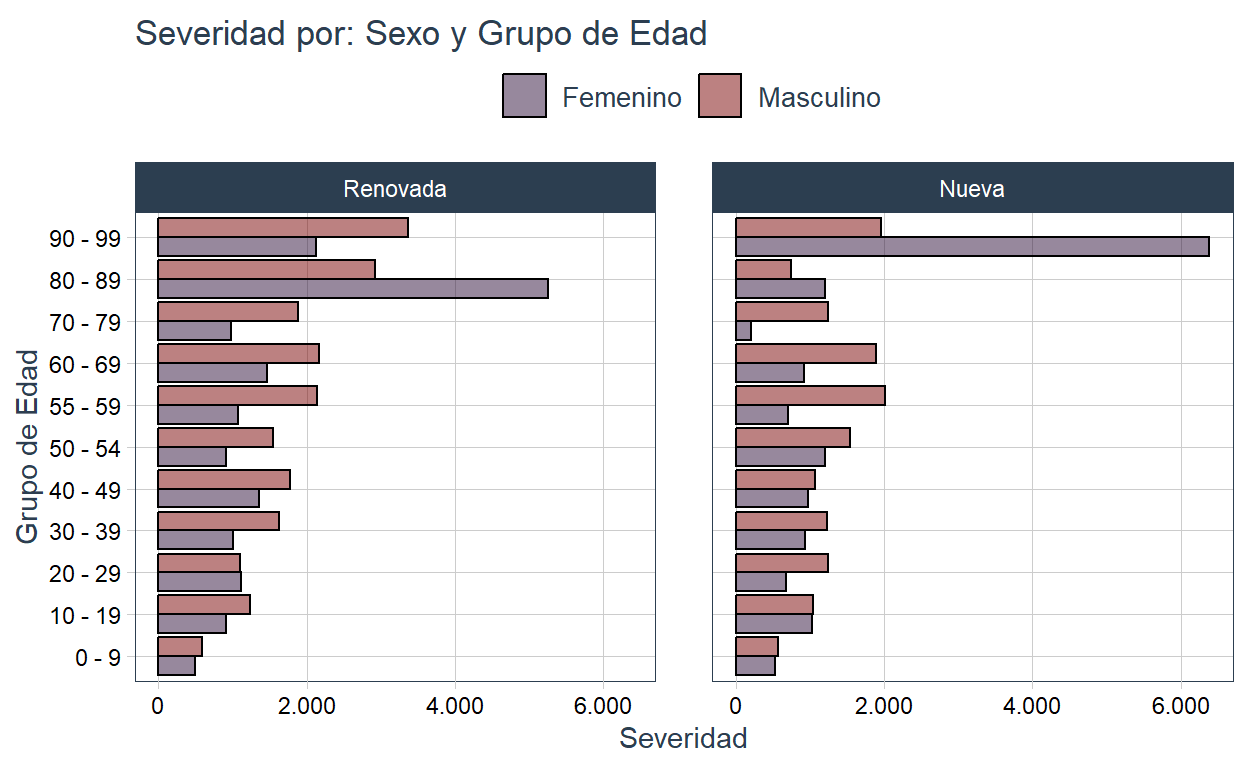
Del gráfico anterior se puede distinguir que la severidad de las pólizas renovadas es mayor que la observada en pólizas nuevas, y esto es coherente debido al cumplimiento de los plazos de espera en ciertas patologías. Esto significa que, en general, las pólizas renovadas tienen reclamos más graves en comparación con las pólizas nuevas. Además, se puede observar que, independientemente del estatus de la póliza, la severidad de los hombres es mayor en casi todos los grupos de edad. Esto sugiere que los hombres tienden a presentar reclamos más graves en comparación con las mujeres en diferentes etapas de la vida.
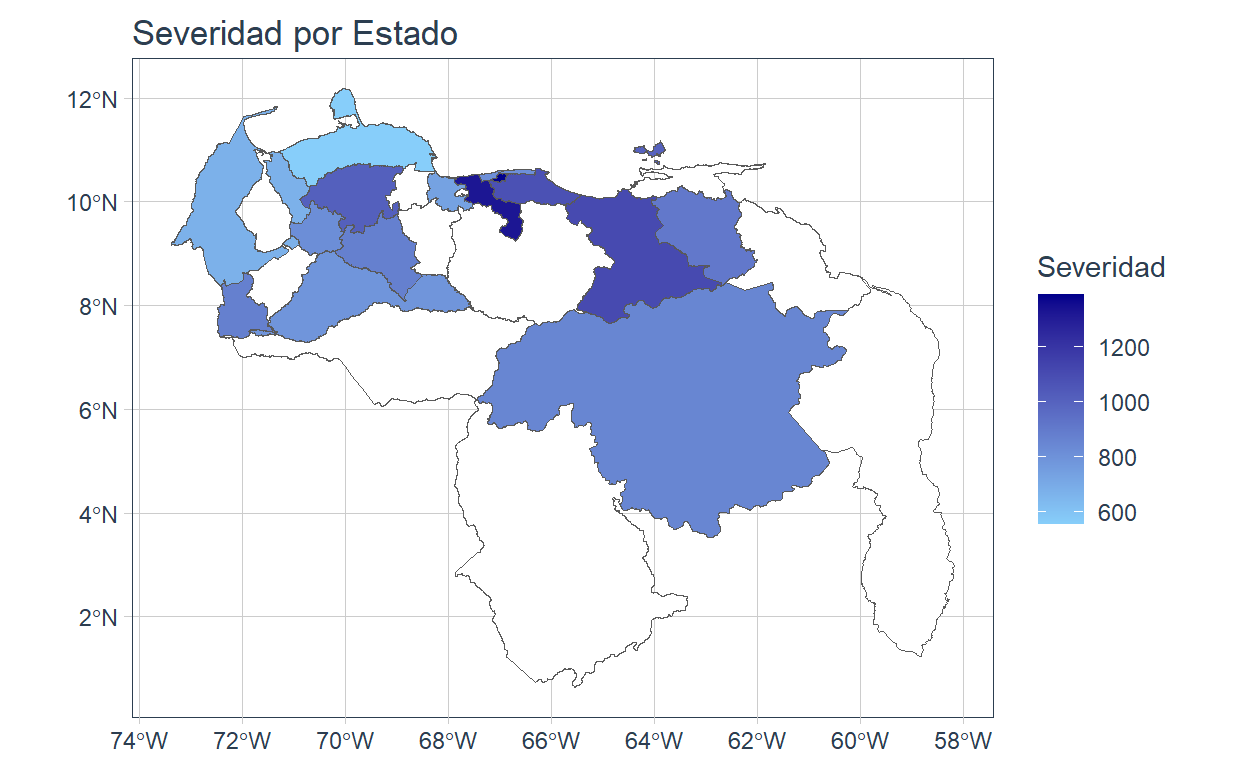
Por último, la severidad por la ubicación del asegurado:
| estado | Expuestos | # Siniestros | Severidad |
|---|---|---|---|
| Distrito Capital | 10.924 | 3930 | 1.389 |
| Merida | 492 | 182 | 1.370 |
| Aragua | 931 | 354 | 1.325 |
| Anzoátegui | 1.219 | 564 | 1.106 |
| Miranda | 2.869 | 919 | 1.076 |
| Lara | 1.230 | 462 | 1.011 |
| Nueva Esparta | 602 | 230 | 1.002 |
| Monagas | 1.030 | 431 | 908 |
| Táchira | 2.376 | 789 | 876 |
| Portuguesa | 620 | 164 | 876 |
| Bolívar | 1.251 | 570 | 851 |
| Trujillo | 511 | 190 | 818 |
| Vargas | 6 | 4 | 813 |
| Barinas | 479 | 134 | 786 |
| Guarico | 345 | 166 | 780 |
| Carabobo | 1.514 | 523 | 734 |
| Zulia | 273 | 114 | 674 |
| Falcón | 251 | 109 | 556 |
Del gráfico anterior se puede distinguir que los tres estados con mayor severidad en los reclamos son la capital del país, el estado Mérida y Aragua. Esta información es relevante ya que nos permite identificar las áreas geográficas donde se presentan los reclamos más graves. Sin embargo, al comparar con el top tres de estados con mayor tasa de uso, no se encuentra similitud en los estados. Esto sugiere que la severidad de los reclamos no necesariamente está relacionada con la frecuencia de uso de las pólizas en cada estado.
Además, se puede observar que varios estados presentan severidades similares. Esto indica que la gravedad de los reclamos no está limitada a un grupo reducido de estados, sino que se distribuye de manera más amplia en todo el país.
Análisis de Cluster
Se utilizará el algoritmo de k-medias para llevar a cabo la segmentación en clústeres de los estados del país, utilizando variables como el expuesto, el número de reclamos, el monto en pérdidas, la tasa de uso y la severidad. Esta metodología nos permitirá agrupar aquellos estados que presenten similitudes en términos de estas variables, lo cual resultará beneficioso para mejorar la capacidad de los modelos de regresión lineal generalizada (GLM) en la identificación de patrones más generales en la cartera de la compañía aseguradora.
El algoritmo de k-medias es una técnica ampliamente utilizada en el análisis de datos no supervisado, que busca agrupar observaciones similares en clústeres. En este caso, aplicaremos el algoritmo a los estados del país, considerando las variables mencionadas previamente. Al realizar esta segmentación, obtendremos grupos de estados que exhiben características y comportamientos similares en relación con el expuesto, los reclamos, las pérdidas, la tasa de uso y la severidad.
Este algoritmo requiere que, de antemano, el investigador defina el número de centroides que se utilizarán para representar los clústeres. Los centroides actúan como puntos de referencia para la asignación de los puntos de datos a los clústeres correspondientes. Para este análisis, se probará a segmentar los estados desde 1 centroide hasta 9, empleando la distancia euclidiana.
A continuación, se visualizan los resultados optenidos:
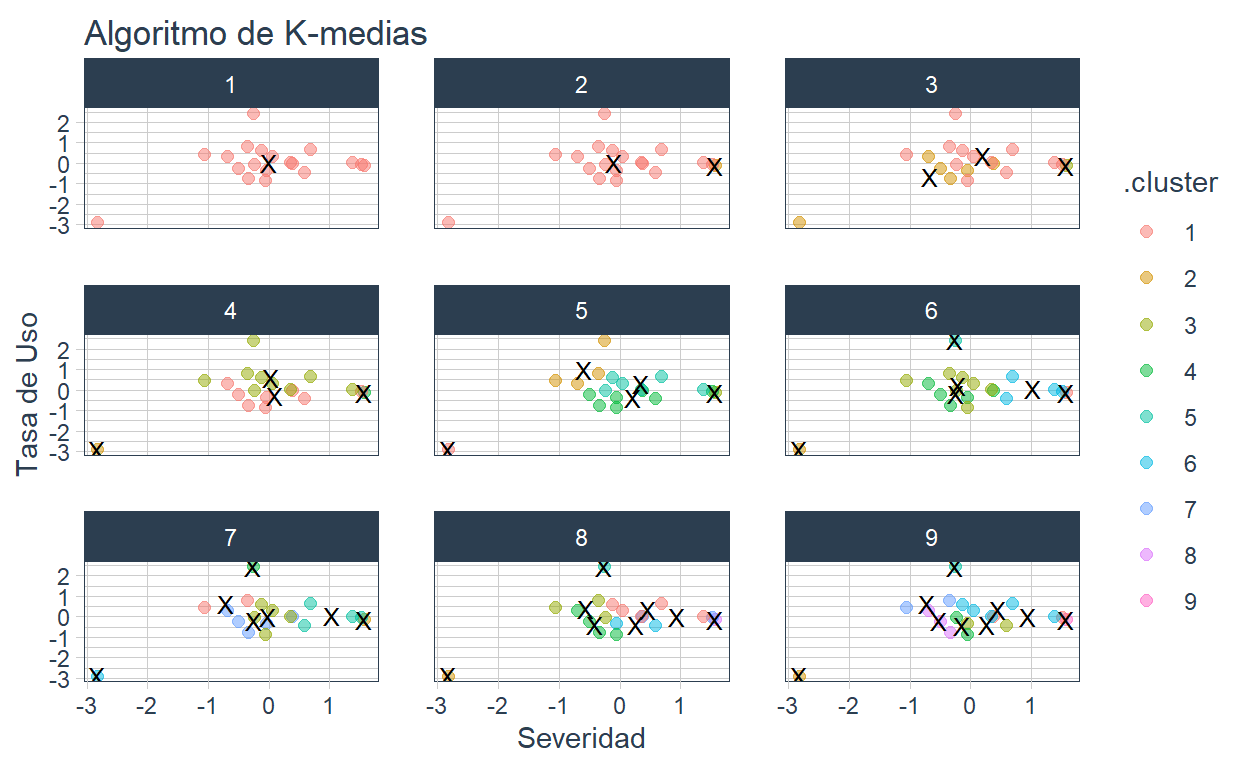
En el gráfico anterior, los centroides de cada clúster se encuentran marcados con la letra “X”. En el primer recuadro se puede observar cómo el primer centroide se posiciona en el eje X e Y. Luego, se incorpora otro centroide a la derecha que segmenta los datos en dos clústeres y así sucesivamente. Para determinar un número óptimo de clústeres, comúnmente se emplea el método del codo, el cual consiste en graficar la varianza explicada por el número de clústeres y encontrar el punto donde la varianza disminuye drásticamente y se nivela, lo que sugiere un número adecuado de clústeres.
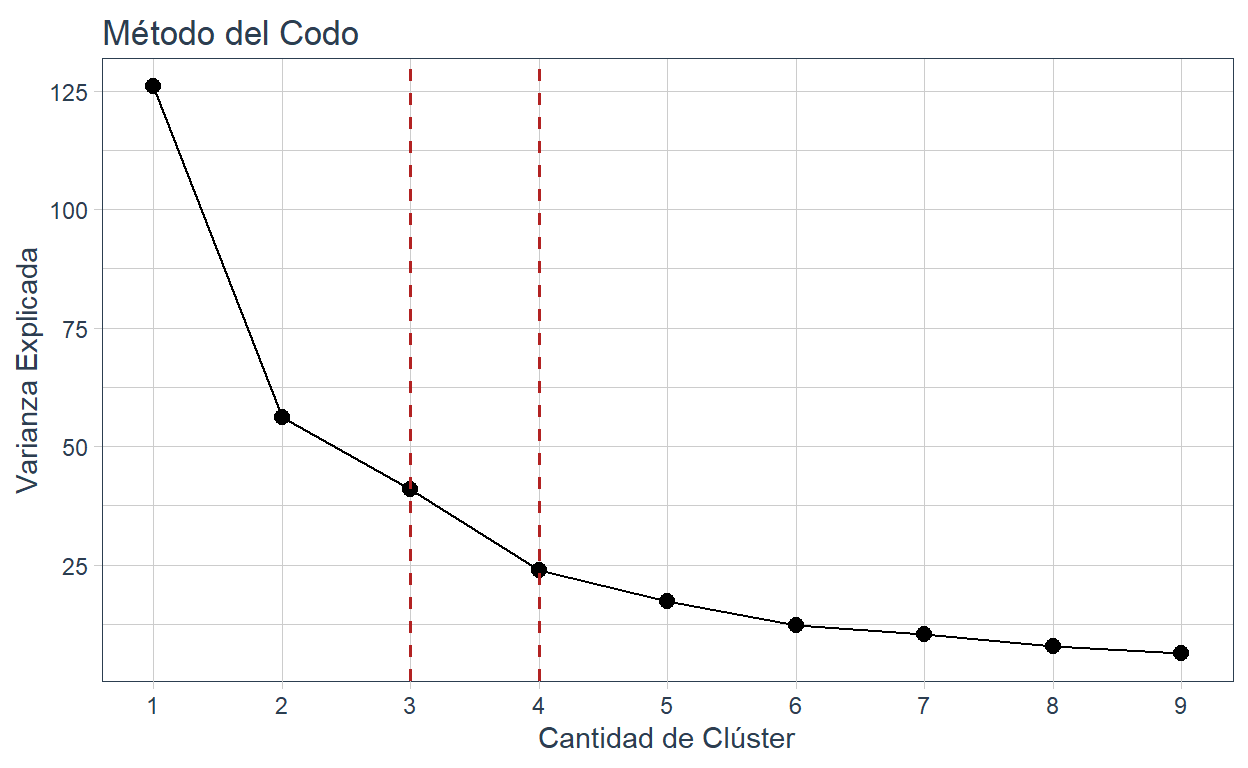
Parece que tres o cuatros clúster sería lo ideal, sin embargo, esto requiere de una análisis más a detalle evaluando el resultado:
| estado | expuestos | severidad | Tasa de Uso | Edad Promedio | Clúster k = 3 | Clúster k = 4 |
|---|---|---|---|---|---|---|
| Distrito Capital | 10.923,90 | 1.389,42 | 0,36 | 33,75 | 3 | 4 |
| Miranda | 2.869,42 | 1.076,23 | 0,32 | 30,13 | 1 | 1 |
| Táchira | 2.376,37 | 876,31 | 0,33 | 32,60 | 2 | 1 |
| Carabobo | 1.514,34 | 734,25 | 0,35 | 31,85 | 2 | 1 |
| Bolívar | 1.251,27 | 850,89 | 0,46 | 28,19 | 1 | 3 |
| Lara | 1.229,62 | 1.011,10 | 0,38 | 33,43 | 2 | 1 |
| Anzoátegui | 1.218,55 | 1.106,32 | 0,46 | 30,17 | 1 | 3 |
| Monagas | 1.029,93 | 907,57 | 0,42 | 27,90 | 1 | 3 |
| Aragua | 930,96 | 1.324,73 | 0,38 | 29,12 | 1 | 3 |
| Portuguesa | 619,85 | 875,66 | 0,26 | 29,98 | 1 | 1 |
| Nueva Esparta | 602,29 | 1.001,58 | 0,38 | 28,22 | 1 | 3 |
| Trujillo | 511,02 | 817,73 | 0,37 | 28,82 | 1 | 3 |
| Merida | 491,92 | 1.370,33 | 0,37 | 33,35 | 1 | 1 |
| Barinas | 479,34 | 785,81 | 0,28 | 32,64 | 2 | 1 |
| Guarico | 345,05 | 779,92 | 0,48 | 30,06 | 1 | 3 |
| Zulia | 273,08 | 673,63 | 0,42 | 33,29 | 2 | 1 |
| Falcón | 251,16 | 556,00 | 0,43 | 29,42 | 1 | 3 |
| Vargas | 5,78 | 812,96 | 0,69 | 33,45 | 1 | 3 |
| Sucre | 1,27 | 0,00 | 0,00 | 37,00 | 2 | 2 |
En ambos escenarios de segmentación, la capital del país constituye un clúster único por sí sola. Esto se debe principalmente a la cantidad de expuestos, que supera con creces al resto de los estados donde la compañía tiene presencia. El estado Sucre también constituye un clúster por sí solo en el escenario de cuatro segmentos. Sin embargo, esto se debe a que prácticamente este estado no posee historial de asegurados ni de siniestros. Ante esta situación, convendría una segmentación de 3 clústeres para agrupar este estado con otros.
Para comprender mejor cada clúster, se resumirán los clúster en cada una de las variables de interés.
| Clúster | Cantidad de Estados | expuesto | severidad | Tasa de Uso | Edad Promedio | Prima de Riesgo |
|---|---|---|---|---|---|---|
| 1 | 12 | 10.127 | $1.012,2 | 38.34% | 30 | $388,1 |
| 2 | 6 | 5.874 | $852,9 | 34.42% | 33 | $293,6 |
| 3 | 1 | 10.924 | $1.389,4 | 35.98% | 34 | $499,9 |
El clúster con mayor concentración de estados es el primero y posee una severidad mayor que el clúster dos pero menor que el tercero. En este último, se ubica la capital del país, que tiene la mayor concentración de expuestos y mayor severidad. La tasa de uso no parece tener mucha variación entre los clústeres, sin embargo, la severidad sí. Por lo tanto, la prima de riesgo entre los clústeres varía.
Partición de los datos
Entrenamiento y Prueba
Realizar modelos estadísticos haciendo uso de todos los datos disponibles no suele ser una buena práctica debido a que no se podrá analizar cómo se comportan los modelos con datos nunca antes vistos y así, poder evaluar su capacidad predictiva y entender su comportamiento. Es mejor particionar los datos en dos conjuntos, uno para entrenar los modelos y otro para probar o testear los modelos. Esto nos permitirá saber el desempeño de los modelos en datos nuevos.
Los datos con el historial de siniestros y expuestos serán particionados en una relación 80% / 20%, es decir, el 80% de los datos será utilizado para entrenar los modelos y el 20% restante para evaluar los modelos.
| Conjunto | Expuesto Promedio | Cantidad de Siniestros | Tasa de Uso | severidad | Prima de Riesgo |
|---|---|---|---|---|---|
| Entrenamiento | 0,53 | 7.828 | 36.35% | 1.143,28 | 416 |
| Prueba | 0,53 | 2.007 | 37.24% | 1.079,05 | 402 |
Modelos Lineales Generalizados
Modelo Poisson para Frecuencia
Para modelar la frecuencia de los reclamos, se hará uso de un modelo log-lineal poisson. En primera instancia, se realizará el ajuste del modelo utilizando los datos de entrenamiento. Posteriormente, se validarán los resultados del modelo utilizando los datos de prueba.
A continuación, se graficarán las tasas de uso observadas vs las ajustadas por el modelos GLM con un intervarlo de confianza del 95%.
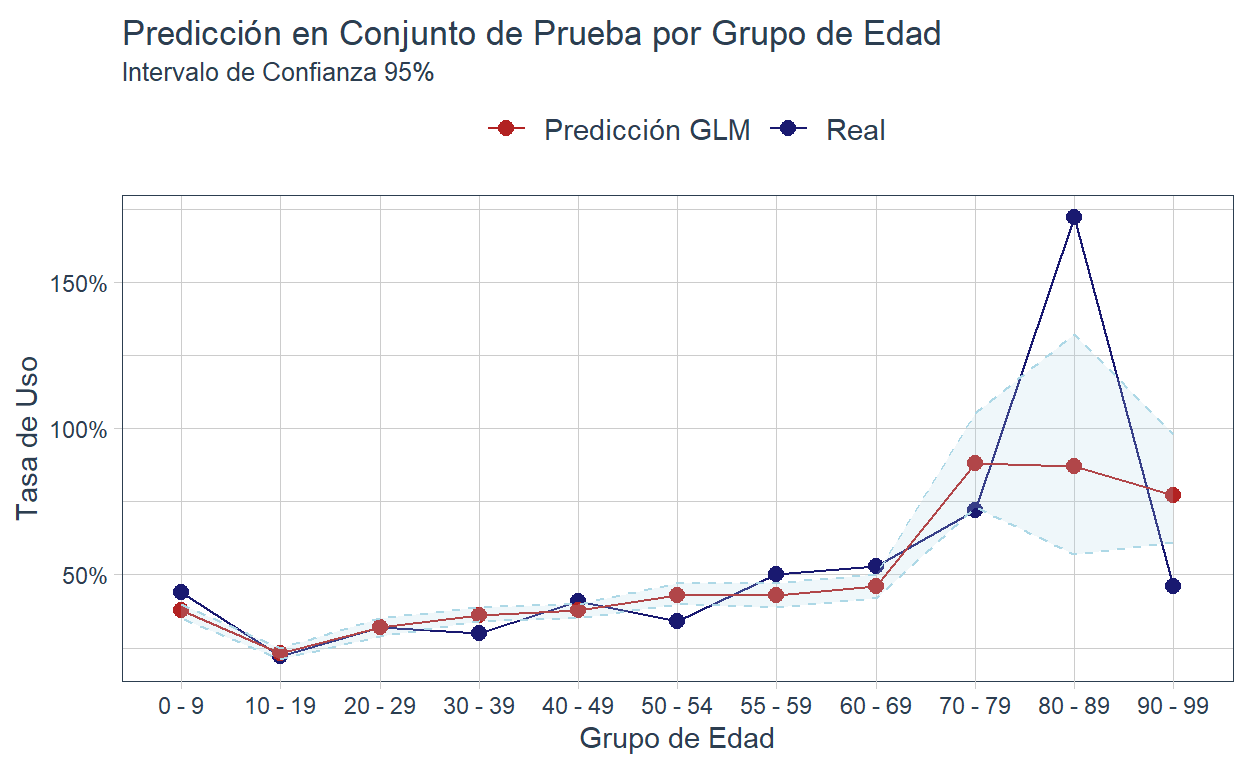
El modelo GLM poisson para la tasa de uso logra capturar de manera correcta la mayoría de las tendencias observadas en los rangos de edad. Sin embargo, en los tres últimos rangos, el modelo subestima o sobrestima la tasa de uso. Observemos cómo se comportan las predicciones considerando el resto de los factores de riesgo:
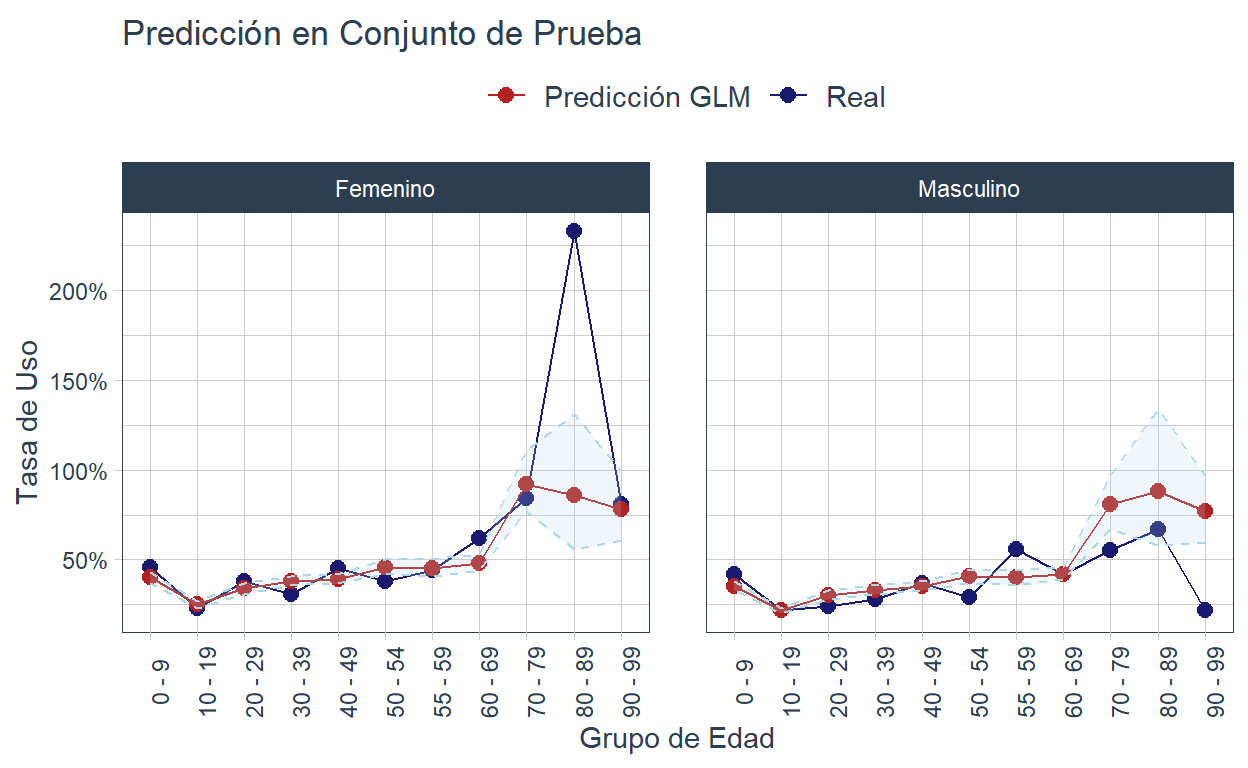
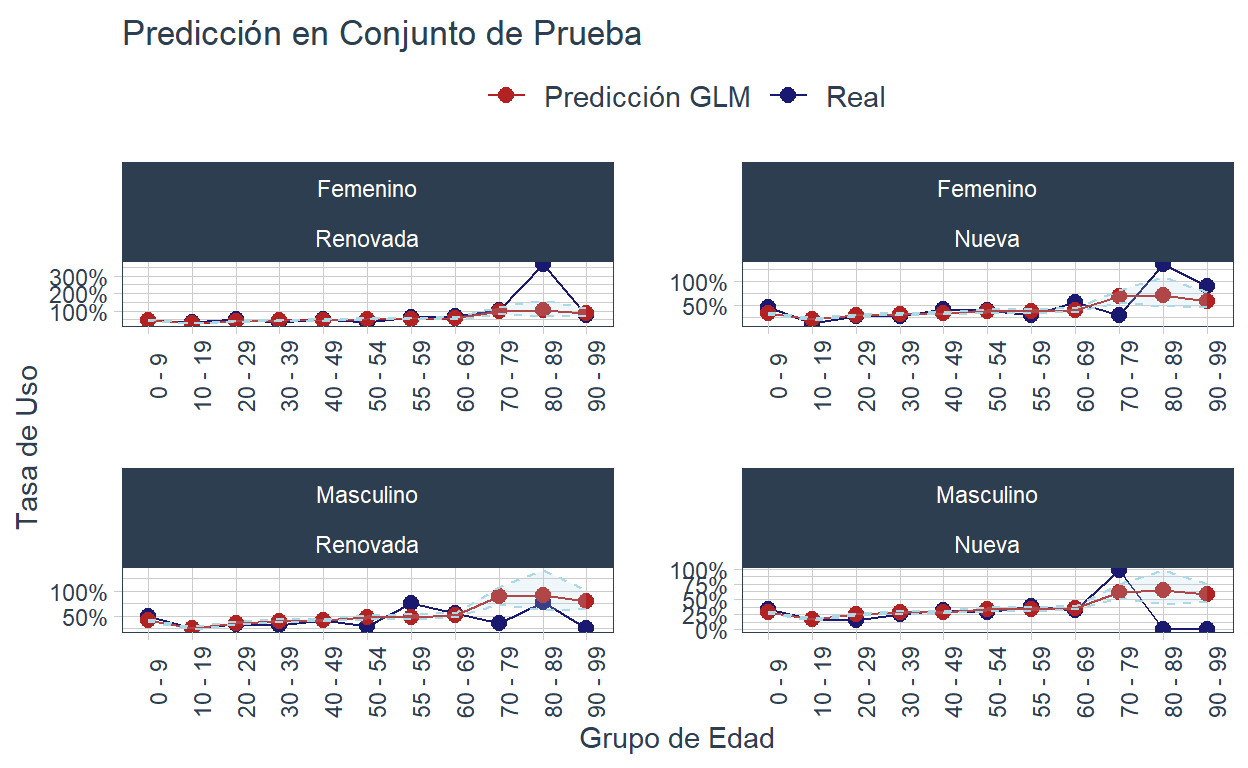
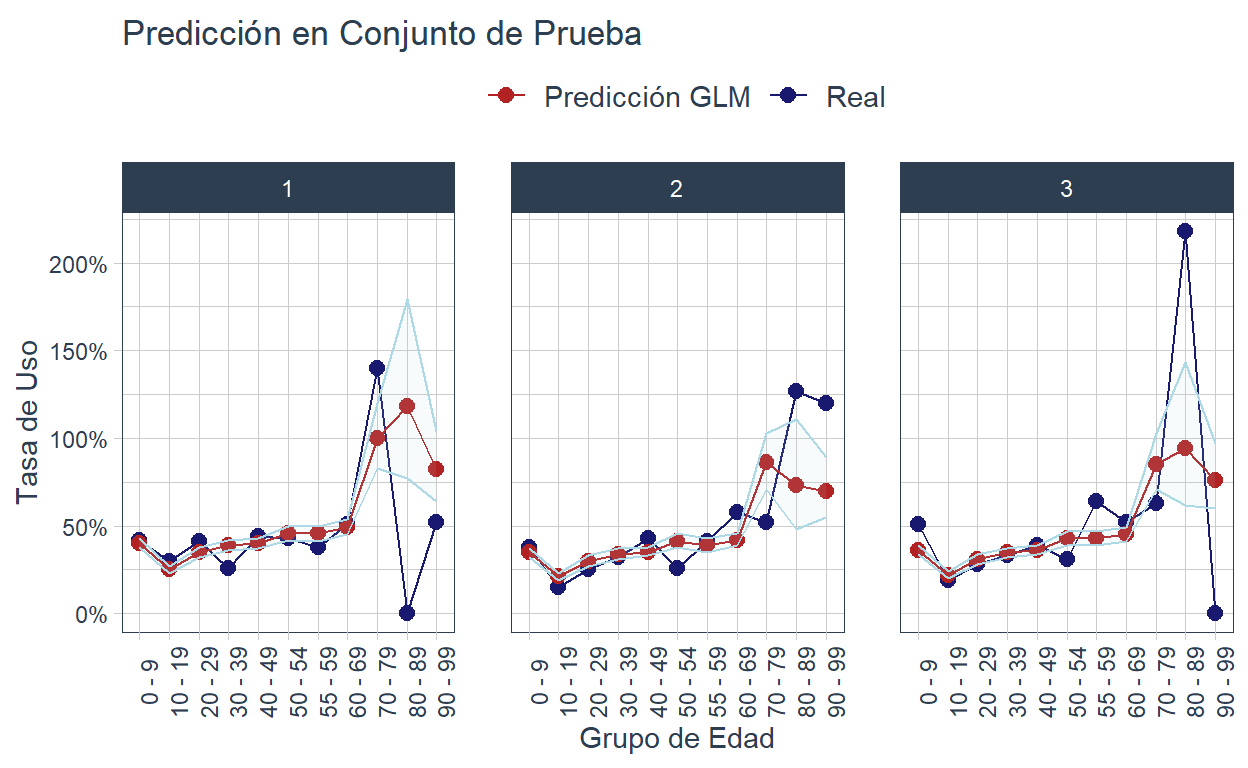
El modelo ajustado logra predecir de manera apropieda la frecuencia observada a através de los distintos factores de riesgo. A continuación, se procede a ajustar el Modelo Lineal Generalizado Poisson a el conjunto global de datos para proceder a evaluar su significancia:
A continuación, se proporciona un desglose de cada variable, incluyendo su coeficiente de regresión estimado y el contraste de hipótesis que evalúa su significancia estadística:
| Termino | Valor Coeficiente | Error Estándar | Estadistico de Contraste | P Valor |
|---|---|---|---|---|
| (Intercept) | 0,537 | 0,034 | −18,548 | 0,000 |
| grupo10 - 19 | 0,589 | 0,039 | −13,411 | 0,000 |
| grupo20 - 29 | 0,841 | 0,040 | −4,359 | 0,000 |
| grupo30 - 39 | 0,908 | 0,035 | −2,779 | 0,005 |
| grupo40 - 49 | 0,994 | 0,033 | −0,175 | 0,861 |
| grupo50 - 54 | 1,084 | 0,042 | 1,939 | 0,052 |
| grupo55 - 59 | 1,164 | 0,044 | 3,431 | 0,001 |
| grupo60 - 69 | 1,249 | 0,040 | 5,504 | 0,000 |
| grupo70 - 79 | 2,025 | 0,083 | 8,469 | 0,000 |
| grupo80 - 89 | 2,523 | 0,188 | 4,934 | 0,000 |
| grupo90 - 99 | 1,768 | 0,116 | 4,926 | 0,000 |
| numrenNueva | 0,693 | 0,021 | −17,495 | 0,000 |
| sexoMasculino | 0,878 | 0,020 | −6,386 | 0,000 |
| cluster2 | 0,869 | 0,028 | −5,092 | 0,000 |
| cluster3 | 0,891 | 0,023 | −5,050 | 0,000 |
| suma_aseg | 1,000 | 0,000 | −2,227 | 0,026 |
Los rangos de edad de 40 a 49 años y de 50 a 55 años no muestran una significancia estadística. Para abordar esta situación, se podría considerar la agrupación de estos rangos de edad en una sola categoría y realizar un nuevo ajuste del modelo. Se procederá con este análisis utilizando los rangos de edad originales y considerando su no significancia.
Análisis de Desvianza
El análisis de Desvianza en modelos GLM es una medida de bondad del ajuste. La desviación, también conocida como deviance, es equivalente a la suma de los cuadrados residuales en un modelo lineal. Valores más altos de desviación indican un peor ajuste del modelo.
El análisis de la desviación se utiliza para contrastar globalmente el efecto de las covariables en el modelo. Se realiza mediante pruebas de hipótesis, como la prueba de chi-cuadrado, para comparar la desviación entre diferentes modelos. Esto permite evaluar la significancia estadística de las covariables y determinar cuáles tienen un efecto significativo en la respuesta.
A continuación, el resultado del análisis de Desvianza:
| Factor de Riesgo | Grados de Libertad | Desvianza | P Valor |
|---|---|---|---|
| Grupo de Edad | 10 | 510.88 | 0.00 |
| Estatus Póliza | 1 | 303.01 | 0.00 |
| Sexo del Asegurado | 1 | 40.57 | 0.00 |
| Clúster Estado | 2 | 34.07 | 0.00 |
| Suma Asegurada | 1 | 5.07 | 0.02 |
Se obtiene p-valores menores al nivel de significancia de 5% lo que indica que todos los factores de riesgo son estadísticamente significativos.
Análisis de Residuos
A continuación, se revisa la calidad del modelo graficando los residuos estandarizados:
Warning: deviations from the expected
                                   distribution detected (p = 0.000).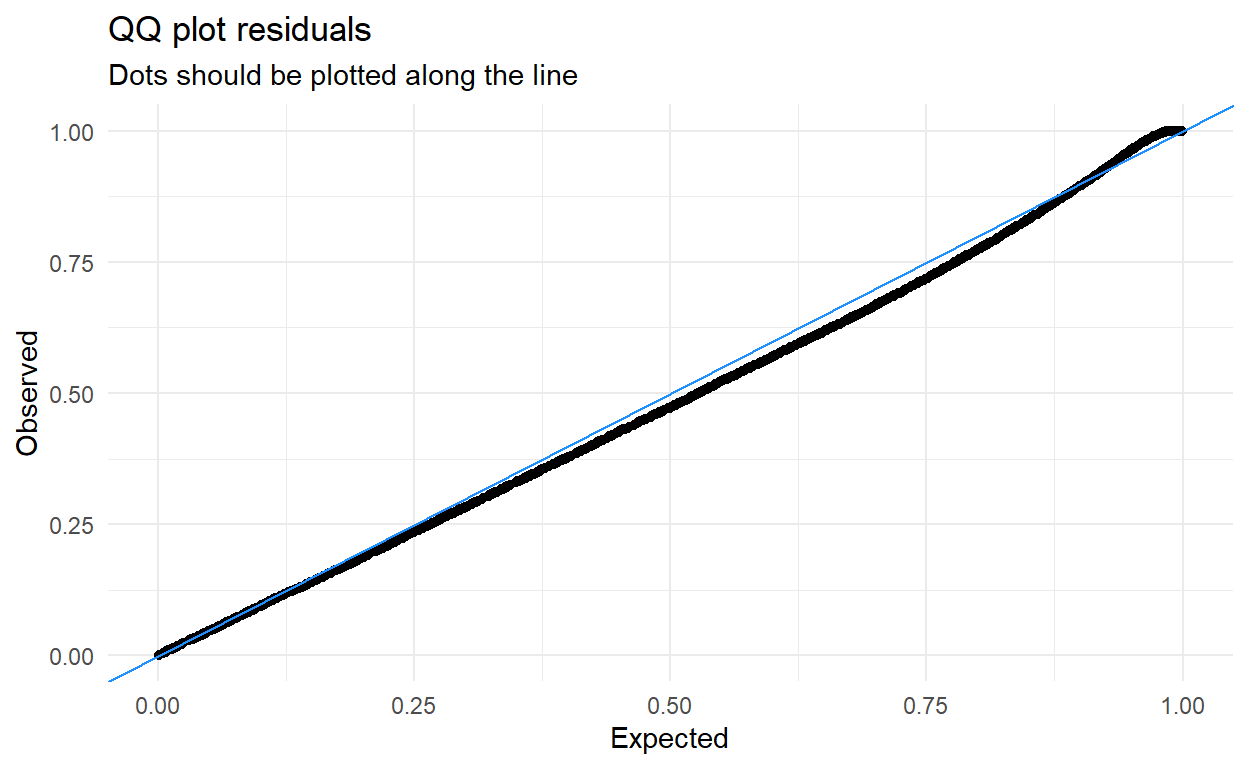
Los valores observados no se distribuyen alrededor de los valores predichos, lo que sugiere desviaciones con respecto a la distribución. En un análisis más exhaustivo, se podría probar el ajuste de un modelo GLM no poisson, como el quasipoisson o el binomial negativa.
Modelo Gamma para Severidad
Para modelar la severidad de los reclamos, se hará uso de un modelo GLM Gamma. En primera instancia, se realizará el ajuste del modelo utilizando los datos de entrenamiento. Posteriormente, se validarán los resultados del modelo utilizando los datos de prueba.
A continuación, se graficarán la severidad observada vs la severidad ajustada por el modelo GLM con un intervarlo de confianza del 95%:
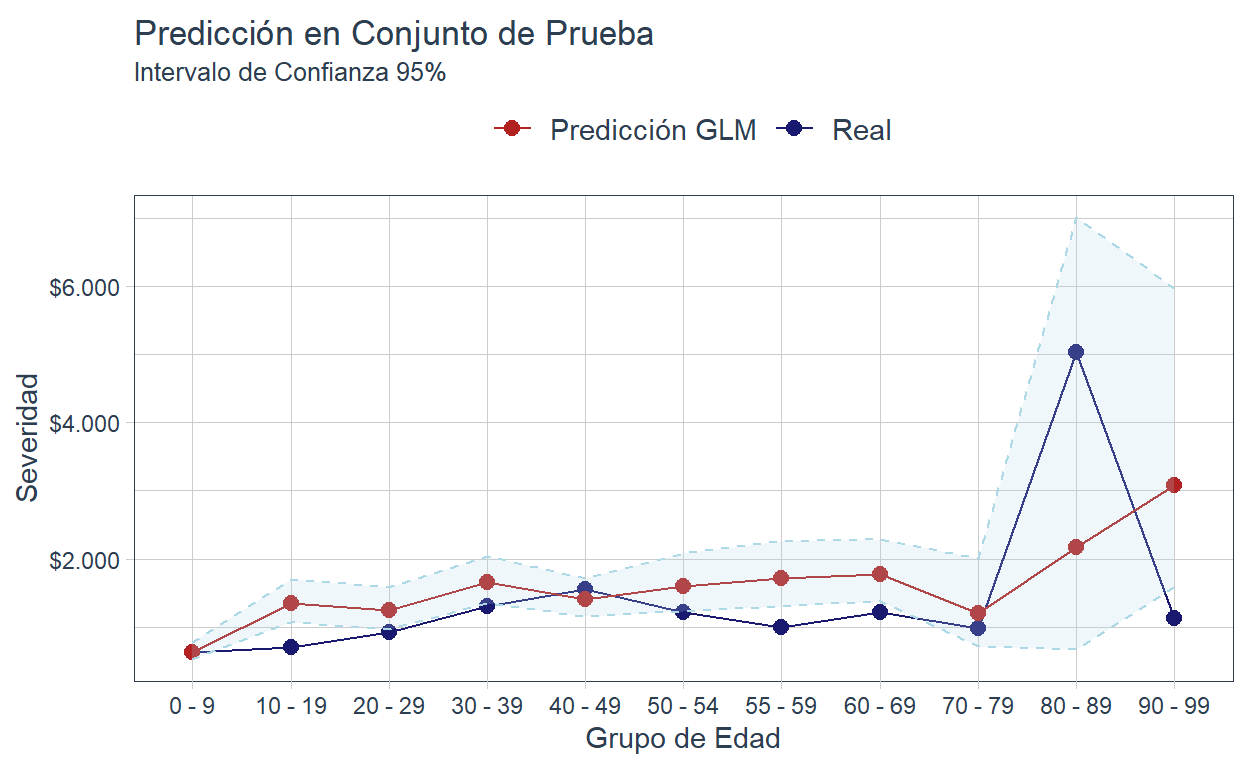
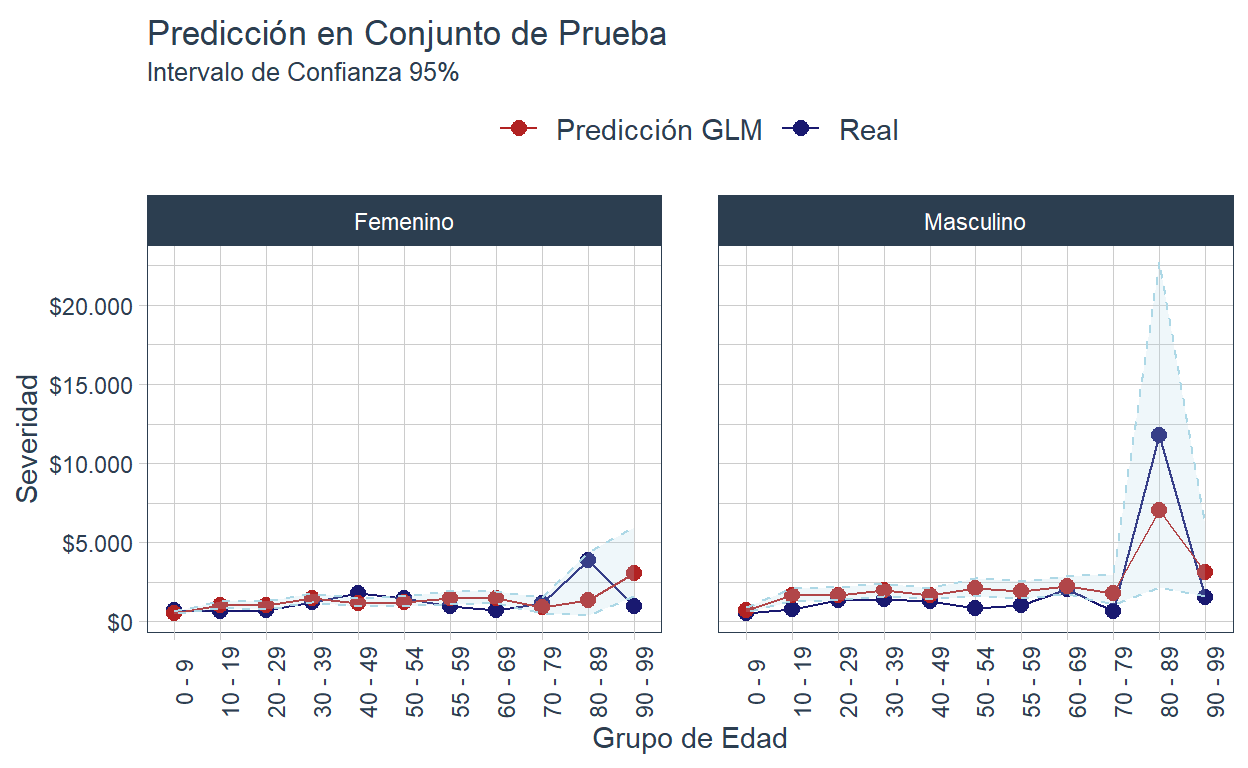
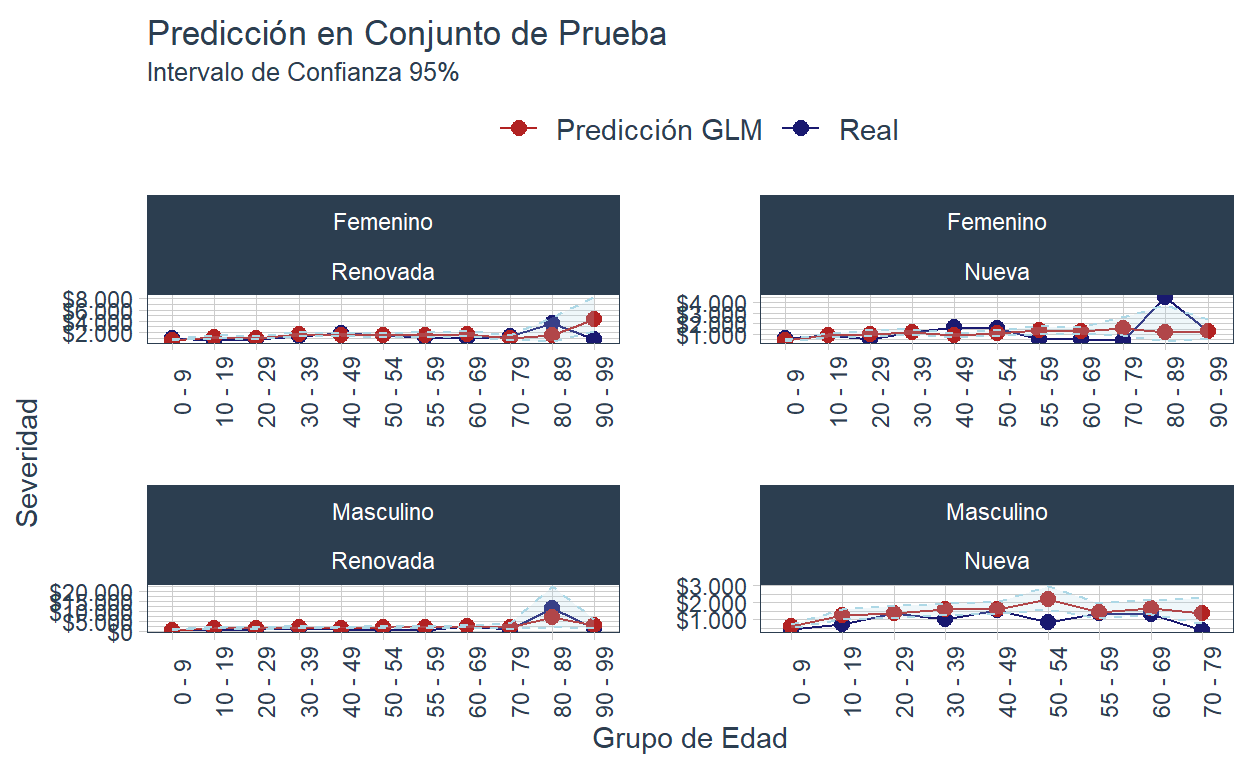
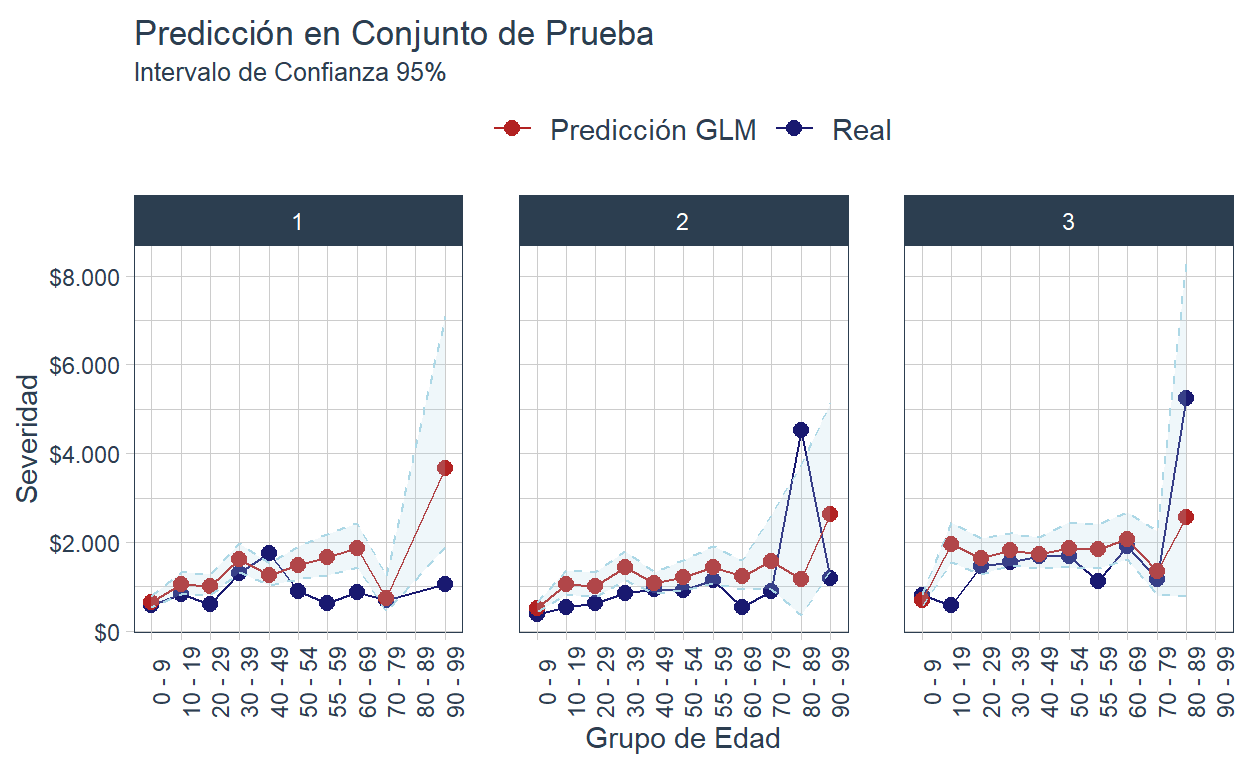
El modelo ajustado logra predecir de manera apropieda la severidad observada a através de los distintos factores de riesgo. A continuación, se procede a ajustar el Modelo Lineal Generalizado Gamma a el conjunto global de datos para proceder a evaluar su significancia:
A continuación, se desglosa de cada variable, incluyendo su coeficiente de regresión estimado y el contraste de hipótesis que evalúa su significancia estadística:
| Termino | Valor Coeficiente | Error Estandar | Estadistico de Contraste | P Valor |
|---|---|---|---|---|
| (Intercept) | 637,480 | 0,094 | 68,941 | 0,000 |
| grupo10 - 19 | 1,776 | 0,109 | 5,272 | 0,000 |
| grupo20 - 29 | 1,848 | 0,110 | 5,607 | 0,000 |
| grupo30 - 39 | 2,333 | 0,096 | 8,847 | 0,000 |
| grupo40 - 49 | 2,777 | 0,091 | 11,208 | 0,000 |
| grupo50 - 54 | 2,212 | 0,115 | 6,877 | 0,000 |
| grupo55 - 59 | 2,655 | 0,122 | 7,989 | 0,000 |
| grupo60 - 69 | 2,972 | 0,112 | 9,743 | 0,000 |
| grupo70 - 79 | 2,836 | 0,230 | 4,527 | 0,000 |
| grupo80 - 89 | 7,876 | 0,518 | 3,988 | 0,000 |
| grupo90 - 99 | 5,925 | 0,319 | 5,572 | 0,000 |
| suma_aseg | 1,000 | 0,000 | 4,422 | 0,000 |
| cluster2 | 0,805 | 0,077 | −2,835 | 0,005 |
| cluster3 | 1,302 | 0,063 | 4,185 | 0,000 |
| numrenNueva | 0,880 | 0,058 | −2,220 | 0,026 |
| sexoMasculino | 1,403 | 0,057 | 5,979 | 0,000 |
Todos los factores de riesgo son significantes.
Análisis de Desvianza
A continuación, el resultado del análisis de Desvianza:
| Factor de Riesgo | Grados de Libertad | Desvianza | P Valor |
|---|---|---|---|
| Grupo de Edad | 10 | 1526.17 | 0.000 |
| Suma Asegurada | 1 | 210.91 | 0.000 |
| Clúster Estado | 2 | 311.63 | 0.000 |
| Estatus Póliza | 1 | 32.63 | 0.038 |
| Sexo del Asegurado | 1 | 274.27 | 0.000 |
Se obtiene p-valores menores al nivel de significancia de 5% lo que indica que todos los factores de riesgo son estadísticamente significativos.
Determinación de Prima Riesgo
Una vez ajustados los modelos de frecuencia y severidad con cada uno de los factores de riesgo seleccionados, es necesario emplearlos para determinar la prima de riesgo. La prima prua o de riesgo se obtiene como el resultado de la multiplicación de las predicciones de cada modelo. Este enfoque combina la información de los modelos de frecuencia y severidad para calcular un valor que refleje el nivel de riesgo asociado. Al considerar los factores de riesgo seleccionados y sus coeficientes de regresión estimados en los modelos, se puede obtener una estimación más precisa de la prima de riesgo.
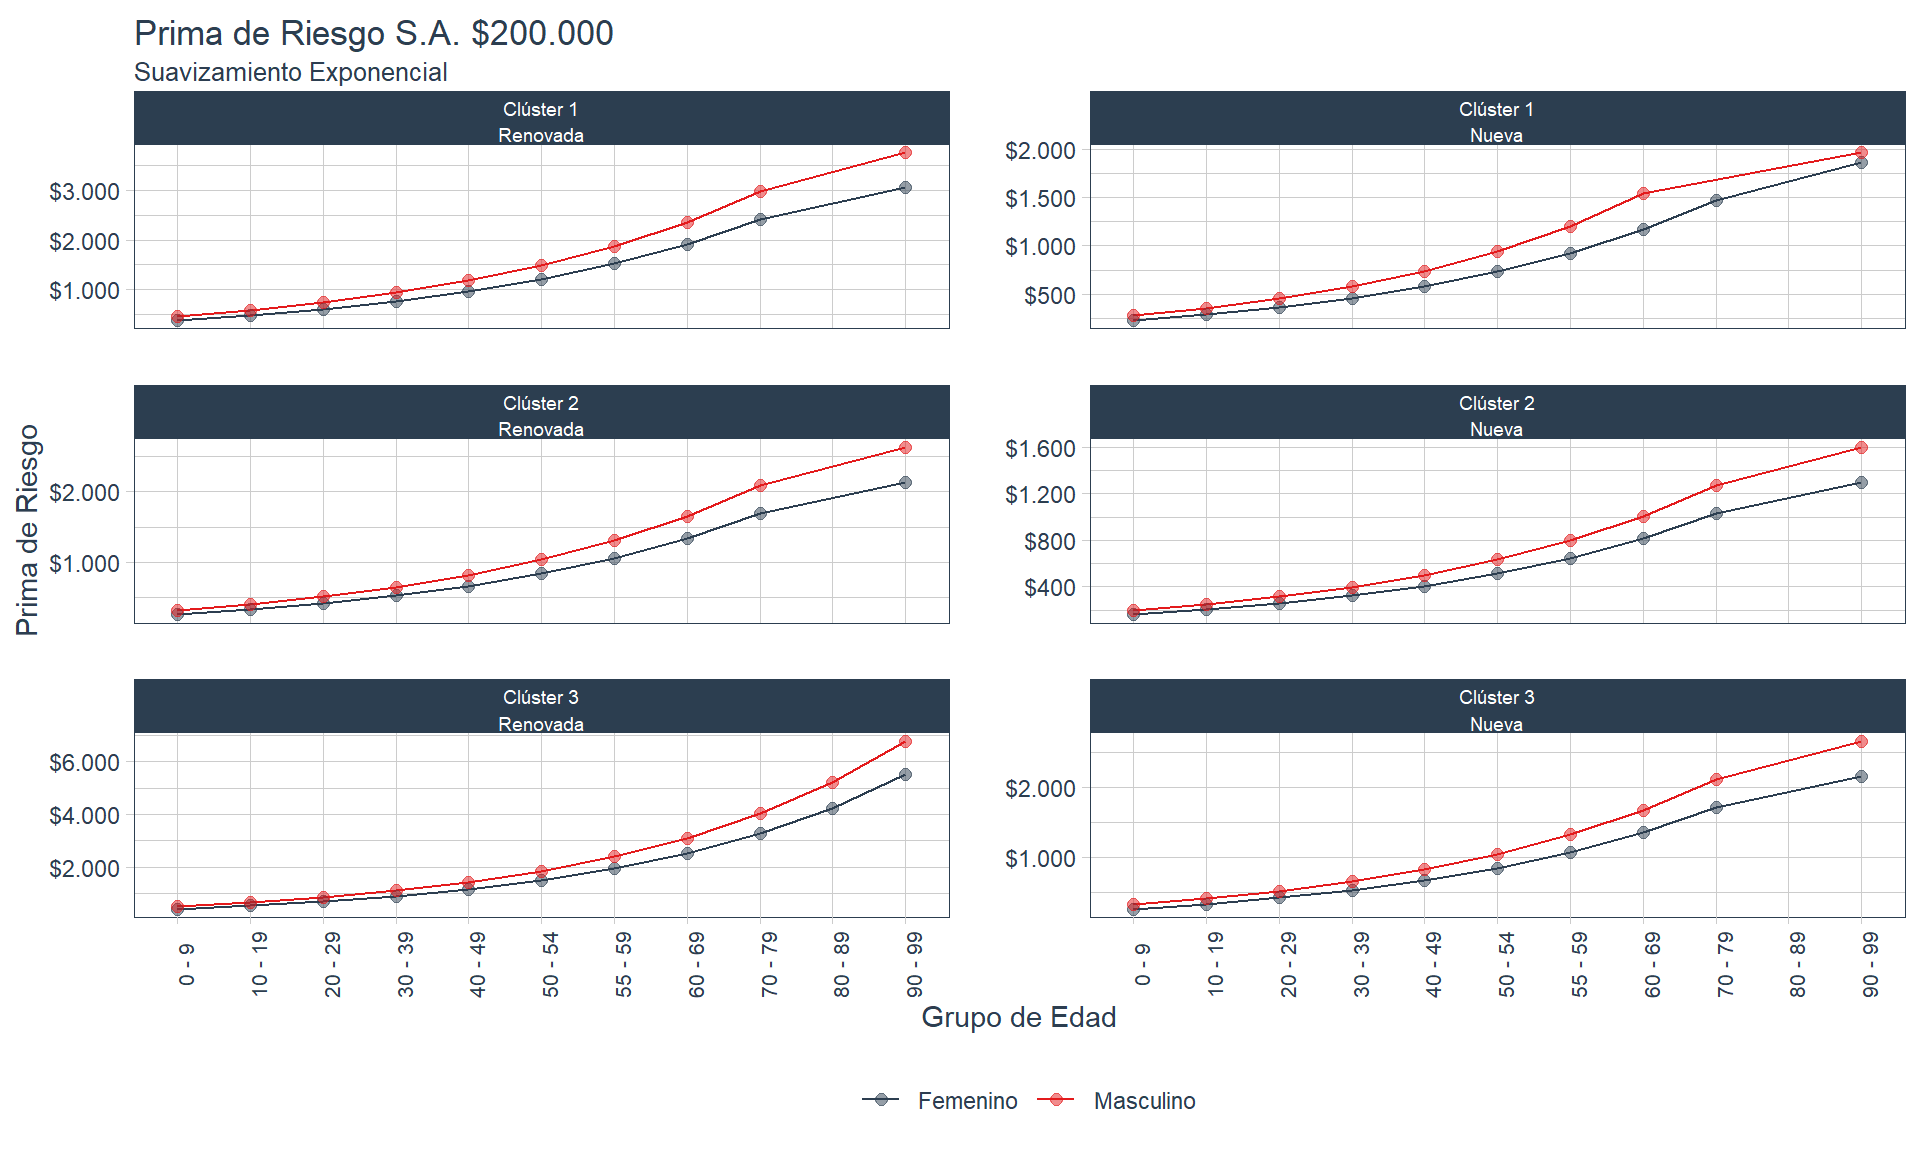
A continuación, se muestra el resultado de las primas para la suma asegurada con la mayor concentración de expuestos:
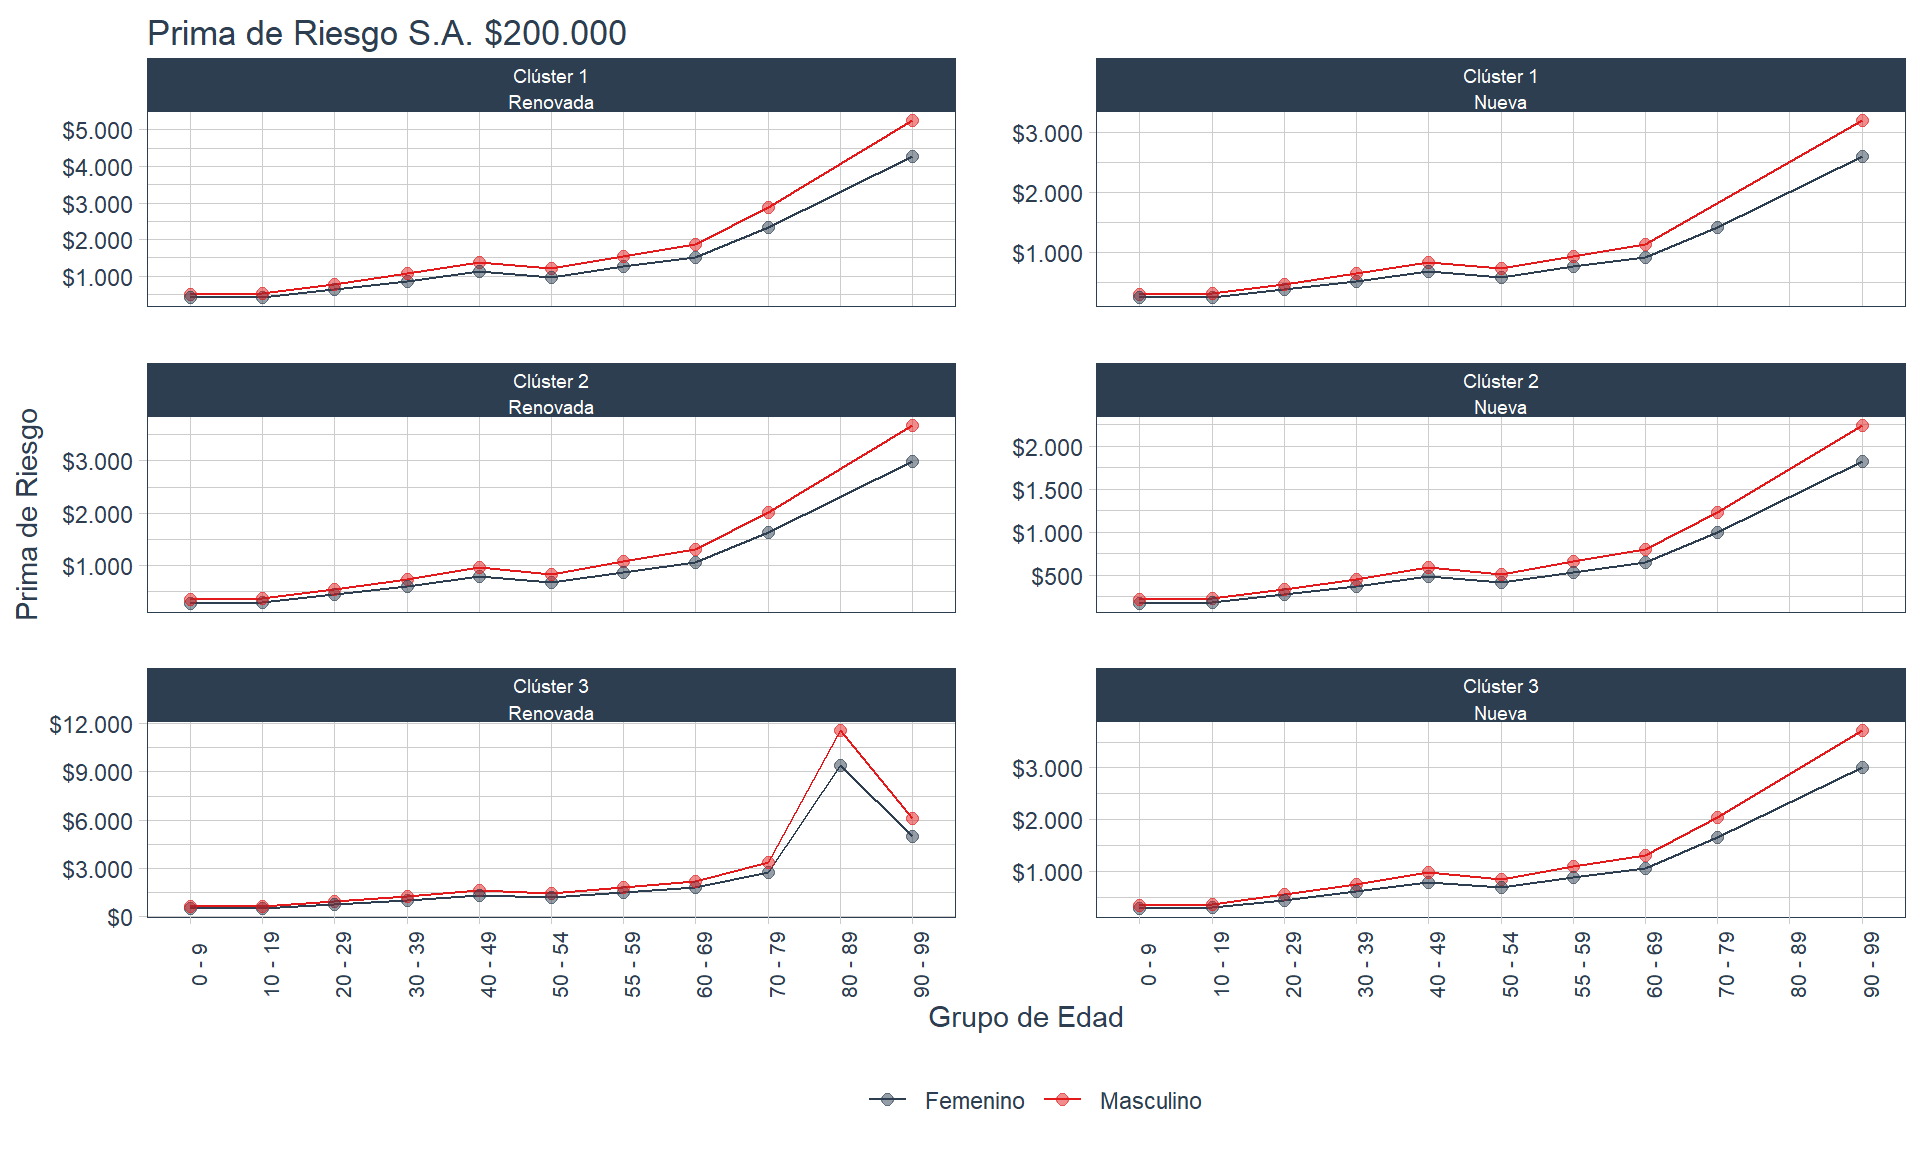
Empleando los modelos poisson y gamma para la determinación de primas de riesgo, se puede observar que las primas para pólizas renovadas son mayores que para pólizas nuevas. Además, se observa que las primas varían entre clústeres. Sin embargo, parece que el sexo del asegurado no genera una distinción en las primas, por lo cual se podría evaluar la exclusión de este factor de riesgo.
Estas primas son consideradas puras y pueden suavizarse mediante el uso de modelos de regresión exponencial o polinomial: