Introducción
Una empresa de viajes y tours turísticos ofrece paquetes de seguro a sus clientes. Actualmente la empresa está desarrollando un nuevo paquete que incluirá una nueva cobertura, debido a esta nueva inclusión la compañía desea saber qué clientes estarían interesados en comprarlo según el historial de su base de datos.
El seguro con la nueva cobertura se ofreció a algunos de sus clientes en el año 2019 y los datos proporcionados se extrajeron del rendimiento de ventas del paquete durante ese período. Los datos recolectados son de casi 2000 de sus clientes y se requiere que construya un modelo predictivo que pueda predecir si el cliente estará interesado en comprar o no el paquete de seguro de viaje en función de las variables que se recolectaron.
Los datos se extrajeron de la reconocida comunidad de científicos de datos Kaggle y se hará uso del ecosistema de paquetes que ofrece Tidymodels para el desarrollo de los distintos modelos de aprendizaje supervisado.
Descripción de los datos
En total hay nueve (9) variables o características de los clientes en los datos:
- Age: Edad del cliente.
- Employment Type: El sector en el que está empleado el cliente.
- Graduate or Not: Si el cliente es graduado universitario o no.
- Annual Income: El ingreso anual del cliente en rupias indias.
- Family Members: Número de miembros en la familia del cliente.
- Chronic Disease: Si el cliente sufre de alguna enfermedad o condición importante como diabetes, presión arterial alta o asma, etc.
- Frequent Flyer: Indica si el cliente ha realizado al menos cuatro viajes a diferentes locaciones en los últimos dos años (2017-2019).
- Ever Travelled Abroad: Indica si el cliente ha realizado alguna vez un viaje a un país extranjero.
- Travel Insurance: ¿El cliente compró un paquete de seguro de viaje durante la oferta de lanzamiento celebrada en el año 2019?.
Análisis exploratorio
Se realizará el análisis exploratorio en dos partes, una enfocada en visualizar la distribución porcentual de los clientes que aceptaron y los que no aceptaron el seguro a través de las distintas variables categóricas. La otra parte se enfocará en análisis las variables numéricas, realizando un análisis de correlación y de distribución de las variables segmentando por la variable respuesta (aceptación o rechazo del seguro).
Variables categóricas
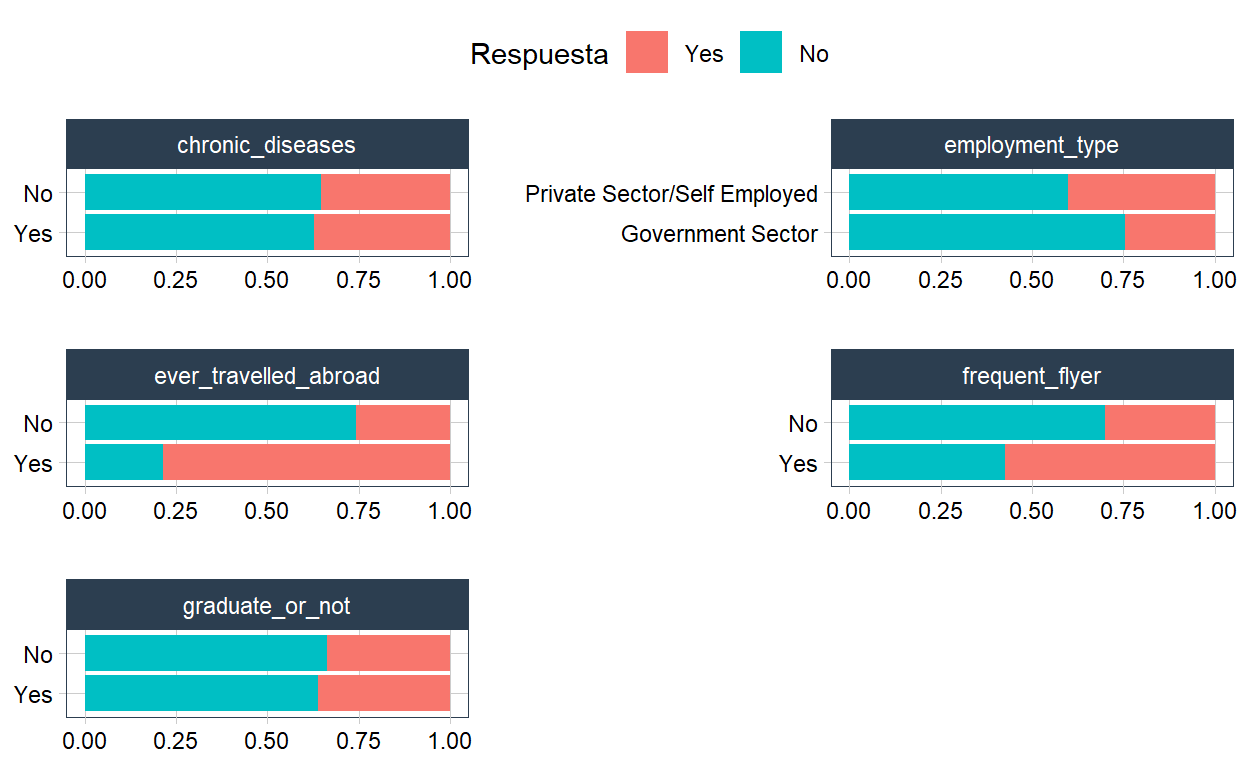
Parece que conocer si el cliente sufre de alguna enfermedad o condición importante y, además, si es graduado universitario o no, es irrelevante para determinar si estaría interesado en adquirir el paquete de seguro o no. Existe una diferencia notable en conocer si es un viajero frecuente y si ha realizado viajes al extranjero para la adquisición de este paquete.
Variables numéricas
Para poder visualizar mejor el ingreso anual de los clientes se realizó una transformación logarítmica para estabilizar la varianza.
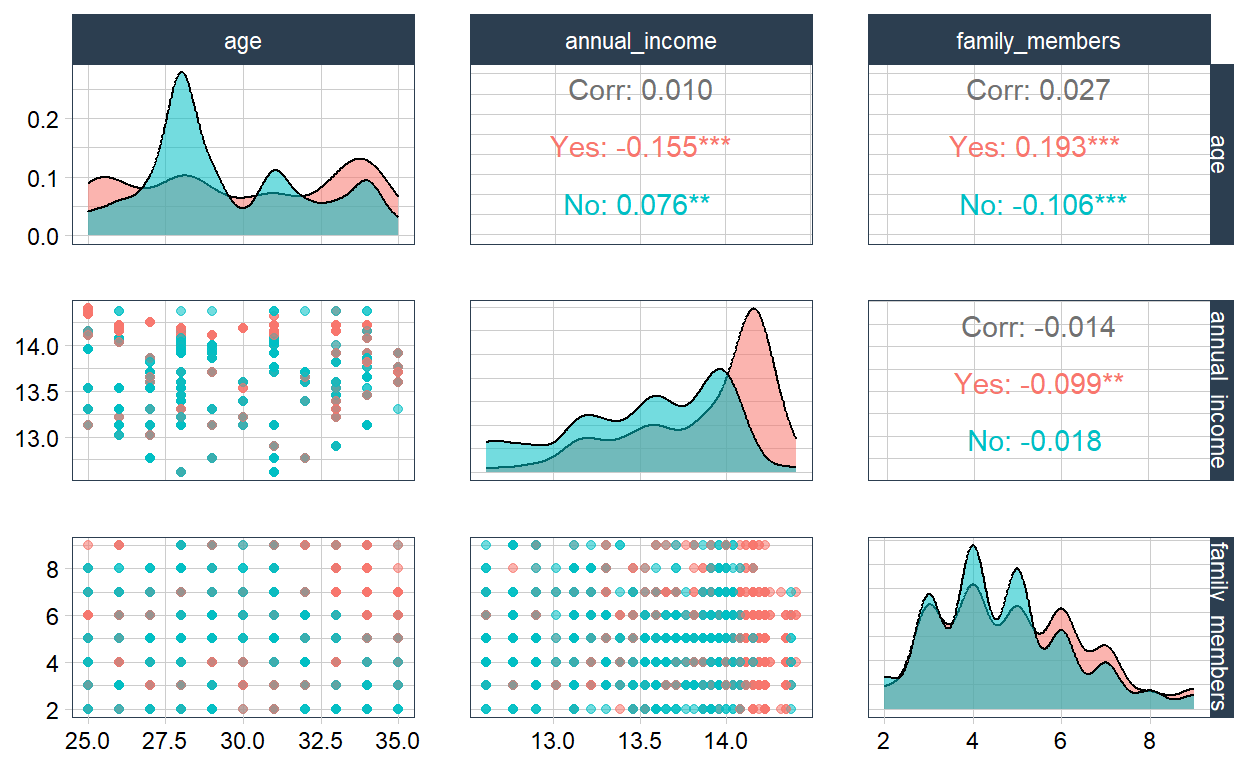
Se observa que las personas que aceptaron el seguro tienen un mayor ingreso anual con respecto a los que lo rechazaron, además, parece que las personas que rechazan el seguro en su mayoría son jóvenes. No se observa algún aspecto relevante sobre conocer la cantidad de miembros en la familia del cliente.
Verificar desbalanceo de clases
Es común encontrarse con datos desbalanceados en problemas de clasificación, esto sucede cuando la mayoría de los datos se concentran en una sola de las dos clases que se desean estudiar. A continuación, se verifica la proporción de personas que si aceptaron el seguro y de las que no lo aceptaron:
| Aceptación del Seguro | Cantidad | Proporción |
|---|---|---|
| Yes | 710 | 35.70% |
| No | 1.277 | 64.30% |
Parece que alrededor del 35% en los datos acepto el seguro, se puede considerar este porcentaje como un porcentaje de desbalanceo leve.
Partición de los datos
Entrenamiento y prueba
Realizar modelos de aprendizaje supervisado haciendo uso de todos los datos disponibles no suele ser una buena practica debido a que esto suele causar problemas de “sobre ajuste”. Es mejor particionar los datos en dos conjuntos, una para entrenar los modelos y otro para probar o testear los modelos, esto nos permitirá saber el desempeño de los modelos en datos nuevos.
La partición se realizó mediante un muestreo estratificado debido a que los datos están levemente desbalanceados y presentan mayor cantidad de personas que rechazaron el seguro, este enfoque nos permitirá mantener el mismo porcentaje de aceptación en las distintas particiones.
# Partición 80% / 20%
set.seed(1234)
split <- initial_split(data = dataset, prop = 0.80, strata = travel_insurance)
# Datos de entrenamiento
train_set <- training(split)| Aceptación del Seguro | Cantidad | Proporción |
|---|---|---|
| Yes | 568 | 35.70% |
| No | 1.021 | 64.30% |
# Datos de prueba
test_set <- testing(split)| Aceptación del Seguro | Cantidad | Proporción |
|---|---|---|
| Yes | 142 | 35.70% |
| No | 256 | 64.30% |
Validación cruzada
Aparte de particionar los datos en conjuntos de entrenamiento y prueba, el conjunto de entrenamiento se subdivide en 5 subconjuntos de datos, esto permite tener un mejor entendimiento del comportamiento de los modelos.
El proceso es ajustar los modelos en uno de los subconjuntos y utilizar los otros cuatros para computar métricas de rendimiento, este proceso se repite hasta que todos los subconjuntos sean utilizados para ajustar los modelos. Por lo general, luego se toma la media de las métricas de rendimiento de este proceso.
set.seed(1234)
folds <- vfold_cv(train_set, strata = travel_insurance, v = 5)

folds
# 5-fold cross-validation using stratification
# A tibble: 5 × 2
splits id
<list> <chr>
1 <split [1270/319]> Fold1
2 <split [1271/318]> Fold2
3 <split [1271/318]> Fold3
4 <split [1272/317]> Fold4
5 <split [1272/317]> Fold5Ingeniería de variables
En base a lo observado en el análisis exploratorio se creará un récipe con el pre procesamiento haciendo uso de ingeniería de variables para mejorar el desempeño de los algoritmos de Machine Learning.
Récipe de preprocesamiento
Debido a que los datos en estudios se encuentran levemente desbalanceados se realizan tres récipes con distintos enfoques:
- El primero es un recibe básico que incluye la transformación logarítmica del ingreso anual del cliente, la conversión de las variables categóricas a Dummy y normalizar todas las variables numéricas.
- El segundo récipe incluirá los pasos anteriores, pero, además, contempla un enfoque de sobremuestreo en la variable respuesta. Este enfoque aumenta las observaciones de la clase minoritaria hasta que tanto la clase minoritaria como la mayoritaria se distribuyan porcentualmente igual en los datos.
- Por último, el tercer récipe contempla un enfoque de submuestreo en la variable respuesta. Este enfoque elimina las observaciones de la clase mayoritaria hasta que tanto la clase minoritaria como la mayoritaria se distribuyan porcentualmente igual en los datos.
# récipe sin muestro
recipe <-
  recipe(travel_insurance ~ ., data = train_set) %>%
  step_log(annual_income) %>%
  step_dummy(all_nominal_predictors()) %>%
  step_normalize(all_numeric_predictors())

# récipe con sobremuestro (upsampling)
recipe_up <-
  step_upsample(recipe,
                travel_insurance,
                seed = 123)

# récipe con sub muestreo (downsampling)
recipe_down <-
  step_downsample(recipe,
                  travel_insurance,
                  seed = 123)
Modelo: Bosque aleatorio
A continuación, se procede a detallar la especificación del modelo que se utilizará. En este caso procederemos con modelo de Bosque Aleatorio ya que estos modelos son relativamente muy buenos para problemas de clasificación:
rf_spec <-
  rand_forest(trees = tune(),
              mtry = tune(),
              min_n = tune()) %>%
  set_engine("ranger", num.threads = 7, importance = "impurity") %>%
  set_mode("classification")
Optimización de hiperparámetros
Los tres hiperparámetros principales a ajustar en un modelo de Bosque Aleatorio son los siguientes:
-mtry: Número de variables predictoras que se muestrearán aleatoriamente en cada división al crear los modelos de árbol.
-trees: Número de árboles contenidos en el bosque.
-min_n: Número mínimo de puntos de datos en un nodo que se requieren para que el nodo se siga dividiendo.
Ajuste de hiperparámetros
Resultado del ajuste de los hiperparámetros:
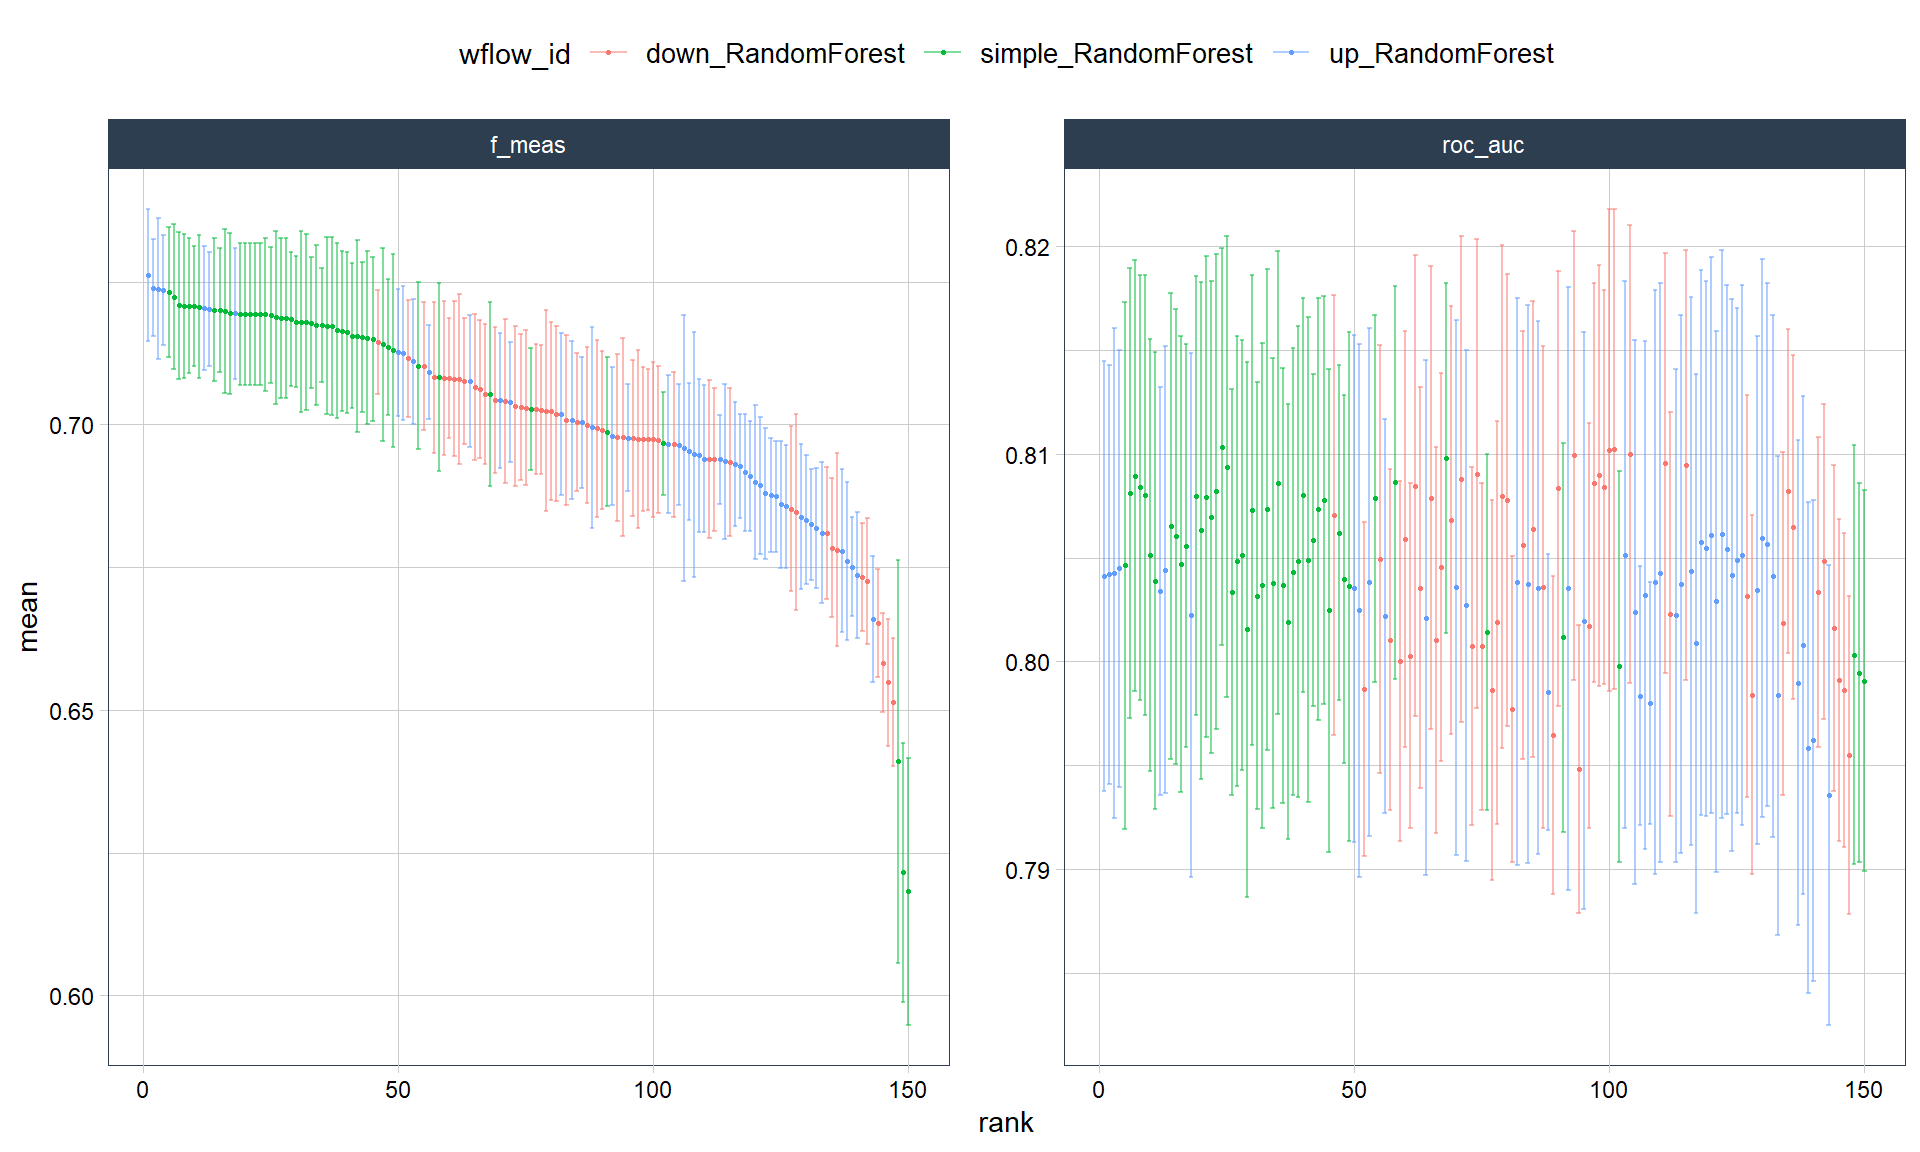
El mejor enfoque de preprocesamiento para abordar el desequilibrio de los datos es aquel que contempla el sobre muestreo de los datos de los clientes que adquirieron el nuevo producto ofrecido por la compañía. Procederemos con este enfoque y a continuación se mostrarán los resultados de los hiperparámetros en la validación cruzada:
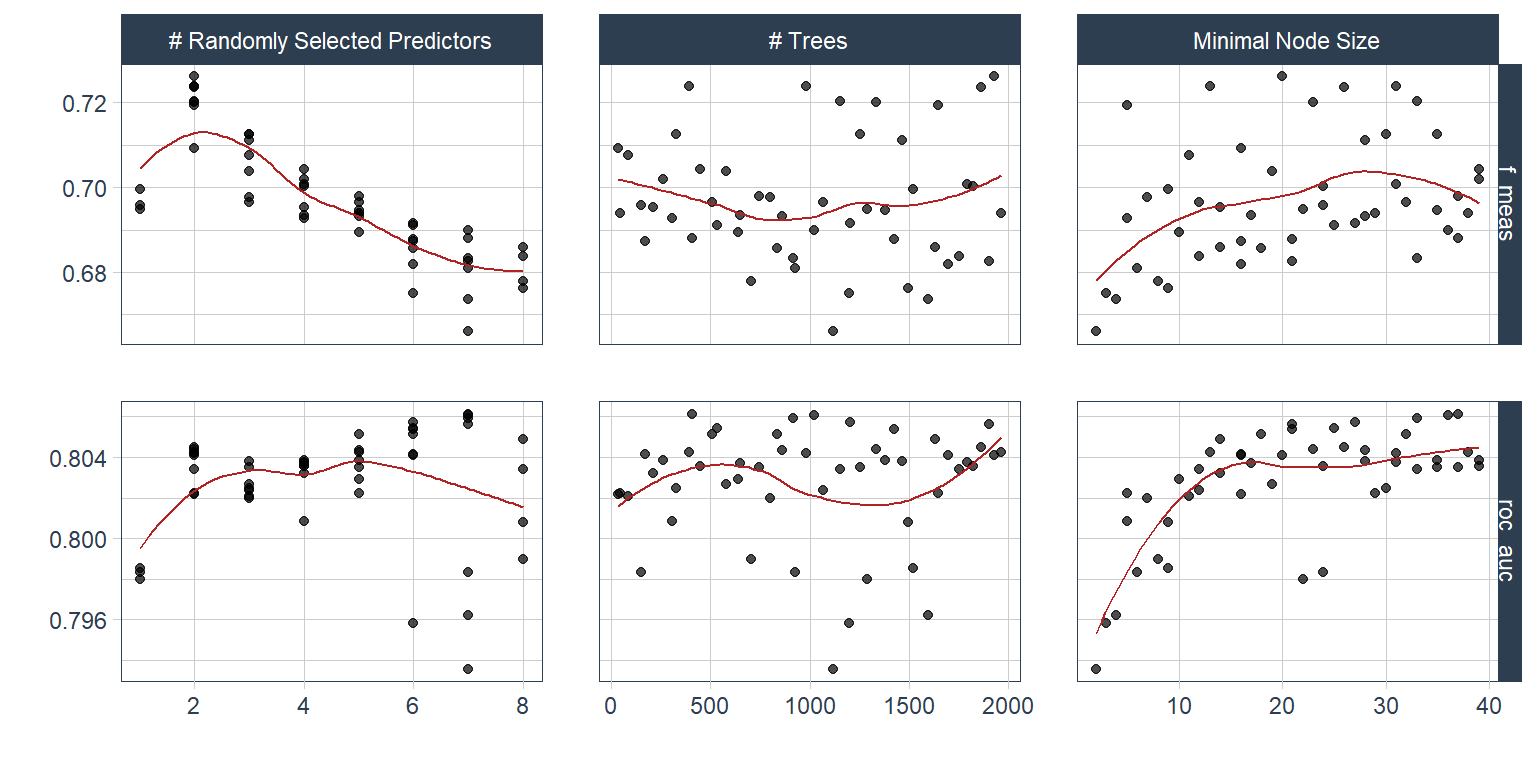
En ambas métricas se observan tendencias similares. Por ejemplo, parece que aumentar el número de árboles que tendrá el bosque no impacta en la precisión del modelo. Por otro lado, aumentar el número mínimo de datos requeridos para particionar un nodo sí tiene un impacto considerable en la precisión del modelo. A continuación, se muestra la mejor combinación de hiperparámetros para maximizar la métrica puntuación F1:
| .config | mtry | trees | min_n | F1 score |
|---|---|---|---|---|
| Preprocessor1_Model03 | 2 | 1929 | 20 | 0.7261143 |
Modelo final
Validación en conjunto de prueba
Por último, solo queda verificar el comportamiento de nuestro modelo en datos nunca antes vistos. Esto nos permitirá conocer cómo el modelo se comporta en un escenario real de predicción.
Observemos las distintas métricas de evaluación en el conjunto de prueba:
| Métrica | Resultado |
|---|---|
| f_meas | 68,57% |
| sensitivity | 59,15% |
| specificity | 92,58% |
| roc_auc | 80,56% |
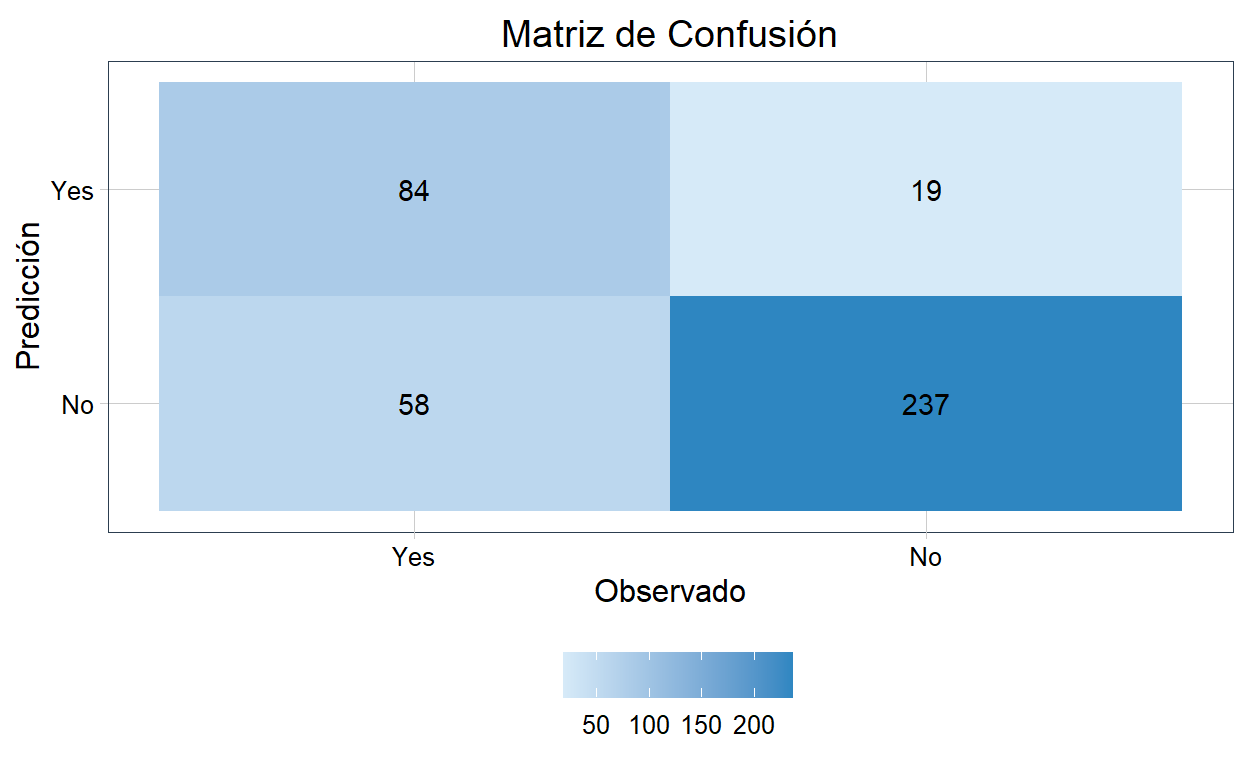
En el conjunto de prueba, el modelo de Bosque Aleatorio obtuvo una Tasa de Verdaderos Positivos de aproximadamente 59% y, por otro lado, una Tasa de Verdaderos Negativos del 92% aproximadamente. Esto nos indica que nuestro modelo tiene un buen desempeño al predecir qué clientes no estarán interesados en comprar el nuevo producto. Por último, se obtiene un área bajo la curva del 80%, por lo que se puede clasificar el modelo como moderadamente bueno.
Observemos la matriz de confusión:
Importancia de variables
La Importancia de Variables se refiere a la medida de la contribución de cada variable en la predicción del modelo. Los Bosques Aleatorios generan de manera implícita medidas de importancia para las variables del modelo, lo que permite identificar cuáles variables tienen un mayor impacto en la precisión de las predicciones.
La importancia de variables se puede visualizar mediante una gráfica de importancia relativa, donde se presentan los predictores en orden de su efecto en la mejora del modelo. La variable con la puntuación de mejora más alta se considera la más importante, y las demás variables se ordenan en función de su importancia relativa. Esta medida de importancia se estandariza para facilitar la interpretación y se calcula dividiendo la puntuación de importancia de cada variable entre la mayor puntuación de importancia y multiplicándola por 100%
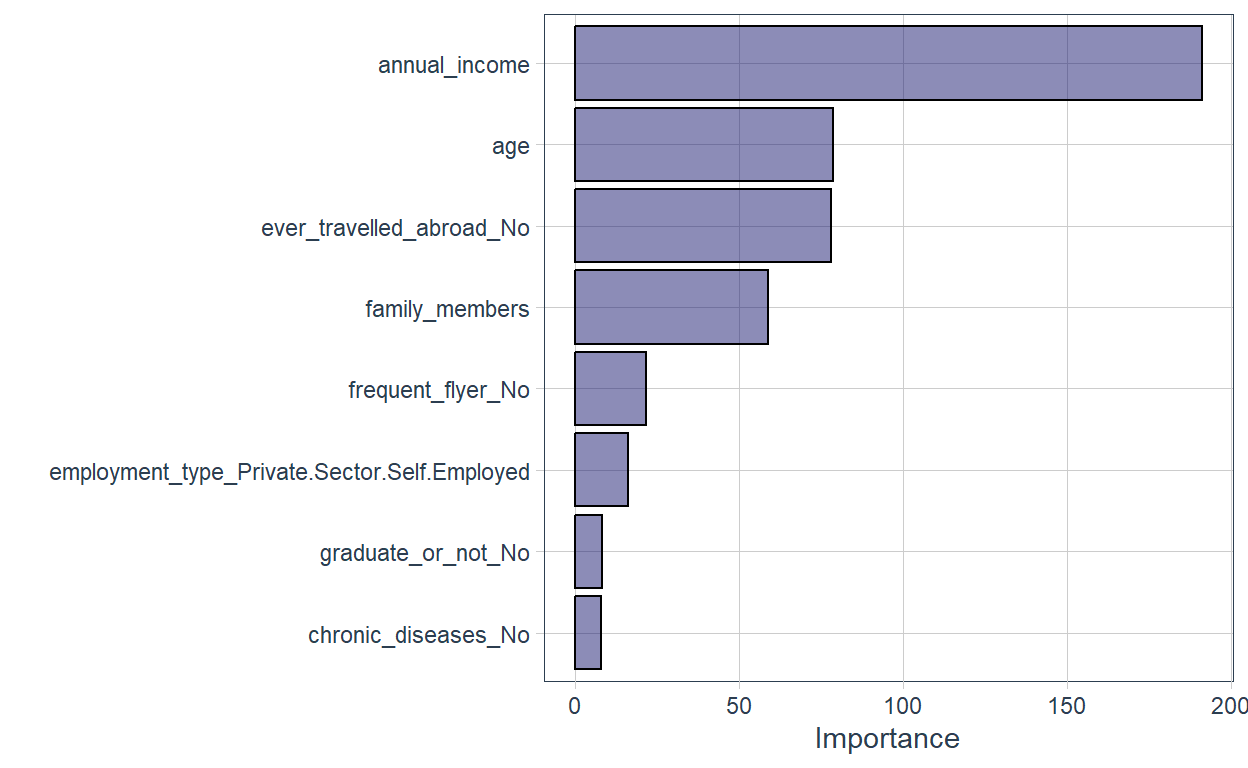
Parece que el ingreso anual del cliente es la principal variable para determinar si estará o no interesado en comprar el nuevo producto. Seguidamente, su edad y si alguna vez ha viajado con la compañía a un país extranjero.