Introducción
En este artículo, presentaré de manera introductoria un flujo de trabajo básico para la aplicación de modelos de Machine Learning a series de tiempo. Una serie de tiempo se define como un conjunto de datos recopilados de manera secuencial en intervalos regulares, como pueden ser datos diarios, mensuales o anuales. En su esencia, el análisis de las series de tiempo se aborda como un problema de regresión, enfocado en predecir el comportamiento futuro de la serie, basándose en sus valores históricos. Además, es posible incorporar variables exógenas que contribuyan a caracterizar su comportamiento
Datos
Los datos en estudio son la variación promedio mensual del tipo de cambio entre el Peso Chileno y el Dólar Estadounidense. Para llevar a cabo este análisis, se utilizarán datos históricos desde enero de 2010 hasta octubre de 2023. Estos datos han sido obtenidos del Banco Central de Chile. Esta información proporciona una perspectiva general sobre la evolución de la tasa de cambio a lo largo del tiempo y servirá como fundamento para la aplicación de modelos de Machine Learning, con el objetivo de realizar predicciones.
Análisis Exploratorio
A continuación, se analizará de manera breve y concisa el comportamiento de las principales características que conforman una serie de tiempo
Visualizar Histórico
Al visualizar la serie de tiempo, se puede observar una clara tendencia de crecimiento que parece seguir un comportamiento exponencial. Además, se identifican ciertos patrones que podrían deberse a fenómenos cíclicos o estacionales. Ante esta tendencia de crecimiento, es importante destacar que la serie no es estacionaria. Para poder aplicar modelos como ARIMA, será necesario aplicar transformaciones y diferenciar la serie hasta lograr su estacionariedad.
Patrones Estacionales
Los patrones estacionales son fluctuaciones regulares que ocurren en una serie de tiempo en intervalos de tiempo fijos, como anualmente, trimestralmente, mensualmente u otros. El análisis de estos patrones es fundamental para comprender las variaciones regulares en los datos y poder predecir su comportamiento futuro.
Es evidente que anualmente se observa un crecimiento en la mediana, el cual es más notable en los años 2015, 2021 y 2022. En el último trimestre de estos años se visualiza un incremento aún mayor en la mediana, así como los valores máximos más altos. Es interesante destacar que los años más recientes de la serie presentan los mayores valores. Por lo tanto, se podría esperar un aumento en el tipo de cambio entre el peso y el dólar en los años futuros.
Detección de Anomalías
La detección de anomalías consiste en identificar puntos o eventos inusuales en una serie de tiempo. Estas anomalías pueden manifestarse como valores atípicos o cambios abruptos e inesperados en los datos. El objetivo de la detección de anomalías es identificar y comprender las causas detrás de estos eventos inusuales, ya que pueden indicar la presencia de problemas o situaciones importantes que requieren atención.
En relación a los datos históricos, parece que no hay ningún cambio promedio mensual que pueda considerarse anómalo. Este método de detección de anomalías utiliza un rango intercuartil (IQR) de +/- 25% de la mediana.
Análisis de Autocorrelación
El análisis de autocorrelación se utiliza para estudiar la relación entre los valores pasados y presentes de una serie de tiempo. Permite identificar patrones de dependencia y correlación entre los diferentes puntos de datos en la serie. Este análisis es útil para determinar si existe una relación significativa entre los valores de una serie de tiempo en diferentes momentos, así como para identificar posibles modelos de pronóstico.
A continuación, se aplica el test de raíz unitaria de Phillips-Perron a la serie en estudio después de aplicar la diferenciación, con el objetivo de comprobar la estacionariedad
    Augmented Dickey-Fuller Test

data:  diff(dat$value)
Dickey-Fuller = -5.1467, Lag order = 5, p-value = 0.01
alternative hypothesis: stationary
Existen suficientes evidencias estadísticas para rechazar la hipótesis nula con un nivel de significancia del 5%. Por lo tanto, se puede afirmar que la serie es estacionaria.
A continuación, se visualizan las funciones de autocorrelación (ACF) y autocorrelación parcial (PACF):
Casi ningún retardo supera las bandas de significancia tanto en la función de autocorrelación simple como en la función de autocorrelación parcial. Esto sugiere que no parece haber una relación lineal entre los valores actuales y los valores pasados. Sin embargo, es importante tener en cuenta que este análisis no puede capturar otras relaciones más allá de la lineal, lo cual es especialmente limitante para modelos como ARIMA.
Partición en Entrenamiento y Prueba
Antes de proceder a plantear modelos para pronosticar la serie, es importante particionarla en dos conjuntos. El primer conjunto se utilizará para entrenar los distintos algoritmos, mientras que el segundo se empleará para evaluar la precisión de dichos algoritmos y determinar cuál es el más preciso.
Se dejan los últimos doce meses de histórico para evaluar los modelos.
Modelos Estadísticos
Como primer alcance, se aplicara algoritmos para la selección automática de modelos estadísticos ARIMA y Suavizamiento Exponencial.
A continuación, se muestra el resultado de utilizar estos modelos para pronosticar el periodo de prueba.
Es evidente que los modelos con enfoque lineal no lograron adaptarse a los patrones observados en la serie en estudio. Se calcularon diferentes métricas de error que servirán como base para evaluar los próximos modelos y determinar si se puede lograr una mayor precisión.
| Metricas de Evaluación | ||||
| .model_id | .model_desc | mae | rmse | mape |
|---|---|---|---|---|
| 1 | ARIMA(0,1,0) WITH DRIFT | 132.82 | 140.45 | 16.09 |
| 2 | ETS(M,N,N) | 113.48 | 122.32 | 13.79 |
La métrica MAE (Error Absoluto Medio) de 132.82 indica que, en promedio, el error absoluto de las predicciones es de 132.82 pesos por dólar. Esta métrica es útil para evaluar la precisión general del modelo, ya que no tiene en cuenta la dirección del error.
La métrica RMSE (Error Cuadrático Medio) de 140.45 indica que, en promedio, el error cuadrático de las predicciones es de 140.45 pesos por dólar. Esta métrica es similar al MAE, pero penaliza los errores más grandes debido al cuadrado en el cálculo. Es especialmente útil cuando se desea dar más peso a los errores grandes.
El MAPE (Error Porcentual Absoluto Medio) de 16.09 indica que, en promedio, el error porcentual absoluto de las predicciones es del 16.09%. Esta métrica es útil para evaluar la precisión relativa del modelo, ya que muestra el error en términos porcentuales en relación con los valores reales. Un MAPE bajo indica una mayor precisión del modelo.
Ingeniería de Variables
Antes de aplicar modelos de Machine Learning, es crucial adaptar los datos a un formato comprensible para dichos modelos. Esto implica la extracción de variables a partir de la fecha, como el mes del año, el trimestre o el semestre, así como el año en que se realizó la medición. Además, se pueden utilizar valores retardados de la serie como variables predictoras, y convertir los meses del año en variables dummy. Esta transformación de los datos es fundamental para garantizar que los modelos puedan capturar y aprovechar la información relevante en los datos temporales.
A continuación, se muestra el resultado de un preprocesamiento basico para aplicar modelos de ML a series de tiempo:
Rows: 154
Columns: 16
$ value          <dbl> 500.6625, 532.5570, 523.1626, 520.6243, 533.2…
$ month          <dbl> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 1, 2, …
$ date_quarter   <int> 1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4, 1, 1, 1, …
$ date_semester  <int> 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 2, 1, 1, 1, …
$ date_year      <int> 2010, 2010, 2010, 2010, 2010, 2010, 2010, 201…
$ date_month_Feb <dbl> 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, …
$ date_month_Mar <dbl> 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, …
$ date_month_Apr <dbl> 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ date_month_May <dbl> 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ date_month_Jun <dbl> 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, …
$ date_month_Jul <dbl> 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, …
$ date_month_Aug <dbl> 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, …
$ date_month_Sep <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, …
$ date_month_Oct <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, …
$ date_month_Nov <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, …
$ date_month_Dec <dbl> 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, …
Modelos de Machine Learning
Los modelos de Machine Learning que serán aplicados a la serie en estudio son:
- Bosques aleatorios.
- XGboost.
- Regresión Elástica con Regularización (GlmNet).
- LightGBM.
En este alcance no se contempla una optimización de los hiperparámetros que tiene cada modelo, únicamente se aplican con sus valores por defecto. Es importante tener en cuenta que la falta de optimización de los hiperparámetros puede afectar la precisión de los modelos. Sin embargo, este enfoque inicial nos permite obtener una referencia de rendimiento antes de realizar ajustes adicionales.
A continuación, se muestra el resultado de emplear estos modelos para pronosticar el periodo de prueba:
Visualmente es obvio que estos modelos pudieron adaptarse y predecir con mayor precisión el conjunto de prueba. No obstante, es importante analizar las métricas de error para una evaluación más precisa:
| Métricas de Evaluación | ||||
| .model_id | .model_desc | mae | rmse | mape |
|---|---|---|---|---|
| 1 | ARIMA(0,1,0) WITH DRIFT | 132.82 | 140.45 | 16.09 |
| 2 | ETS(M,N,N) | 113.48 | 122.32 | 13.79 |
| 3 | GLMNET | 36.65 | 42.83 | 4.29 |
| 4 | RANDOMFOREST | 56.46 | 65.24 | 6.56 |
| 5 | XGBOOST | 42.95 | 57.11 | 5.11 |
| 6 | LIGHTGBM | 38.27 | 45.20 | 4.46 |
Es impresionante observar cómo los modelos LigthtGBM y GLMNet lograron una disminución en el RMSE de casi el -70% ¡Esto se traduce en un aumento exponencial en la precisión en comparación con un modelo base como ARIMA!.
Si ordenamos en un ranking de los modelos desde la perspectiva del RMSE obtemos los siguientes resultados:
| Métricas de Evaluación | ||||
| .model_id | .model_desc | mae | rmse | mape |
|---|---|---|---|---|
| 3 | GLMNET | 36.65 | 42.83 | 4.29 |
| 6 | LIGHTGBM | 38.27 | 45.20 | 4.46 |
| 5 | XGBOOST | 42.95 | 57.11 | 5.11 |
| 4 | RANDOMFOREST | 56.46 | 65.24 | 6.56 |
| 2 | ETS(M,N,N) | 113.48 | 122.32 | 13.79 |
| 1 | ARIMA(0,1,0) WITH DRIFT | 132.82 | 140.45 | 16.09 |
Apliquemos los dos modelos más precisos para realizar un pronostico en un horizonte de doce meses y evaluar los resultados.
Ambos modelos sigue la misma tendencia, no obstante, el modelo ligthGBM parace entender más el patrón de caida que presenta la serie. Sin embargo, siguiendo el principio “Todos los modelos están equivocados, pero algunos son útiles.” del estadístico George Box, podemos combinar ambos modelos simplemente promediando sus resultados y evaluar si esto conlleva a una mayor precisión. Esto se llama un ensamble de modelos y este enfoque es bastante sencillo con respecto a lo que se puede lograr mediante esta metodología.
A continución, se muestra el resultado en el conjunto de prueba del modelo combinado ligthGBM + GLMNet mediante un promedio simple.
Observemos el resultado de las métricas de evaluación para poder determinar si la combinación de modelos es eficaz:
| Accuracy Table | |||||
| .model_id | .model_desc | .type | mae | rmse | mape |
|---|---|---|---|---|---|
| 1 | ENSEMBLE (MEAN): 2 MODELS | Test | 28.19 | 38.74 | 3.22 |
| 2 | ARIMA(0,1,0) WITH DRIFT | Test | 132.82 | 140.45 | 16.09 |
| 3 | ETS(M,N,N) | Test | 113.48 | 122.32 | 13.79 |
| 4 | GLMNET | Test | 36.65 | 42.83 | 4.29 |
| 5 | RANDOMFOREST | Test | 56.46 | 65.24 | 6.56 |
| 6 | XGBOOST | Test | 42.95 | 57.11 | 5.11 |
| 7 | LIGHTGBM | Test | 38.27 | 45.20 | 4.46 |
Se obtiene un reducción de MAE del -23% con respecto al modelo más preciso (GLMnet) y en terminos del RMSE, se obtiene un reducción del -9%. Queda demostrado que combinar los modelos más precisos conlleva a mejores resultados. Ahora bien, solo queda emplear dicha combinación de modelos para pronosticar el futuro:
Optimización de Hiperparámetros
En el campo del Machine Learning, todos los modelos cuentan con hiperparámetros, los cuales son variables de configuración externa que se pueden modificar para mejorar su rendimiento de los modelos. Este proceso implica seleccionar una métrica de error y probar diferentes combinaciones de hiperparámetros, ya sea de forma aleatoria o utilizando algoritmos o metodologías específicas para seleccionar la combinación que logra minimizar la métrica de error escogida.
Para llevar a cabo este ajuste de hiperparámetros, es necesario dividir los datos en conjuntos separados. Luego, cada conjunto se utiliza para ajustar el modelo con una combinación determinada de hiperparámetros, y posteriormente, se utiliza ese modelo para predecir los conjuntos de datos restantes. De esta manera, se obtiene un resultado confiable sobre cómo los hiperparámetros afectan el rendimiento del modelo. En el caso de las series de tiempo, es importante tener en cuenta la temporalidad que caracteriza a la serie.
A continuación, se muestra visualmente el proceso de validación cruzada que se empleará para optimizar los hiperparámetros:
En los resultados previos, se pudo observar que el modelo XGBoost quedó en el puesto número tres (3) desde la perspectiva de los modelos que minimizan el RMSE. Sin embargo, ¿será posible mejorar este resultado realizando la optimización de los hiperparámetros de este modelo? A continuación, se especifican los hiperparámetros que serán optimizados:
xgboost_model <-
  boost_tree(trees = 1000,
             tree_depth = tune(),
             mtry = tune(),
             min_n = tune(),
             learn_rate = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) %>%
  set_engine("xgboost") %>%
  set_mode("regression")
Se ha decidido realizar la optimización de siete (7) hiperparámetros distintos. Para este proceso, se utilizarán 50 posibles combinaciones que han sido seleccionadas mediante un método de llenado de espacio. Si deseas obtener más información acerca de esta metodología, puedes consultar aquí
A continuación, resultado del proceso de ajuste de hiperparámetros:
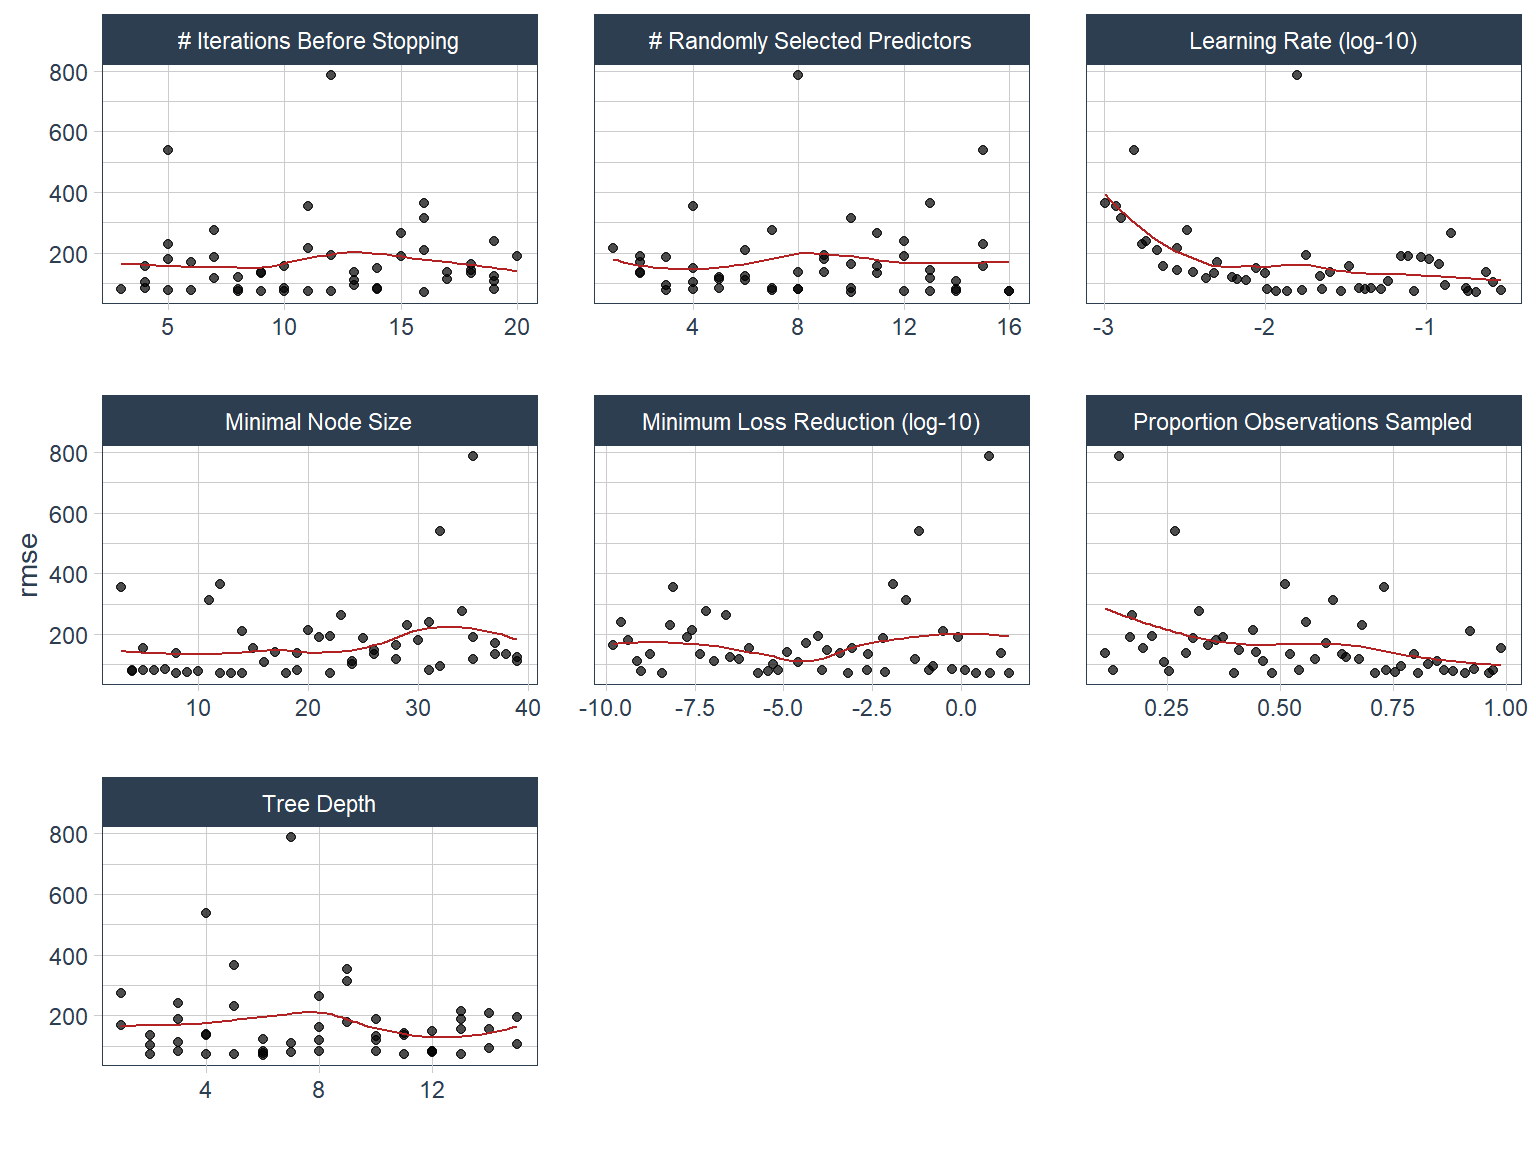
Algunos hiperparámetros muestran una clara tendencia donde al aumentar o disminuir su valor, la métrica de error seleccionada disminuye o aumenta. Sin embargo, hay otros hiperparámetros que no muestran una tendencia clara en relación a la métrica de error. La mejor combinación se determina viendo el resultado del RMSE promedio en el conjunto de validación cruzada.
A continuación, se muestra el resultado en el conjunto de prueba del modelo seleccionado mediante el ajuste de hiperparámetros:
¿Se habrá mejorado el modelo XGBoost en términos del RMSE después de este proceso?
| Metrícas de Evaluación | |||||
| .model_id | .model_desc | .type | mae | rmse | mape |
|---|---|---|---|---|---|
| 1 | XGBOOST | Test | 24.12 | 28.78 | 2.84 |
¡El RMSE del modelo XGboots con optimización de hiperparámetros disminuye el RMSE en casi un -50% con respecto al modelo XGboost inicial!. Por último, solo queda aplicar este modelo para pronósticar el futuro: