Introducción
En las últimas semanas, he estado investigando sobre los métodos de regularización en modelos de regresión. Estos métodos mejoran la capacidad de generalización de un modelo de regresión y ayudan a prevenir el sobreajuste. Además, presentan un menor costo computacional en comparación con otros modelos de Aprendizaje Automático.
Dos técnicas comunes de regularización son la regresión Lasso y Ridge:
- Regresión Lasso:
- Añade un término de penalización proporcional al valor absoluto de las coeficientes del modelo.
- Promueve que algunos coeficientes se conviertan exactamente cero.
- Elimina eficazmente las variables penalizadas.
- Puede ser un método automatizado de selección de variables.
- Regresión Ridge:
- Añade un término de penalización proporcional al cuadrado de los coeficientes del modelo.
- No reduce algunos coeficientes a cero como la regresión Lasso.
- Puede reducir eficazmente el sobreajuste.
Como todo método, tiene sus ventajas y desventajas. La principal ventaja es que al penalizar los coeficientes se evita el sobreajuste. Sin embargo, esto implica que no se pueden utilizar para realizar inferencias, sino que su principal capacidad radica en el aumento de la presición del modelo.
La regresión Lasso es preferible cuando se cuenta con un número limitado de variables predictoras que son significativas dentro de un modelo de regresión. Esto se debe a que la regresión Lasso puede eliminar de manera efectiva las variables no significativas del modelo. Por otro lado, cuando se tiene un gran número de variables significativas en el modelo, es preferible utilizar el método Ridge.
Otro modelo existente es la Regresión Lineal Elástica la cual utiliza las penalizaciones del método Lasso y Ridge para regularizar el modelo de regresión.
Dataset
Los datos se han extraído de la conocida comunidad de científicos de datos Kaggle y se hará uso del ecosistema de paquetes que ofrece Tidymodels.
Los datos constan de 7 variables, que se describen a continuación:
- Edad: edad del beneficiario principal.
- Sexo: sexo del contratante del seguro (mujer u hombre).
- IMC: índice de masa corporal.
- Hijos: Número de hijos cubiertos por el seguro de enfermedad / Número de personas a cargo.
- Fumador: Condición de fumador activo.
- Región: zona de residencia del beneficiario en EE.UU. (noreste, sureste, suroeste o noroeste).
- Gastos: Gastos médicos individuales facturados por el seguro de enfermedad.
Análisis Exploratorio
Antes de empezar a establecer cualquier tipo de modelo, es necesario explorar los datos para determinar si hay incoherencias en ellos, como valores que faltan, y también para entender un poco cómo se ve afectada la variable respuesta (costo del seguro) por todas las demás variables.
Utilizando la función skim del paquete skimr podemos obtener una visión general de todas las variables de los datos.
| Name | data |
| Number of rows | 1338 |
| Number of columns | 8 |
| _______________________ | |
| Column type frequency: | |
| character | 3 |
| numeric | 5 |
| ________________________ | |
| Group variables | None |
Variable type: character
| skim_variable | n_missing | complete_rate | min | max | empty | n_unique | whitespace |
|---|---|---|---|---|---|---|---|
| sex | 0 | 1 | 4 | 6 | 0 | 2 | 0 |
| smoker | 0 | 1 | 2 | 3 | 0 | 2 | 0 |
| region | 0 | 1 | 9 | 9 | 0 | 4 | 0 |
Variable type: numeric
| skim_variable | n_missing | complete_rate | mean | sd | p0 | p25 | p50 | p75 | p100 |
|---|---|---|---|---|---|---|---|---|---|
| index | 0 | 1 | 668.50 | 386.39 | 0.00 | 334.25 | 668.50 | 1002.75 | 1337.00 |
| age | 0 | 1 | 39.21 | 14.05 | 18.00 | 27.00 | 39.00 | 51.00 | 64.00 |
| bmi | 0 | 1 | 30.66 | 6.10 | 15.96 | 26.30 | 30.40 | 34.69 | 53.13 |
| children | 0 | 1 | 1.09 | 1.21 | 0.00 | 0.00 | 1.00 | 2.00 | 5.00 |
| charges | 0 | 1 | 13270.42 | 12110.01 | 1121.87 | 4740.29 | 9382.03 | 16639.91 | 63770.43 |
No hay valores perdidos en ninguna de las variables. En promedio, todos los asegurados tienen al menos un hijo, aunque hay muchos asegurados sin hijos, también se observa que en general las personas registradas en los datos padecen obesidad (bmi >= 30 se clasifica como obeso).
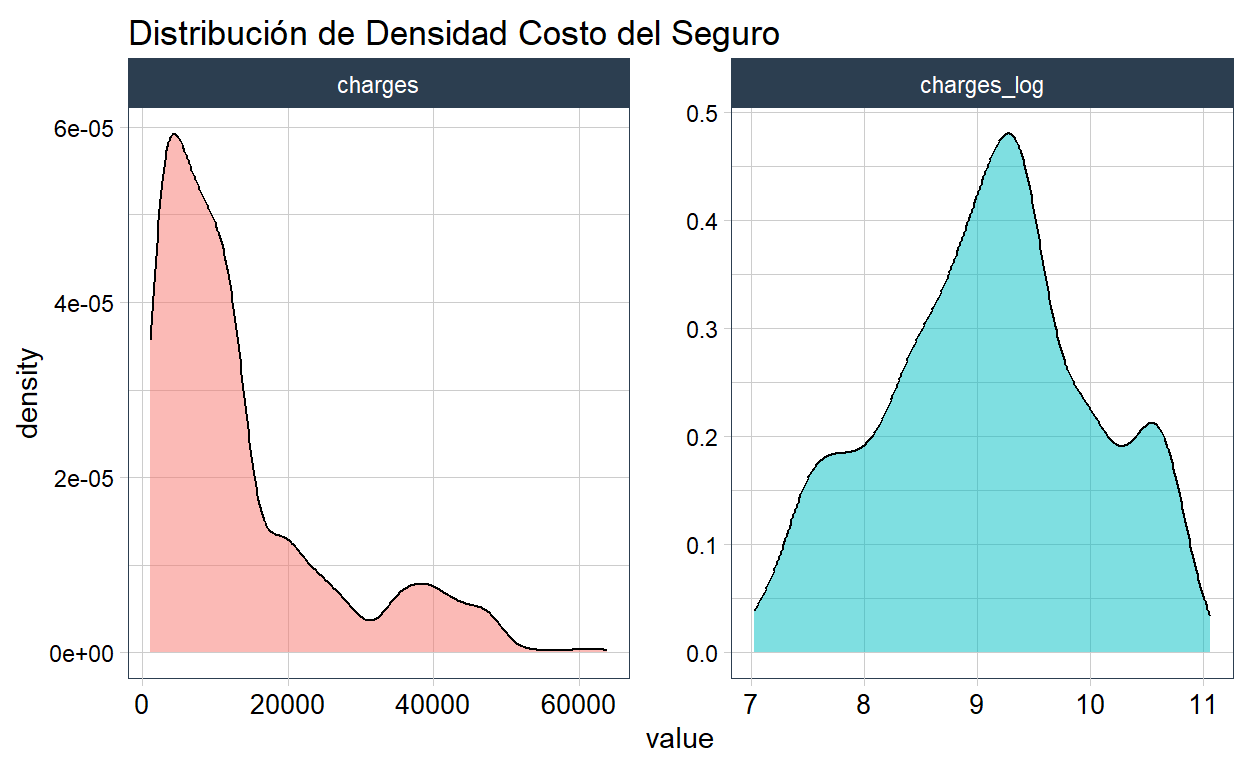
Antes de analizar las relaciones existentes en los datos, es importante observar la distribución de nuestra variable respuesta (costo del seguro). Es común que las variables monetarias tengan un sesgo hacia la derecha en su distribución, por lo tanto, se emplea una transformación logarítmica para estabilizar la varianza y normalizar los datos. A continuación, se presentan las visualizaciones de ambas distribuciones.
Ahora bien, se puede proceder a analizar la relaciones existentes en los datos.
Sexo del Asegurado
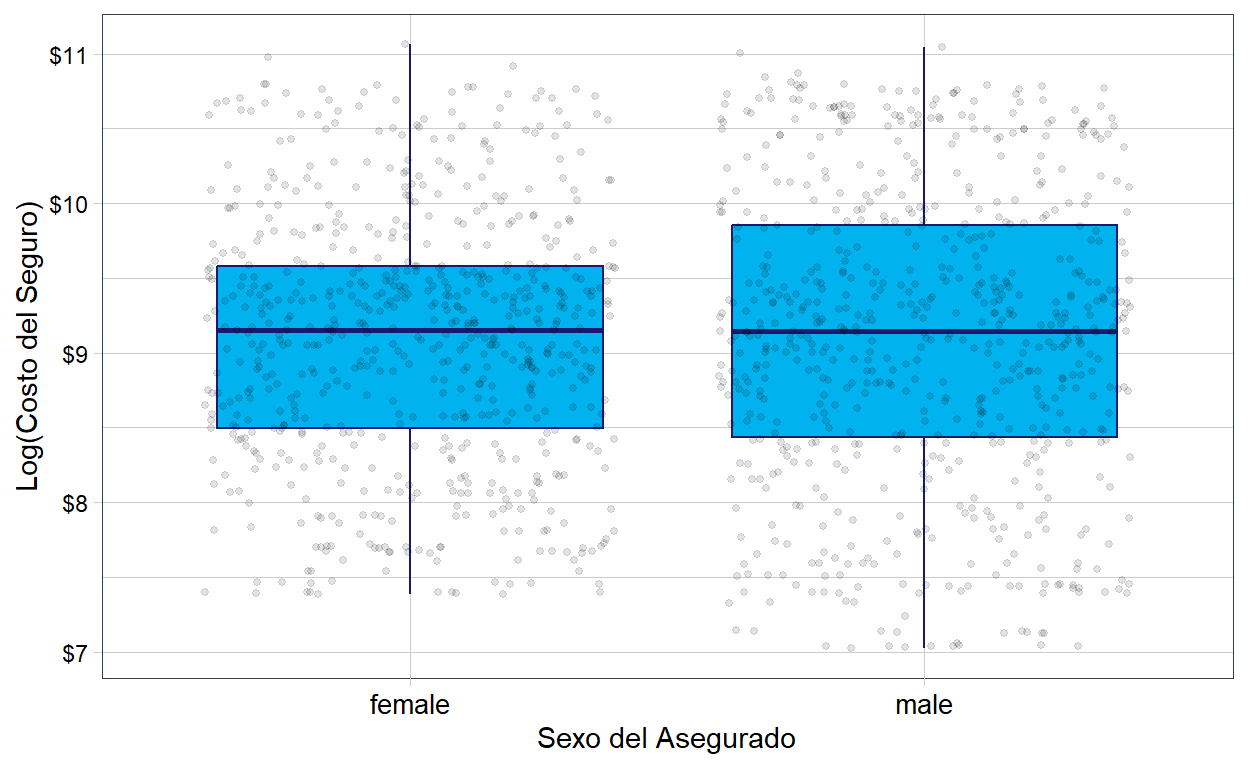
No se observan cambios en el costo del seguro por sexo.
¿Es Fumador el Asegurado?
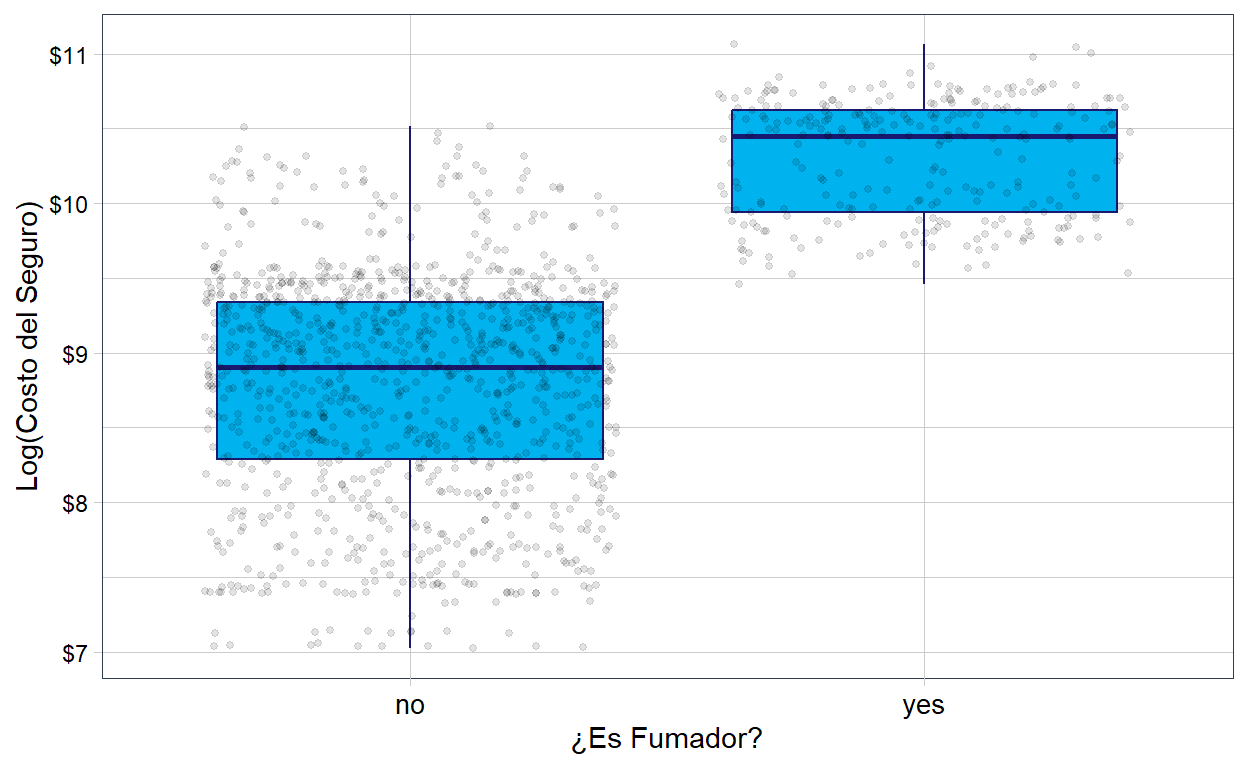
Parece que si el asegurado fuma, tendrá costos de seguro más elevados. Esta afirmación parece obvia porque fumar influye en la salud y afecta al organismo.
¿Existe alguna relación entre el sexo del asegurado y el hecho de que sea o no fumador activo?
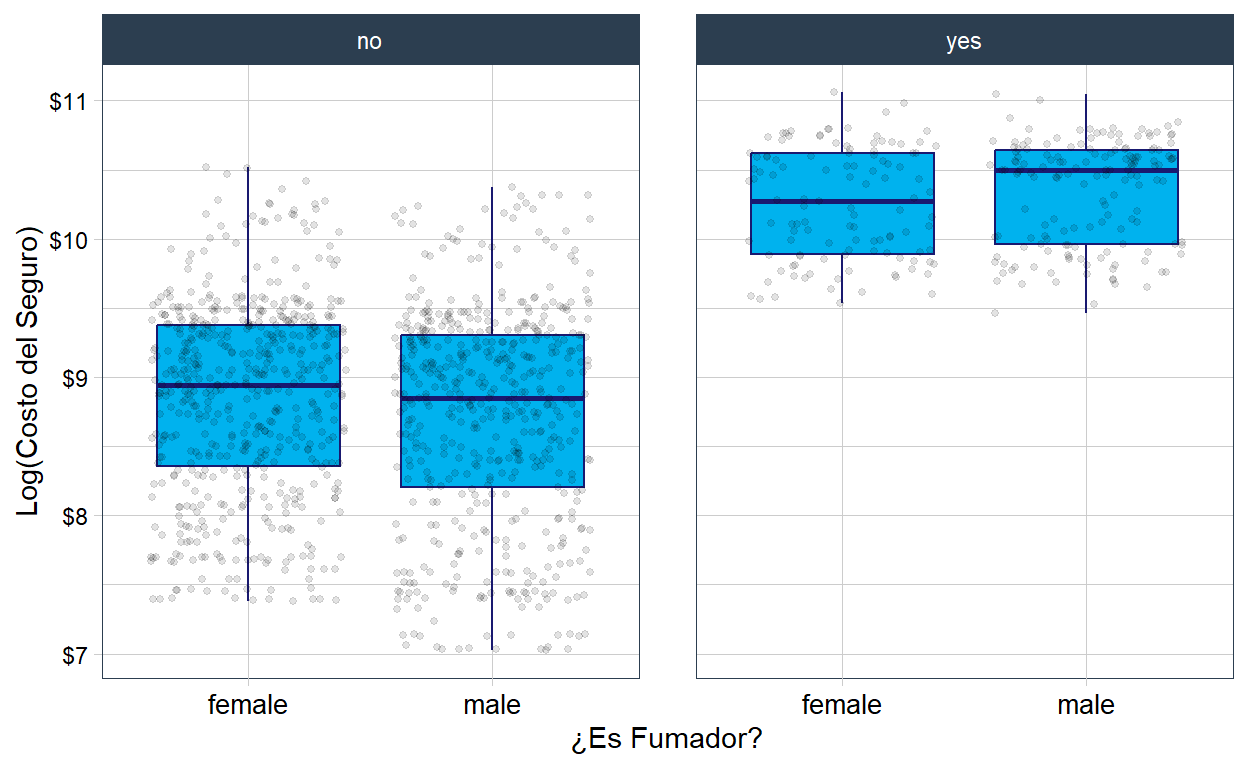
No se observa un cambio relevante en el costo del seguro en estas variables.
Región de Residencia
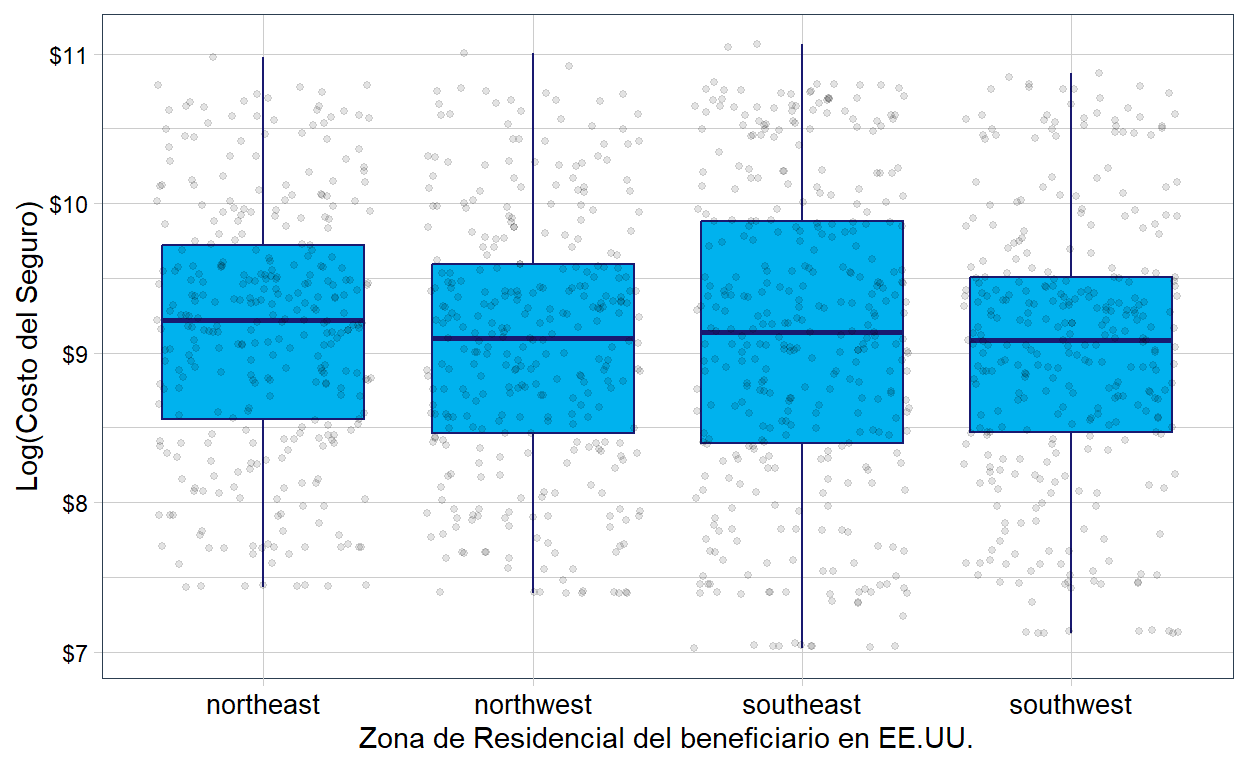
No se observan cambios relevantes en el costo del seguro con respecto a la región de residencia del asegurado.
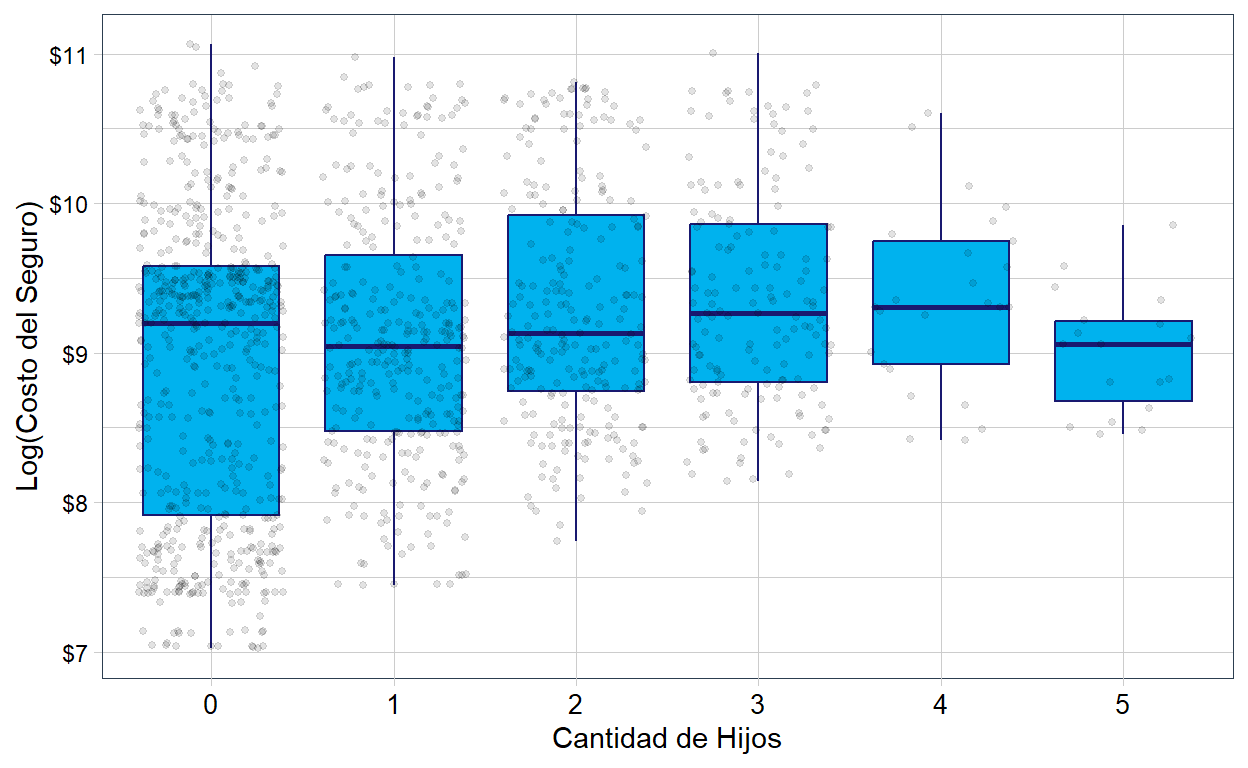
Cantidad de Hijos
Índice de Masa Corporal / ¿Es Fumador el Asegurado?
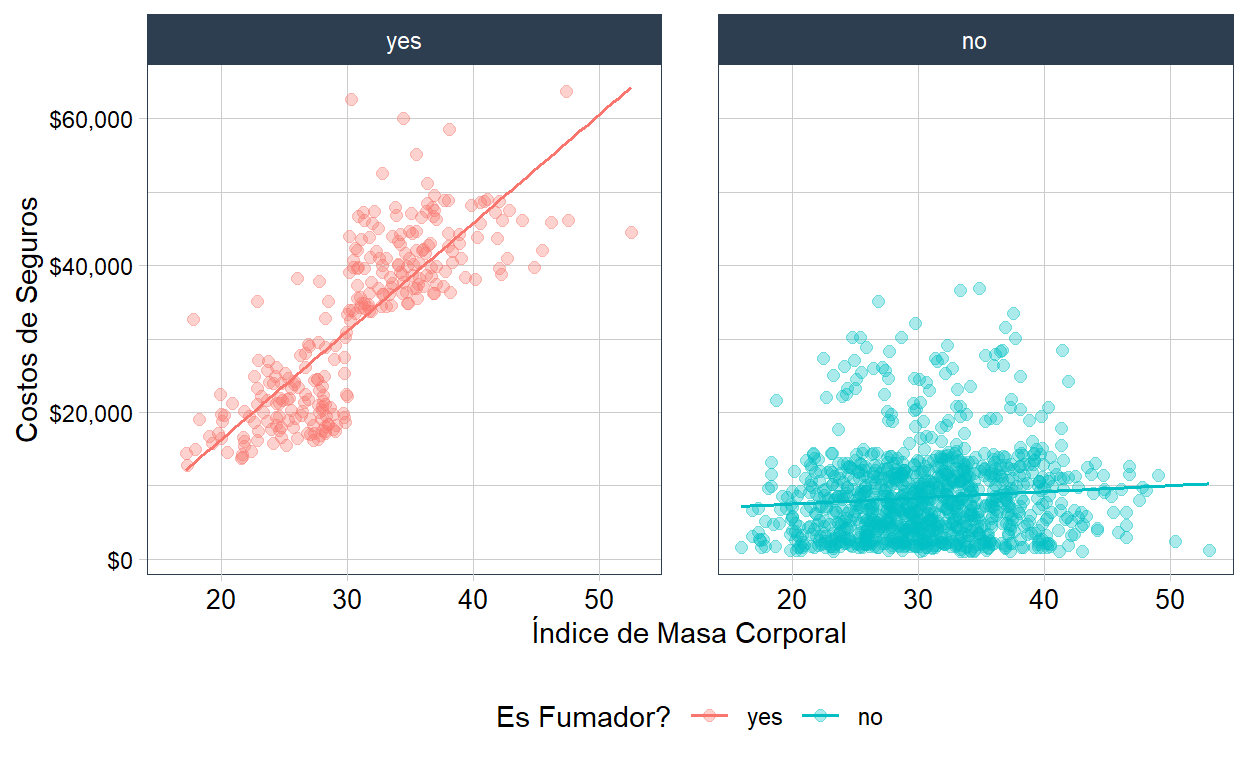
Existe una interacción entre estas variables que demuestra diferencias en el coste médico medio.
Edad del Asegurado / ¿Es Fumador el Asegurado?
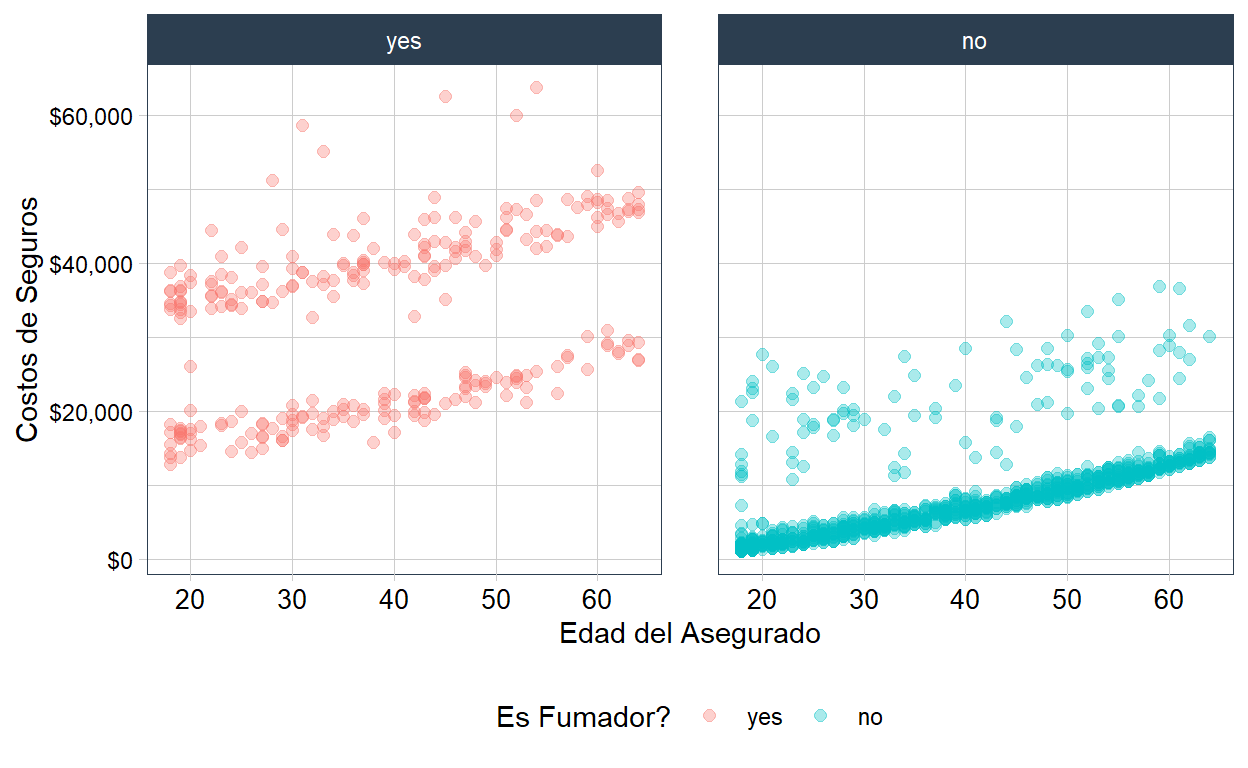
Al igual que en el paso anterior, parece que aquí tenemos otra interacción evidente entre estas variables con respecto al coste médico.
Partición de los datos
Entrenamiento y prueba
Se particionan los datos en dos conjuntos. El primero para ser utilizado en el entrenamiento de los modelos y el segundo para probar el resultado de dichos modelos.
set.seed(1234)
split <-
  mutate_at(.tbl = data,
            vars(charges),
            .funs = log) %>%
  initial_split(prop = 0.80,
                strata = charges)

test <- testing(split)
train <- training(split)
Los modelos que se utilizarán contemplan hiperparámetros que serán ajustados por ende. También es necesario crear una validación cruzada del conjunto de entrenamiento para este proceso.
set.seed(1234)
folds <- vfold_cv(data = train, strata = smoker)
Ingeniería de variables
A partir de lo observado en el análisis exploratorio, se creará una receta con el preprocesamiento mediante ingeniería de variables.
A continuación se explican los pasos que se incluirán en la receta para el preprocesamiento de datos:
Se realiza la transformación logarítmica sobre la variable respuesta. - Se crea dos nuevas variables categóricas que indica si el asegurado puede clasificarse como obeso según su índice de masa corporal y si tiene hijos o no. - Todas las variables categóricas se convierten en Dummy. - Se normalizan todas las variables predictoras. - Por último, se crean las interacciones observadas en el análisis exploratorio de los datos.
recipe <-
  recipe(charges ~., data = train) %>%
  update_role(index, new_role = "ID") %>%
  step_mutate(children_status = if_else(children == 0, "Not Have", "Have"),
              is_obsessive = if_else(bmi > 30, "Yes", "No")) %>%
  step_string2factor(all_nominal_predictors()) %>%
  step_dummy(all_nominal_predictors()) %>%
  step_interact(terms = ~ smoker_yes:bmi) %>%
  step_interact(terms = ~ smoker_yes:age) %>%
  step_normalize(all_numeric_predictors())
Especificación de modelos
Ya teniendo la receta con el preprocesamiento de los datos, sólo falta establecer el flujo de trabajo de los modelos que se utilizarán. Como previamente fue mencionado se crearán worflows para modelos Lasso, Ridge y Elactic Net, adicionalmente a modo de comparativo se utilizarán también un arbol de decisión y un modelo de k vecinos.
ridge_spec <-
  linear_reg(penalty = tune(), mixture = 0) %>%
  set_mode("regression") %>%
  set_engine("glmnet")

lasso_spec <-
  linear_reg(penalty = tune(), mixture = 1) %>%
  set_mode("regression") %>%
  set_engine("glmnet")

glmnet_spec <-
  linear_reg(penalty = tune(),
             mixture = tune()) %>%
  set_engine("glmnet") %>%
  set_mode("regression")

knn_spec <-
  nearest_neighbor(neighbors = tune(),
                   weight_func = tune(),
                   dist_power = tune()) %>%
  set_engine("kknn") %>%
  set_mode("regression")

cart_spec <-
  decision_tree(cost_complexity = tune(),
                min_n = tune(),
                tree_depth = tune()) %>%
  set_engine("rpart") %>%
  set_mode("regression")
Ajuste de hiperparámetros
A continuación, se realiza el ajuste de los hiperparámetros para cada uno de los modelos. Aun cuando el dataset es bastante pequeño, tenemos 5 modelos y un total de 10 conjuntos de validación cruzada para este proceso. Esto implica que si deseamos probar 50 combinaciones de hiperparámetros, se deben ajustar 5 * 10 * 50 = 2500 modelos distintos. Por esto, se utilizará cómputo paralelizado para acelerar el proceso.
Resultado del ajuste de los hiperparámetros:
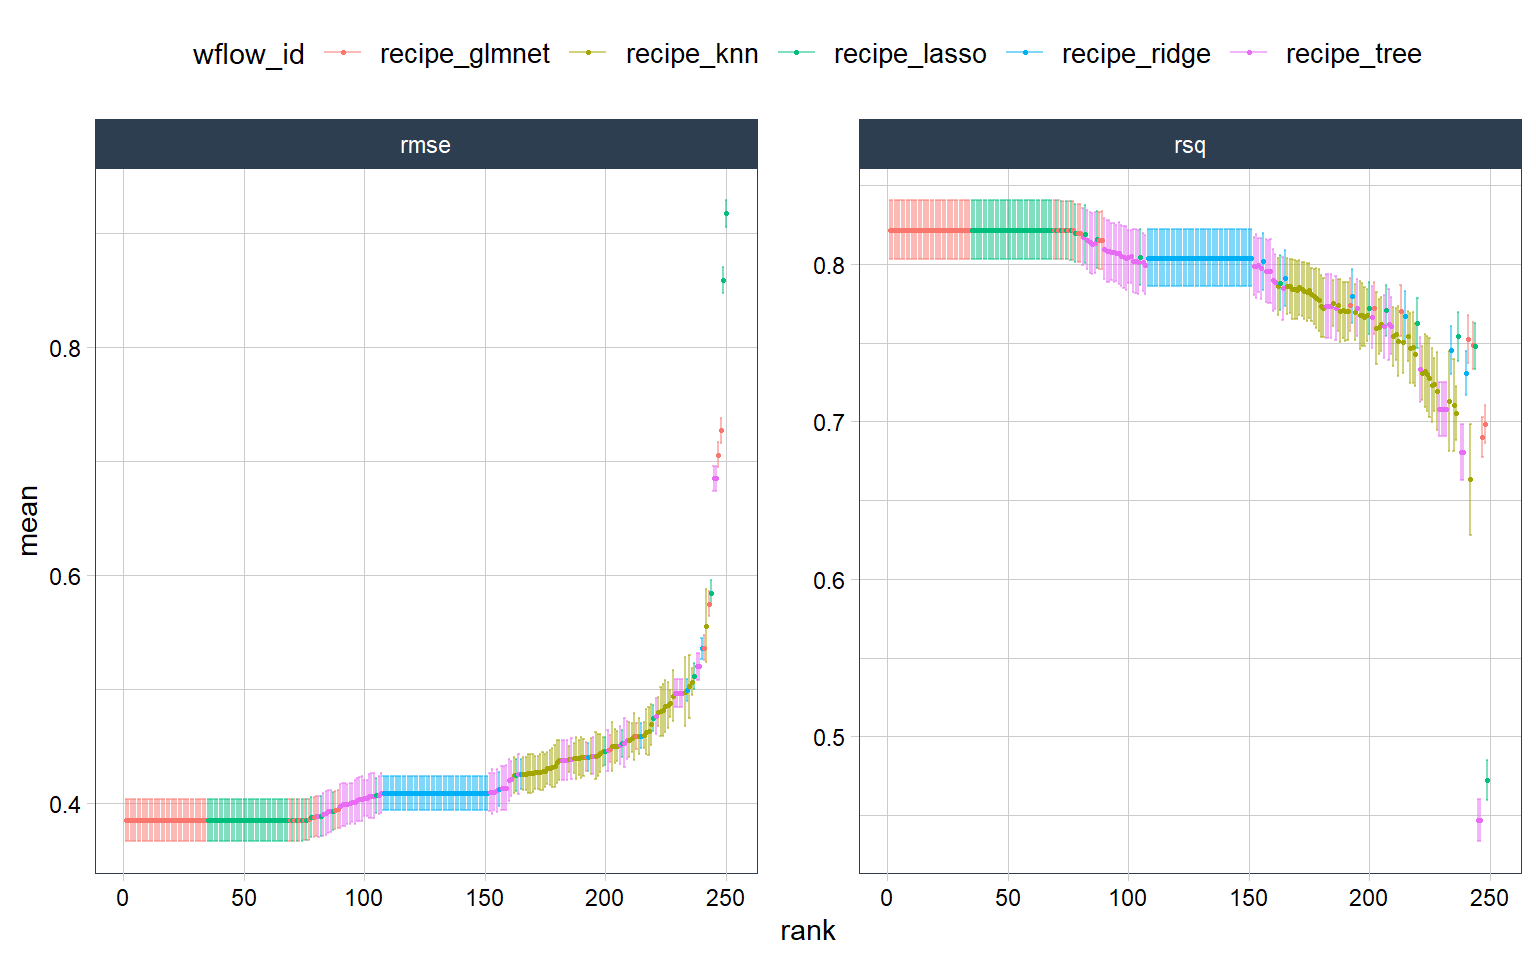
Se puede observar que el modelo de regresión elástica disminuye la raíz del error cuadrático medio y maximiza el coeficiente de determinación, por lo tanto, es el mejor modelo de todos los ajustes. Empleado las funciones extract_workflow_set_result y select_best se puede extraer la mejor combinación de hiperparámetros.
extract_workflow_set_result(
  x = grid_results,
  id = "recipe_glmnet") %>%
  select_best(metric = "rmse") %>%
  select(-.config) %>%
gt::gt(caption = "Mejor Combinación de Hiperparámetros")| penalty | mixture |
|---|---|
| 2.314584e-07 | 0.08361681 |
Validación en conjunto de prueba
Por ultimó, solo queda finalizar el mejor modelo con la mejor combinación de hiperparámetros y emplear dicho modelo para predecir el conjunto de prueba y verificar el rendimiento del modelo en datos nunca antes vistos.
best_results <-
  grid_results %>%
  extract_workflow_set_result("recipe_glmnet") %>%
  select_best(metric = "rmse")

final_model <-
  grid_results %>%
  extract_workflow("recipe_glmnet") %>%
  finalize_workflow(best_results) %>%
last_fit(split = split)collect_metrics(x = final_model) %>%
select(-all_of(c(".config", ".estimator"))) %>%
mutate_at(vars(.estimate), ~ round(., 3)) %>%
gt::gt(caption = "Métricas") %>%
gt::cols_label(.metric = "Métricas", .estimate = "Valor")| Métricas | Valor |
|---|---|
| rmse | 0.379 |
| rsq | 0.834 |
La forma más sencilla de evaluar visualmente la concordancia entre los valores observados y los predichos es con un gráfico de dispersión.
final_model %>%
  collect_predictions() %>%
  ggplot(aes(x = charges, y = .pred)) +
  geom_abline(color = "firebrick", lty = 2) +
  geom_point(alpha = 1/3, color = "midnightblue") +
  coord_obs_pred() +
  labs(x = "Observado", y = "Predicho", title = "Valores Predecidos vs Observados") +
  tidyquant::theme_tq()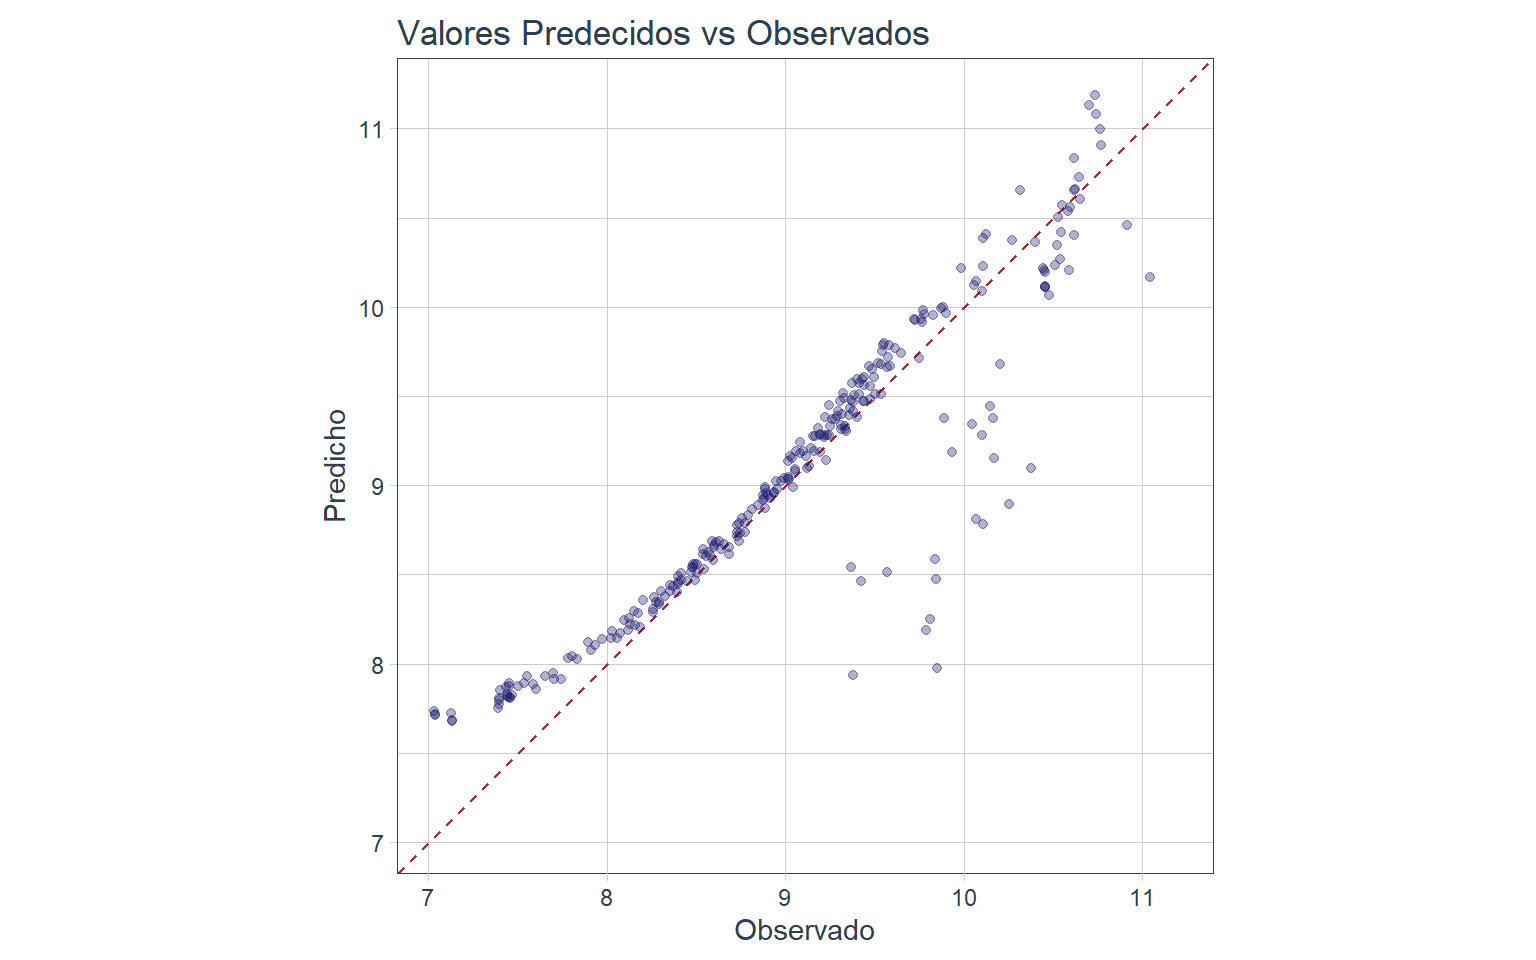
Se puede observar que se obtuvo un modelo bastante decente empleando los métodos de regularización en modelos de regresión multivariante. Además, es importante destacar que dicha metodología supero ampliamente a modelos de arboles de decisión y k vecinos.